
softify.pro - Insiders
Un magazzino. Una verità.
C'è un modo semplice per far sembrare convincente un software di magazzino.
Aprire una dashboard.
Mostrare qualche numero verde.
Aggiungere un grafico.
Mettere delle scorte su una mappa del magazzino.
Concludere con un report.
Tutto sembra a posto.
E tutto può comunque essere sbagliato.
Perché a un magazzino non interessa quanto sia bella la dashboard.
Gli interessa se ogni parte del sistema concorda su ciò che è realmente accaduto.
Questa è diventata la parte interessante dell'ultimo esperimento softify.pro Flow.
Non un'altra schermata.
Non un altro KPI.
Non un altro report.
Qualcosa di molto meno visibile.
…
Un magazzino. Una verità.
C'è un modo semplice per far sembrare convincente un software di magazzino.
Aprire una dashboard.
Mostrare qualche numero verde.
Aggiungere un grafico.
Mettere delle scorte su una mappa del magazzino.
Concludere con un report.
Tutto sembra a posto.
E tutto può comunque essere sbagliato.
Perché a un magazzino non interessa quanto sia bella la dashboard.
Gli interessa se ogni parte del sistema concorda su ciò che è realmente accaduto.
Questa è diventata la parte interessante dell'ultimo esperimento softify.pro Flow.
Non un'altra schermata.
Non un altro KPI.
Non un altro report.
Qualcosa di molto meno visibile.
Coerenza.
È iniziato con un magazzino.
L'attuale demo di softify.pro Flow lavora con diversi ambienti di magazzino sintetici.
ID di magazzino diversi.
Capacità diverse.
Strutture di zona diverse.
Nessun inventario di produzione.
Nessun dato cliente.
Nessuna informazione operativa reale.
Ma la logica di processo si comporta come se tutto ciò contasse.
Perché nella logistica reale, conta.
Una volta selezionato un magazzino, quel contesto diventa parte di tutto ciò che segue.
Flow.
SSCC.
Movimentazioni.
Operatori.
Analytics.
Report.
Sembra ovvio.
Diventa notevolmente meno ovvio quando lo stesso processo inizia a comparire in diverse parti dell'applicazione.
Poi abbiamo aperto un'altra vista.
Operational Analytics.
Improvvisamente il magazzino sembrava completamente diverso.
Nessuna posizione di stoccaggio.
Nessuna freccia di movimento.
Invece:
- Flow completati,
- ordini attivi,
- utilizzo del magazzino,
- eccezioni,
- ricevimento merci,
- spedizioni,
- tempo di elaborazione.
La rappresentazione visiva era cambiata.
Il magazzino no.
Quella distinzione è diventata importante.
Perché sotto i KPI c'erano ancora record individuali.
ID Flow.
SSCC.
Zone.
Stati.
Operatori.
Tempi di elaborazione.
Vista diversa.
Stessa realtà operativa.
Fin qui tutto bene.
Operational Analytics — stato aggregato del magazzino, con i record Flow sottostanti ancora visibili.
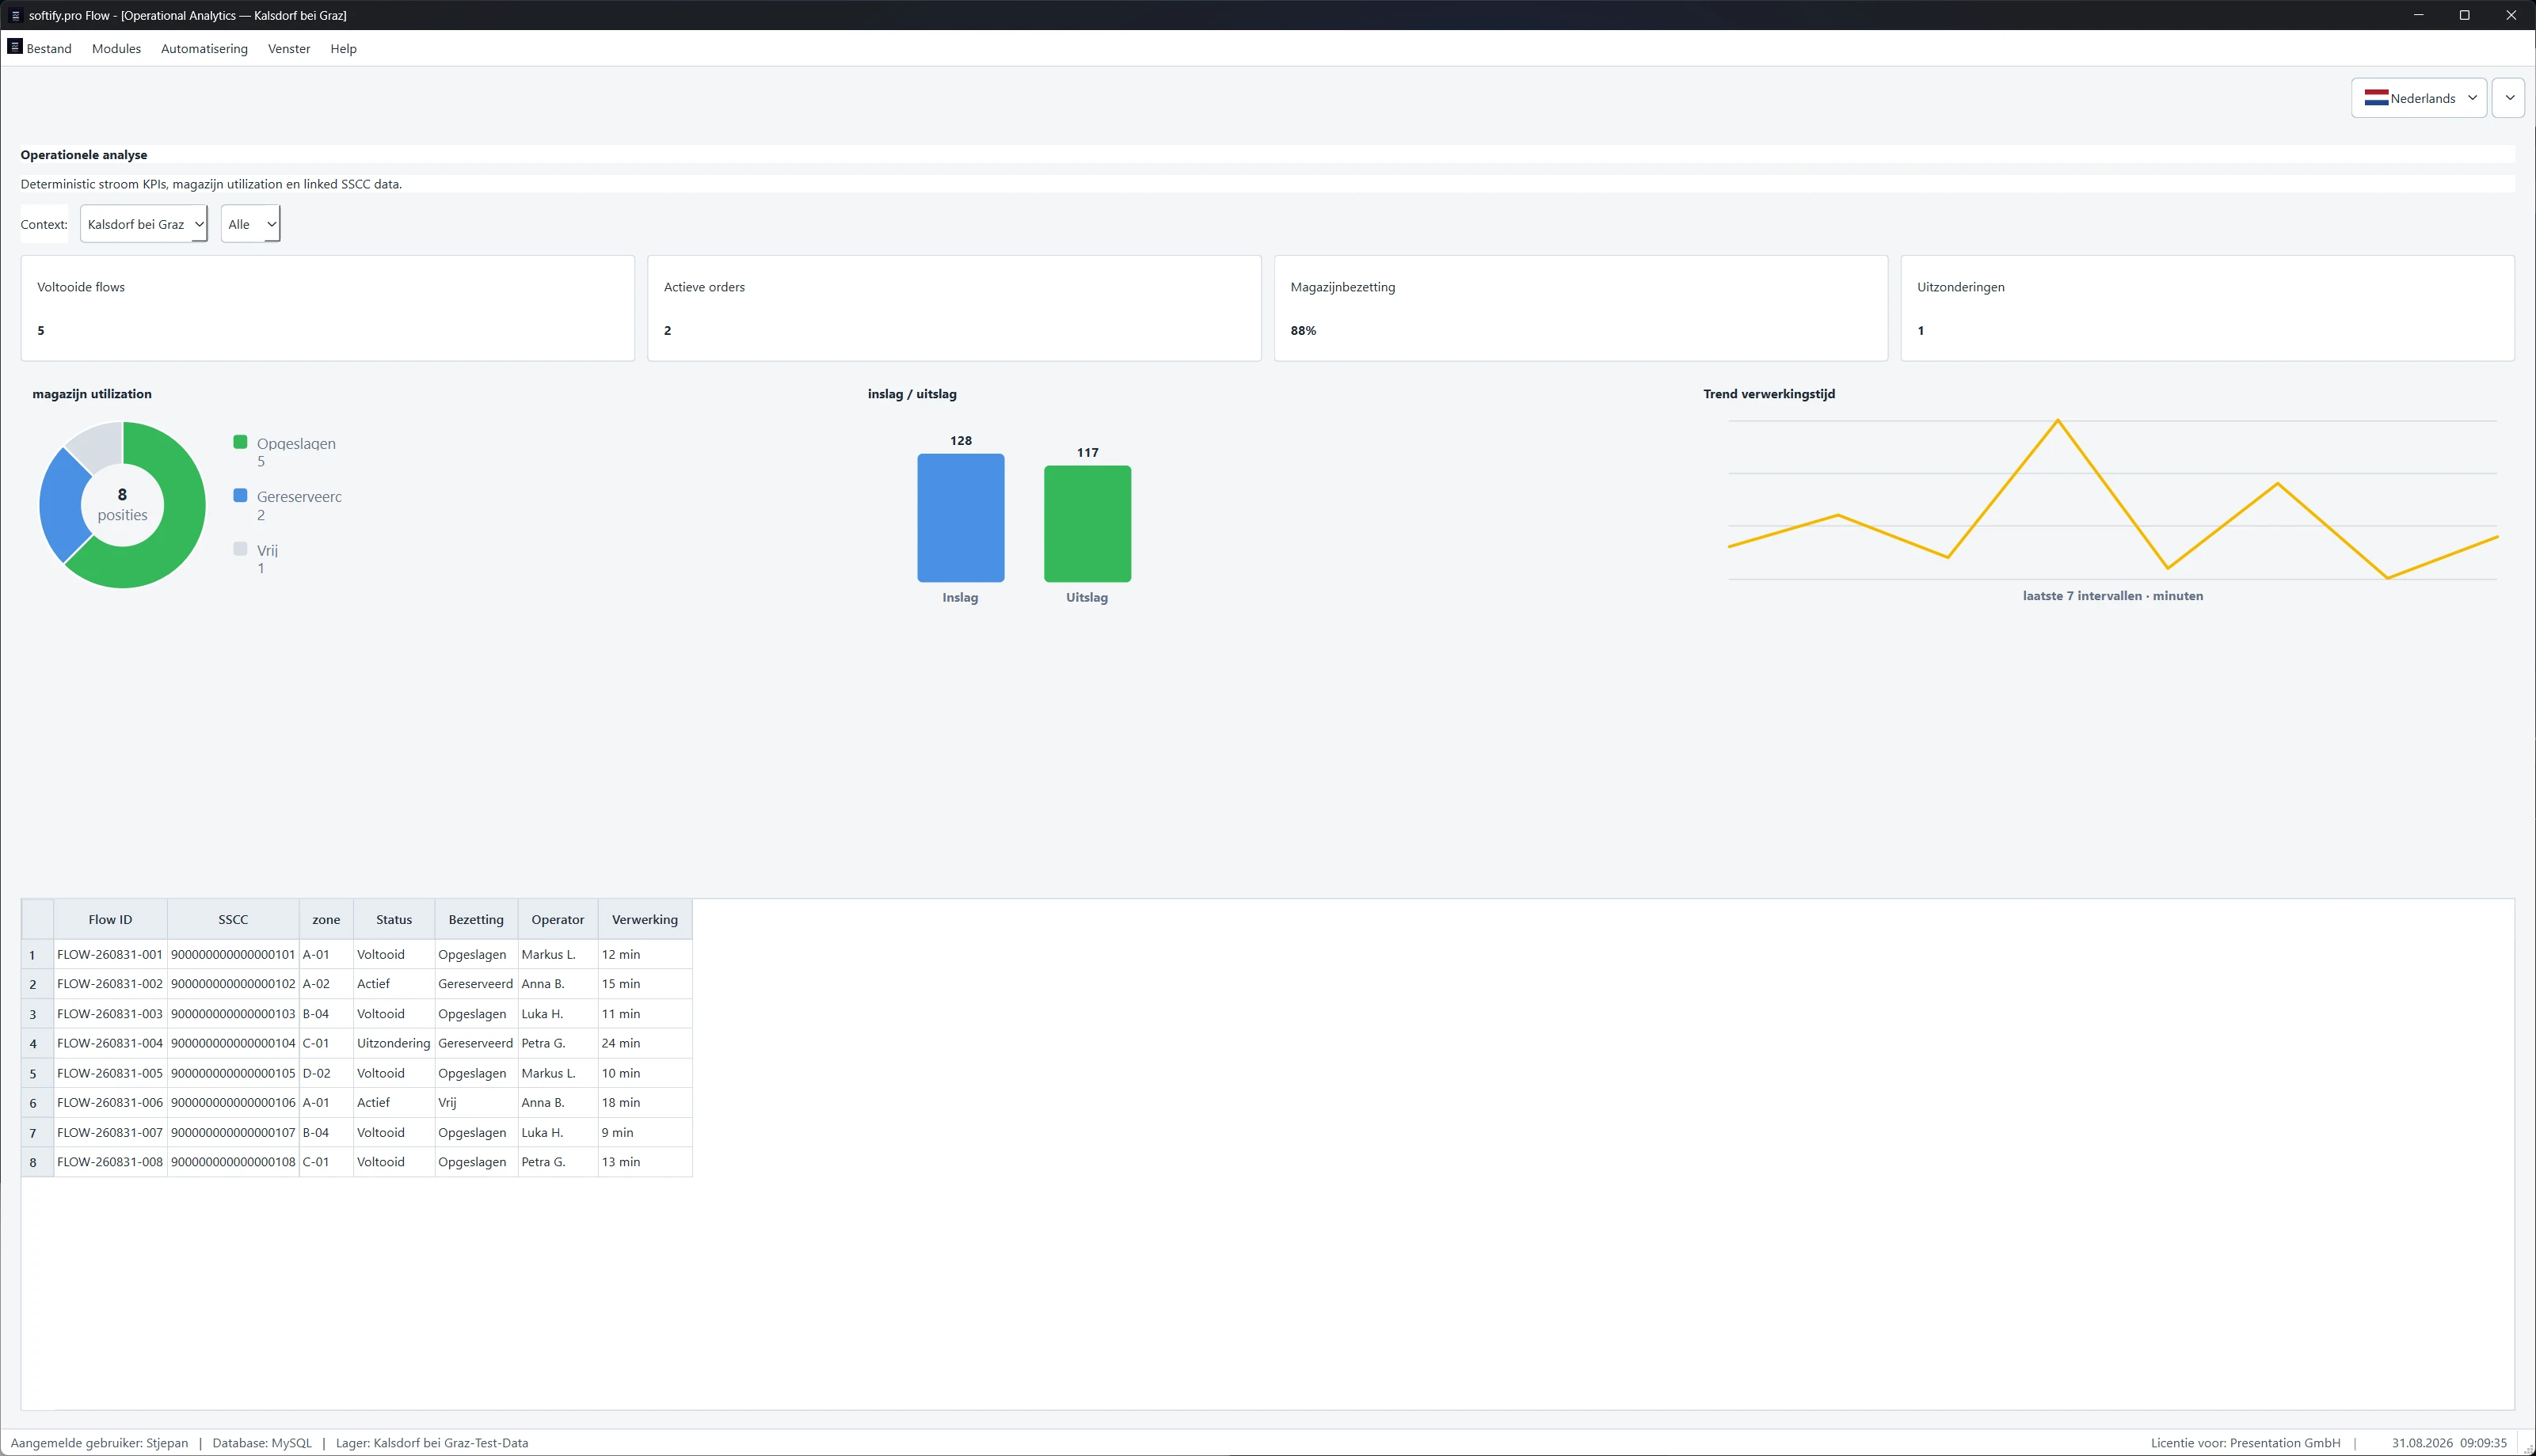
L'88% è utile solo se il sistema riesce a spiegarlo.
Supponiamo che la dashboard dica:
Utilizzo del magazzino: 88%.
Utile.
Ma incompleto.
Alcune posizioni sono occupate.
Alcune sono riservate.
Alcune rimangono libere.
Questi stati non sono intercambiabili.
Il numero diventa affidabile solo se il sistema riesce ancora a spiegare da dove viene.
Cinque Flow completati?
Mostrali.
Due ordini attivi?
Mostrali.
Un'eccezione?
Quale?
88% di utilizzo?
Cosa è occupato?
Cosa è riservato?
Cosa rimane libero?
Una dashboard dovrebbe riassumere la realtà.
Non dovrebbe sostituirla.
Poi abbiamo cambiato la lingua.
Olandese.
Il magazzino è rimasto lo stesso.
Gli ID Flow sono rimasti gli stessi.
Gli SSCC sono rimasti gli stessi.
Gli operatori sono rimasti collegati ai loro record.
È cambiata solo la lingua.
In seguito lo stesso stato operativo è apparso in croato.
Poi in francese.
È qui che il software multilingue diventa molto più interessante dei pulsanti tradotti.
Una cattiva traduzione si nota facilmente.
Un cambio di stato causato dal cambio di lingua è molto più pericoloso.
Immaginate di passare dal tedesco al francese e perdere silenziosamente il Flow selezionato.
O di ricostruire un filtro sul magazzino sbagliato.
O di mostrare l'SSCC corretto nel contesto di processo sbagliato.
L'interfaccia potrebbe comunque sembrare perfetta.
Il sistema non lo sarebbe.
Flow segue quindi una regola semplice:
La lingua può cambiare le parole. Non può cambiare la verità.
Poi il Flow ha acquisito una storia.
Browse & Drill-down non si sforza particolarmente di sembrare impressionante.
Forse è proprio per questo che è utile.
Seleziona un Flow.
Compare il suo contesto.
Magazzino.
Zona.
Stato.
Operatore.
SSCC.
E poi la catena documentale.
ASN.
Ricevimento merci.
Movimentazione di magazzino.
Ordine di prelievo.
Prelievo.
Spedizione.
FLOW.
Sette passaggi.
Il processo non è più solo uno stato attuale.
Ha un passato.
E questo cambia la domanda.
Invece di:
Cosa sta succedendo?
possiamo chiedere:
Come siamo arrivati qui?
È una domanda molto migliore quando qualcosa alla fine va storto.
Un Flow, un SSCC, una catena documentale — dall'ASN al completamento.
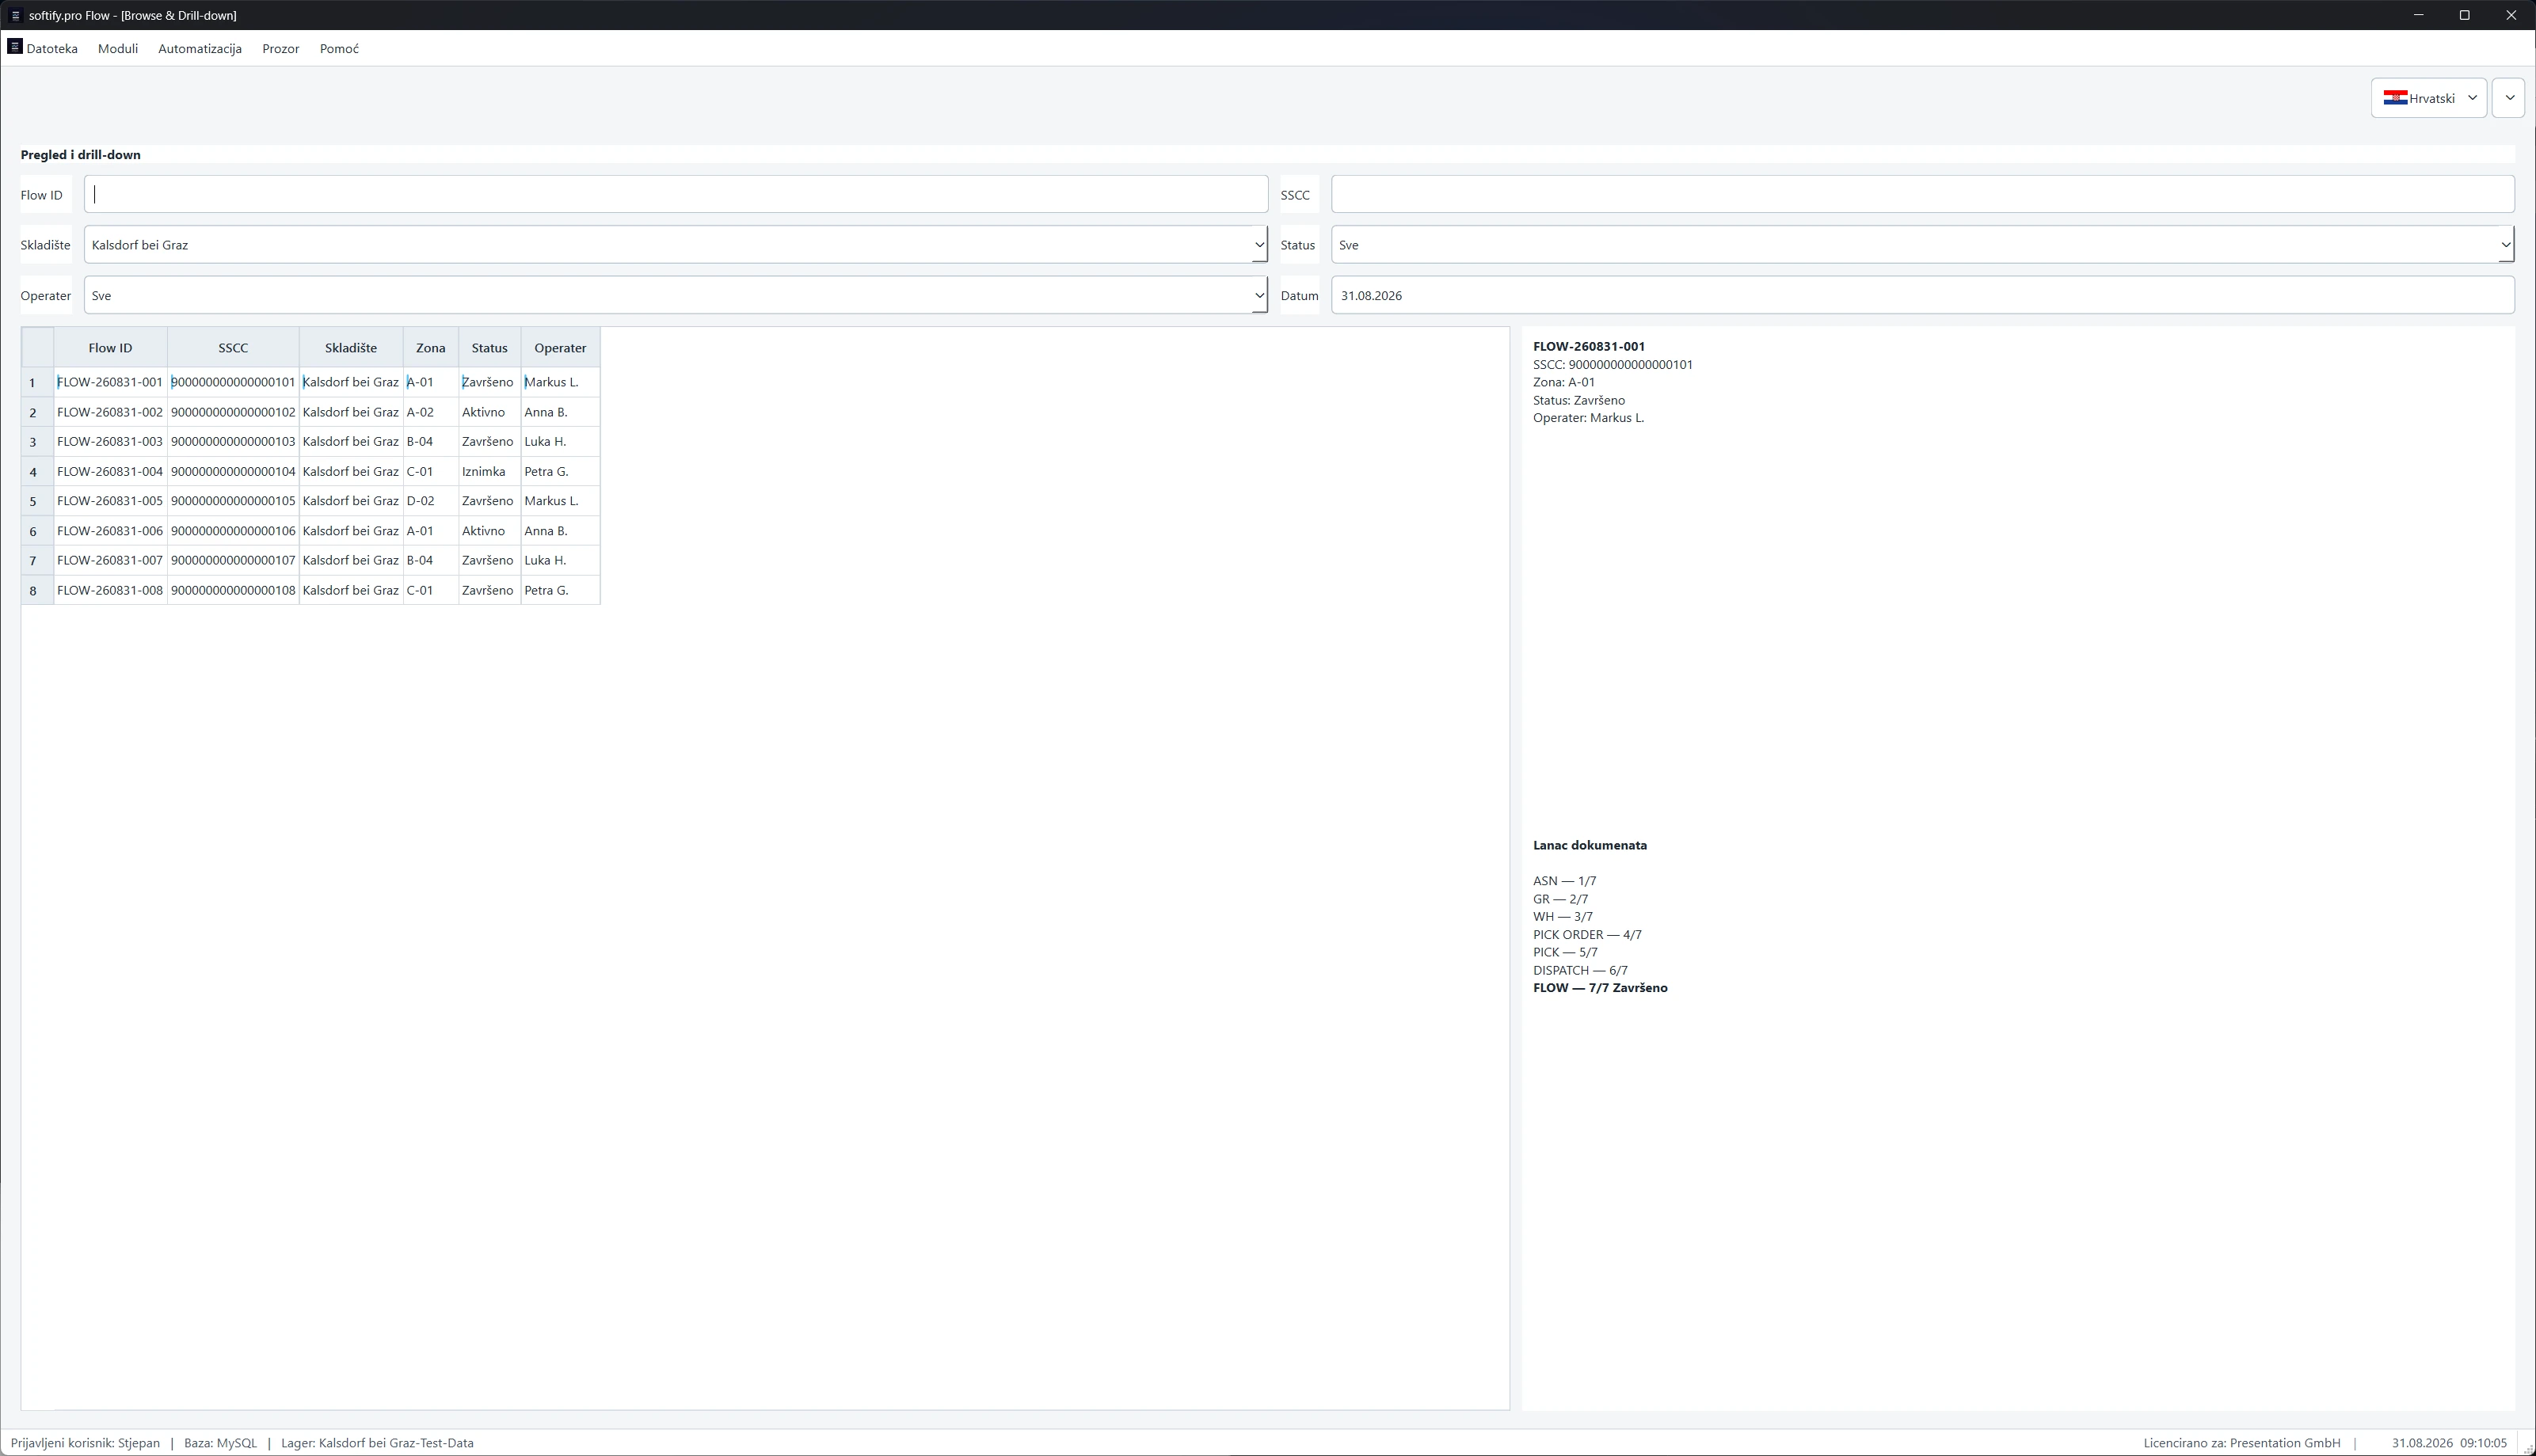
L'SSCC diventa il filo conduttore.
Inizialmente, un SSCC sembra quello che è.
Un identificativo.
Un numero lungo in una tabella.
Ma attraverso Flow diventa qualcosa di più utile.
Un filo conduttore attraverso il processo.
Seguendolo, altre cose iniziano a collegarsi.
Un magazzino.
Un Flow.
Una zona.
Uno stato.
Un operatore.
Una catena documentale.
Infine un report.
Lo stesso oggetto logistico fisico è ora visibile da diverse parti dell'applicazione.
Utile.
Anche pericoloso.
Perché ogni vista aggiuntiva crea un'altra opportunità per il sistema di raccontare una storia diversa.
Ed è qui che le cose diventano interessanti.
Supponiamo che Analytics dica che il Flow è attivo.
Il Drill-down dice che l'SSCC appartiene a quel Flow.
La catena documentale dice che l'operazione è progredita ulteriormente.
Il report dice qualcos'altro.
Quale è corretto?
Non è un problema specifico di Flow.
È uno dei problemi più antichi del software aziendale.
Parti diverse dello stesso sistema sviluppano gradualmente la propria versione della realtà.
Una schermata legge lo stato transazionale.
Un'altra legge un aggregato.
Un'altra si affida a dati in cache.
Un report calcola qualcosa in modo leggermente diverso.
Un'eccezione viene risolta operativamente ma scompare dal reporting.
Ogni componente funziona.
L'intero sistema mente.
Di solito educatamente.
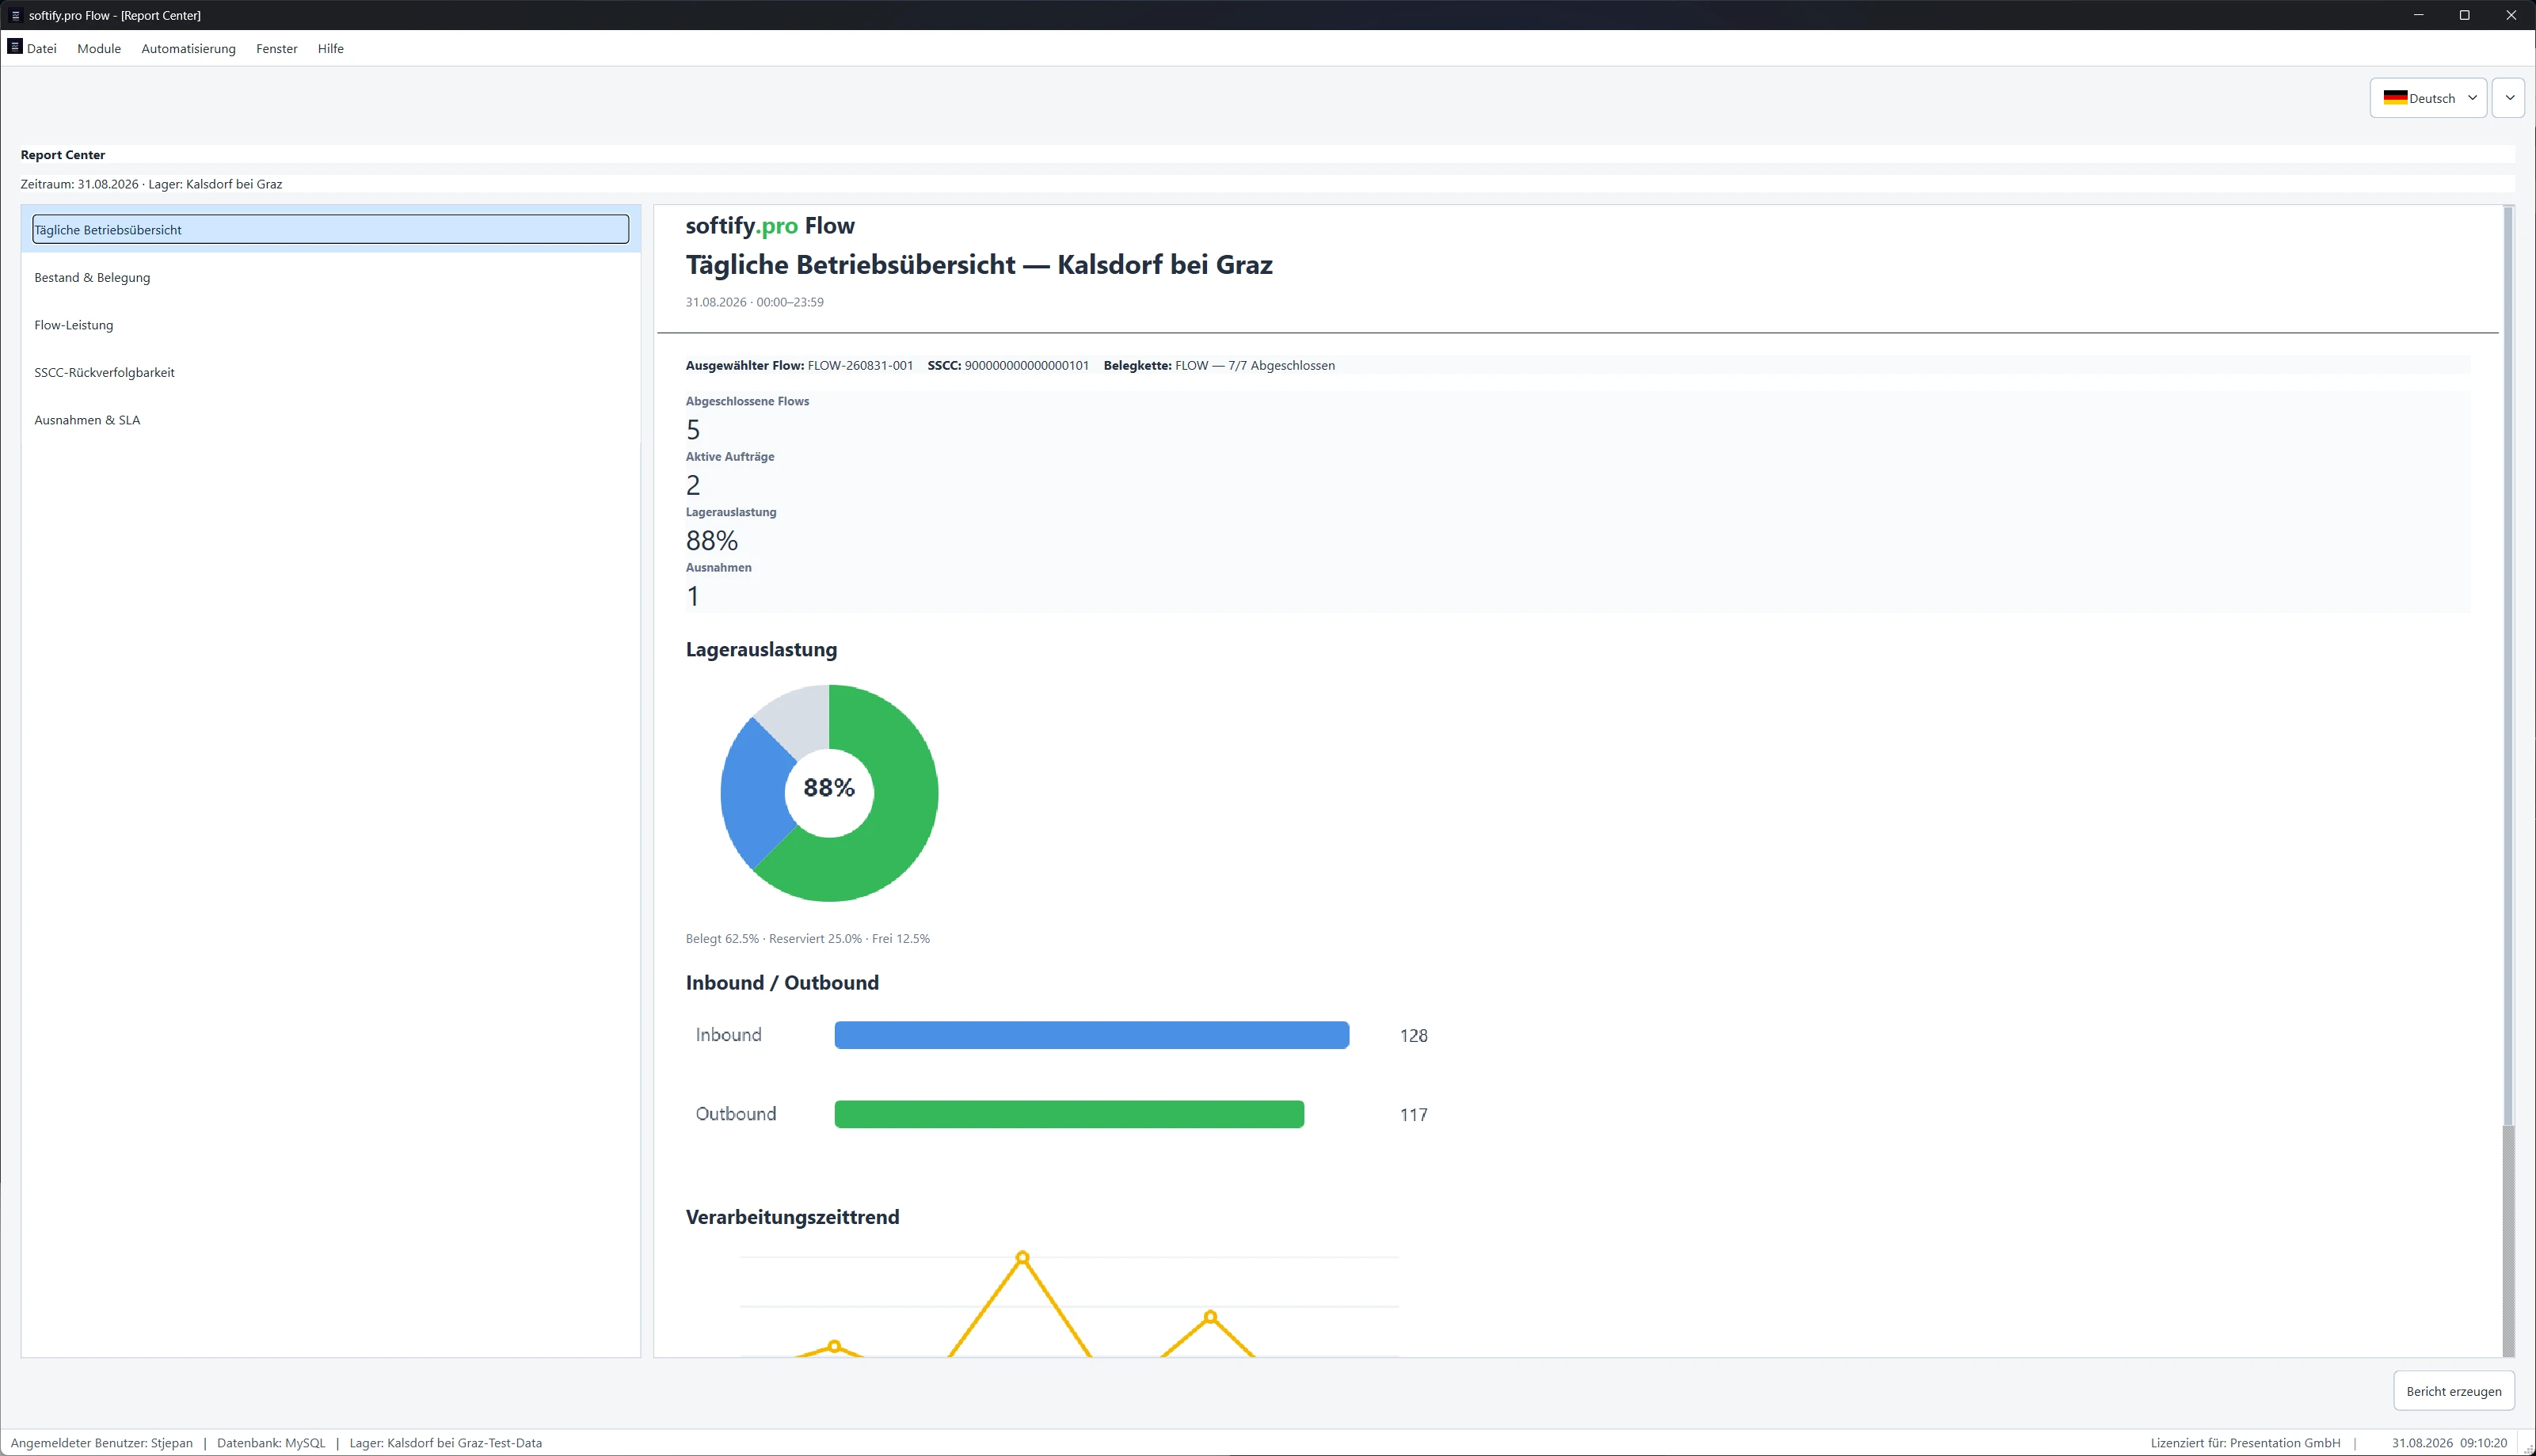
Così abbiamo aperto il Report Center.
Panoramica operativa giornaliera.
Scorte e occupazione.
Performance dei Flow.
Tracciabilità SSCC.
Eccezioni e SLA.
La stessa storia operativa è riapparsa.
Flow completati.
Ordini attivi.
Utilizzo del magazzino.
Eccezioni.
Ricevimento merci.
Spedizioni.
Tempo di elaborazione.
Ma questa volta la domanda non era se il report sembrasse corretto.
La domanda era:
Può difendersi da solo?
Un buon report ti dà un numero.
Un sistema migliore può spiegare da dove viene quel numero.
Reporting dallo stesso stato operativo — non una seconda versione della realtà.
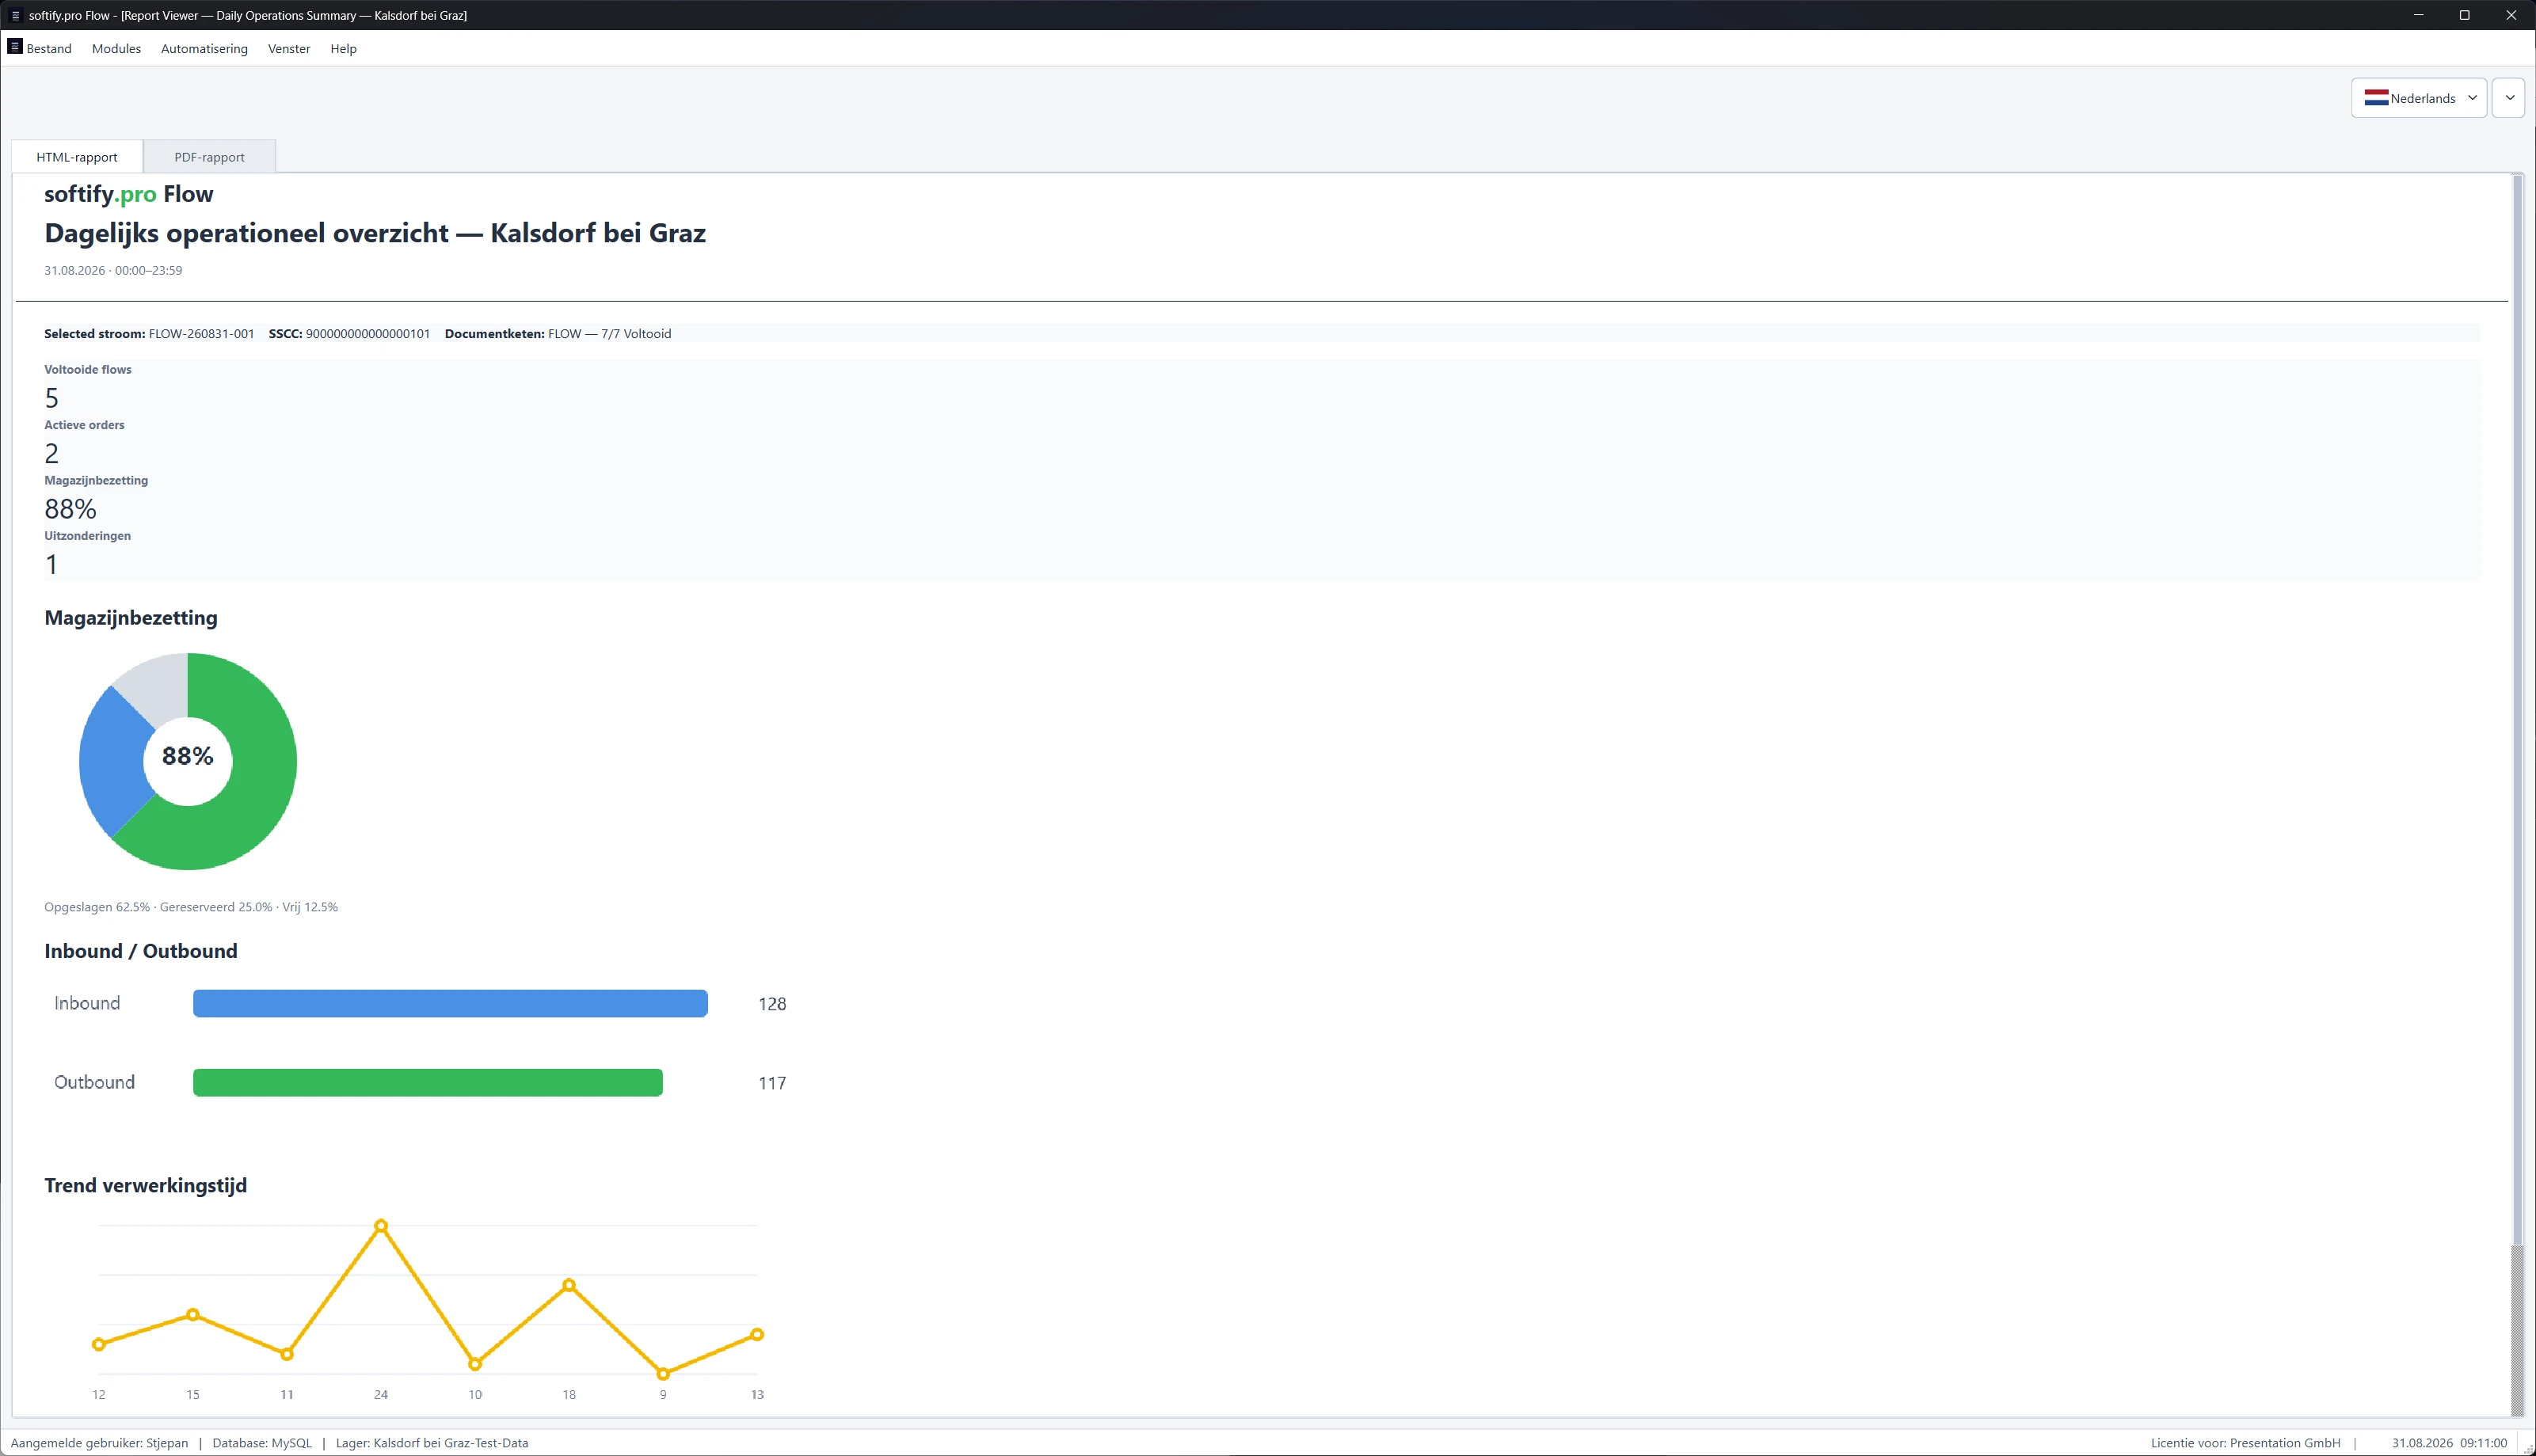
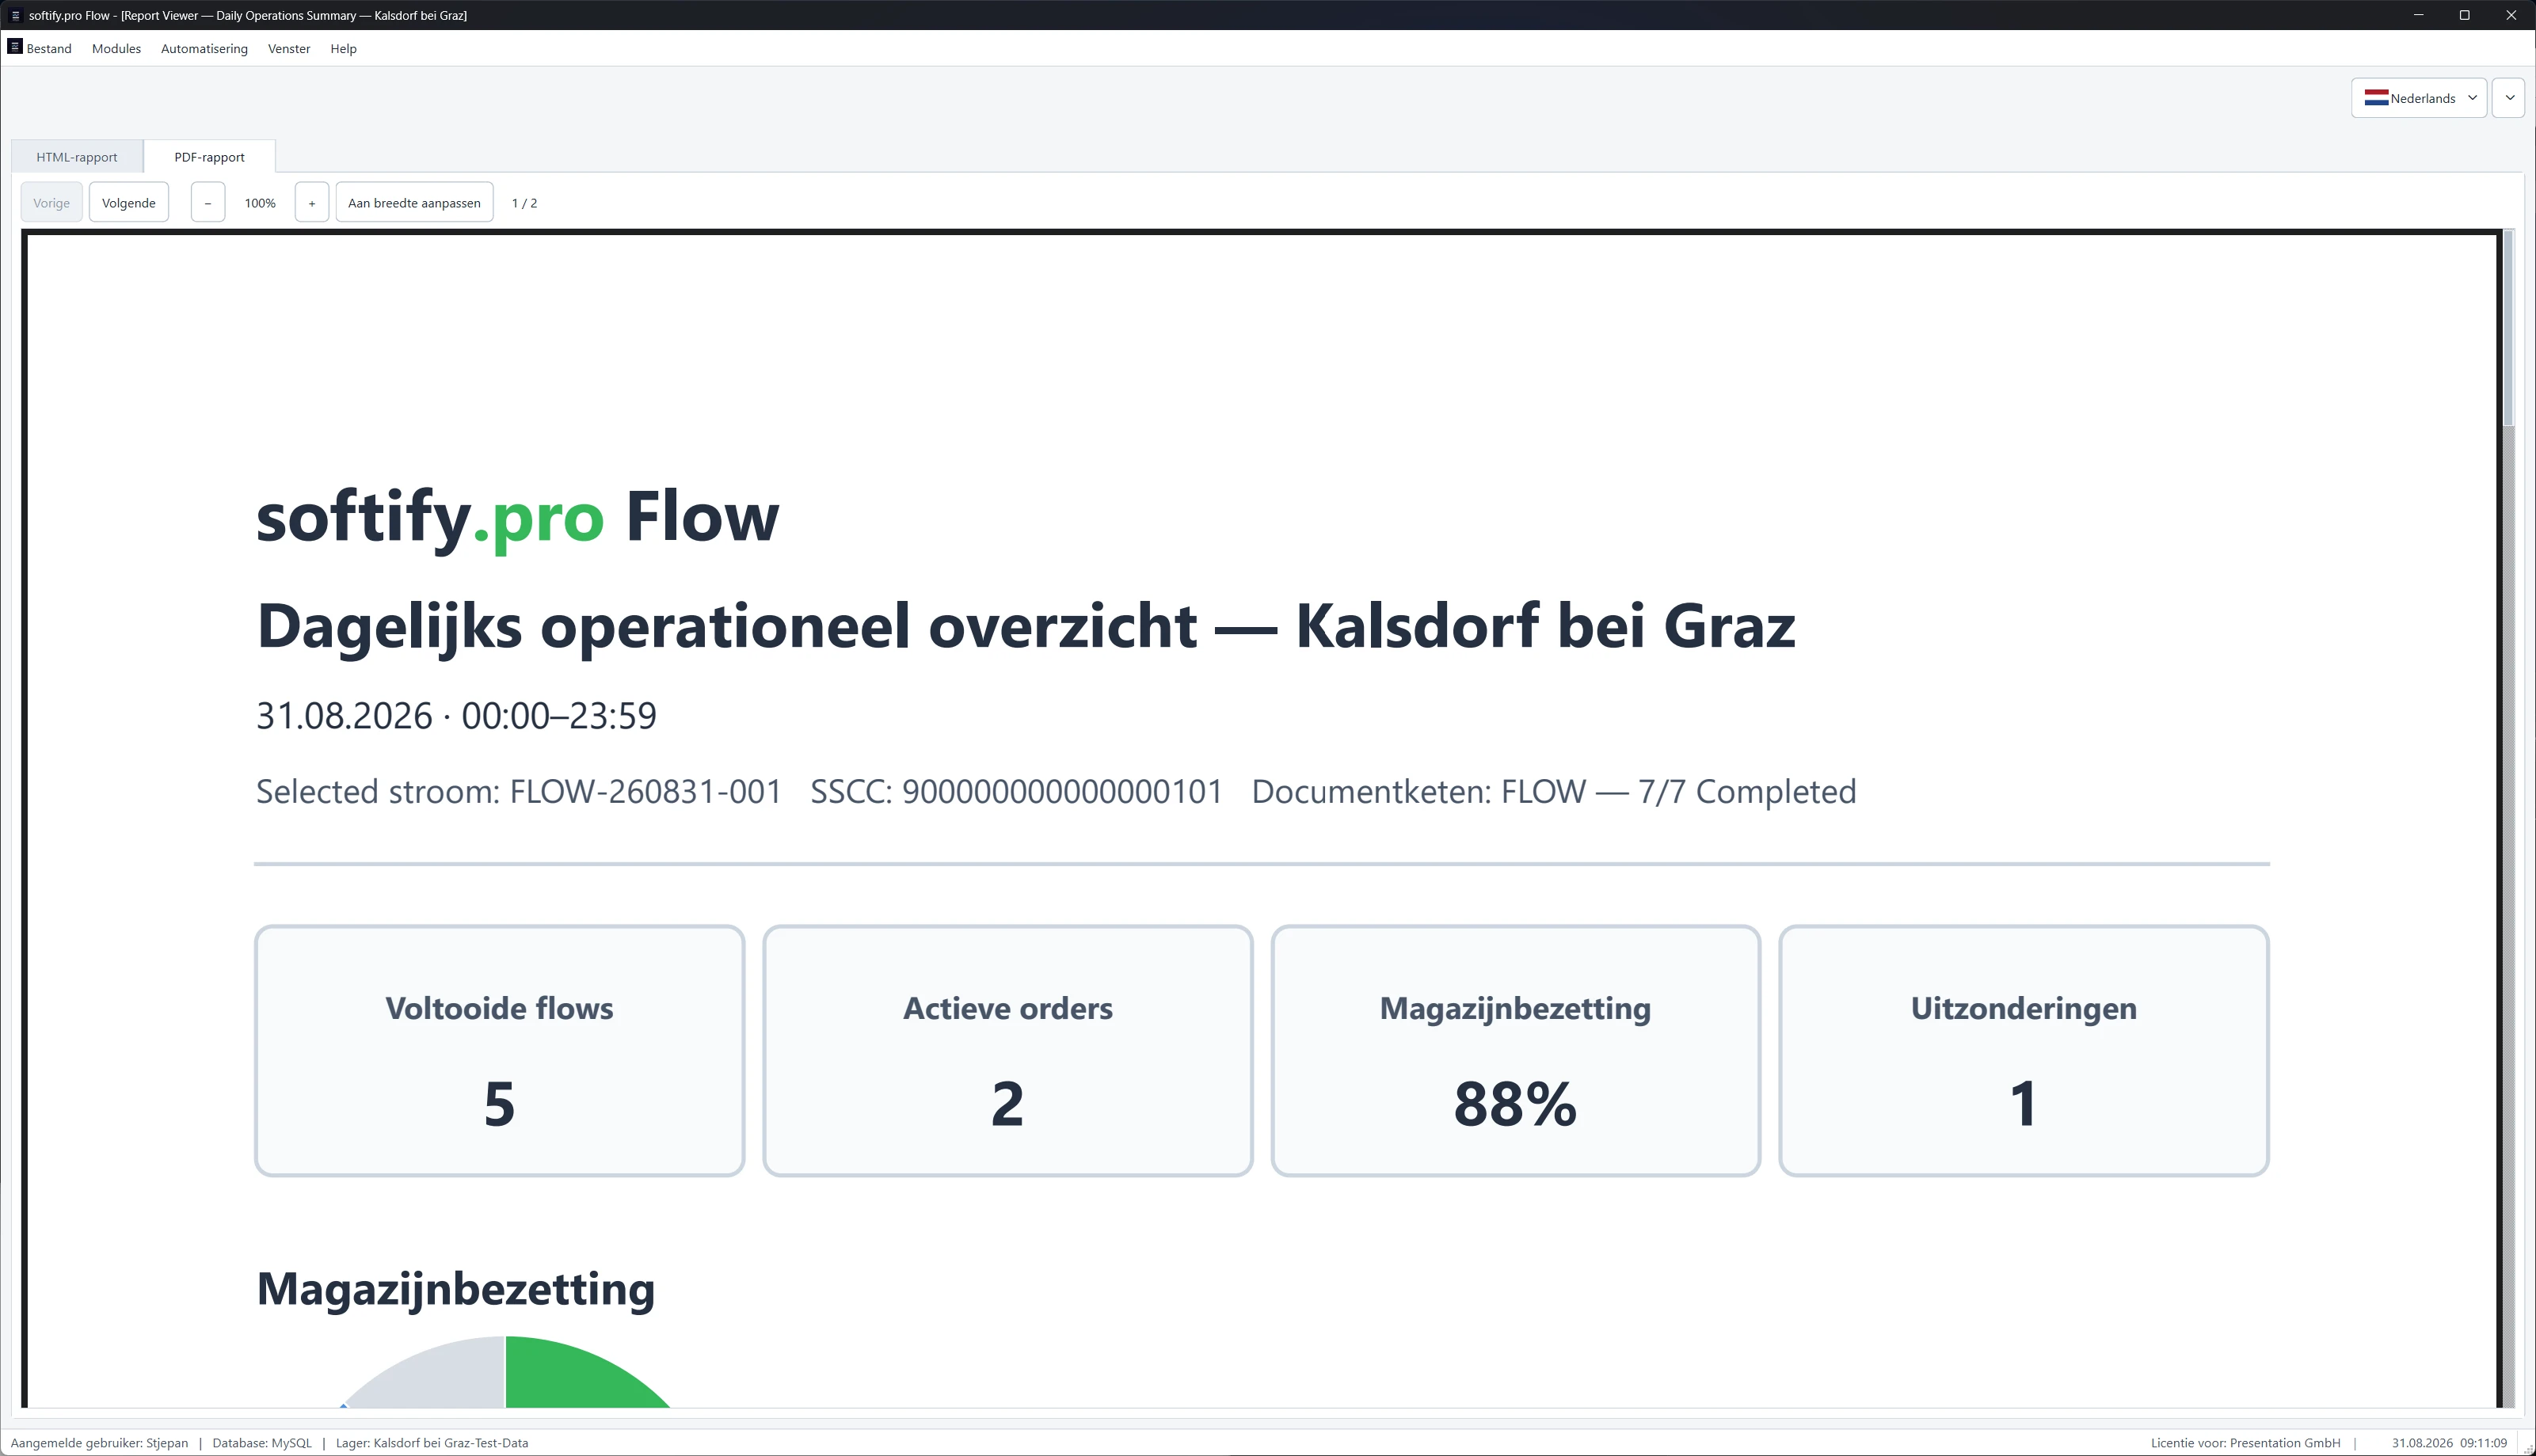
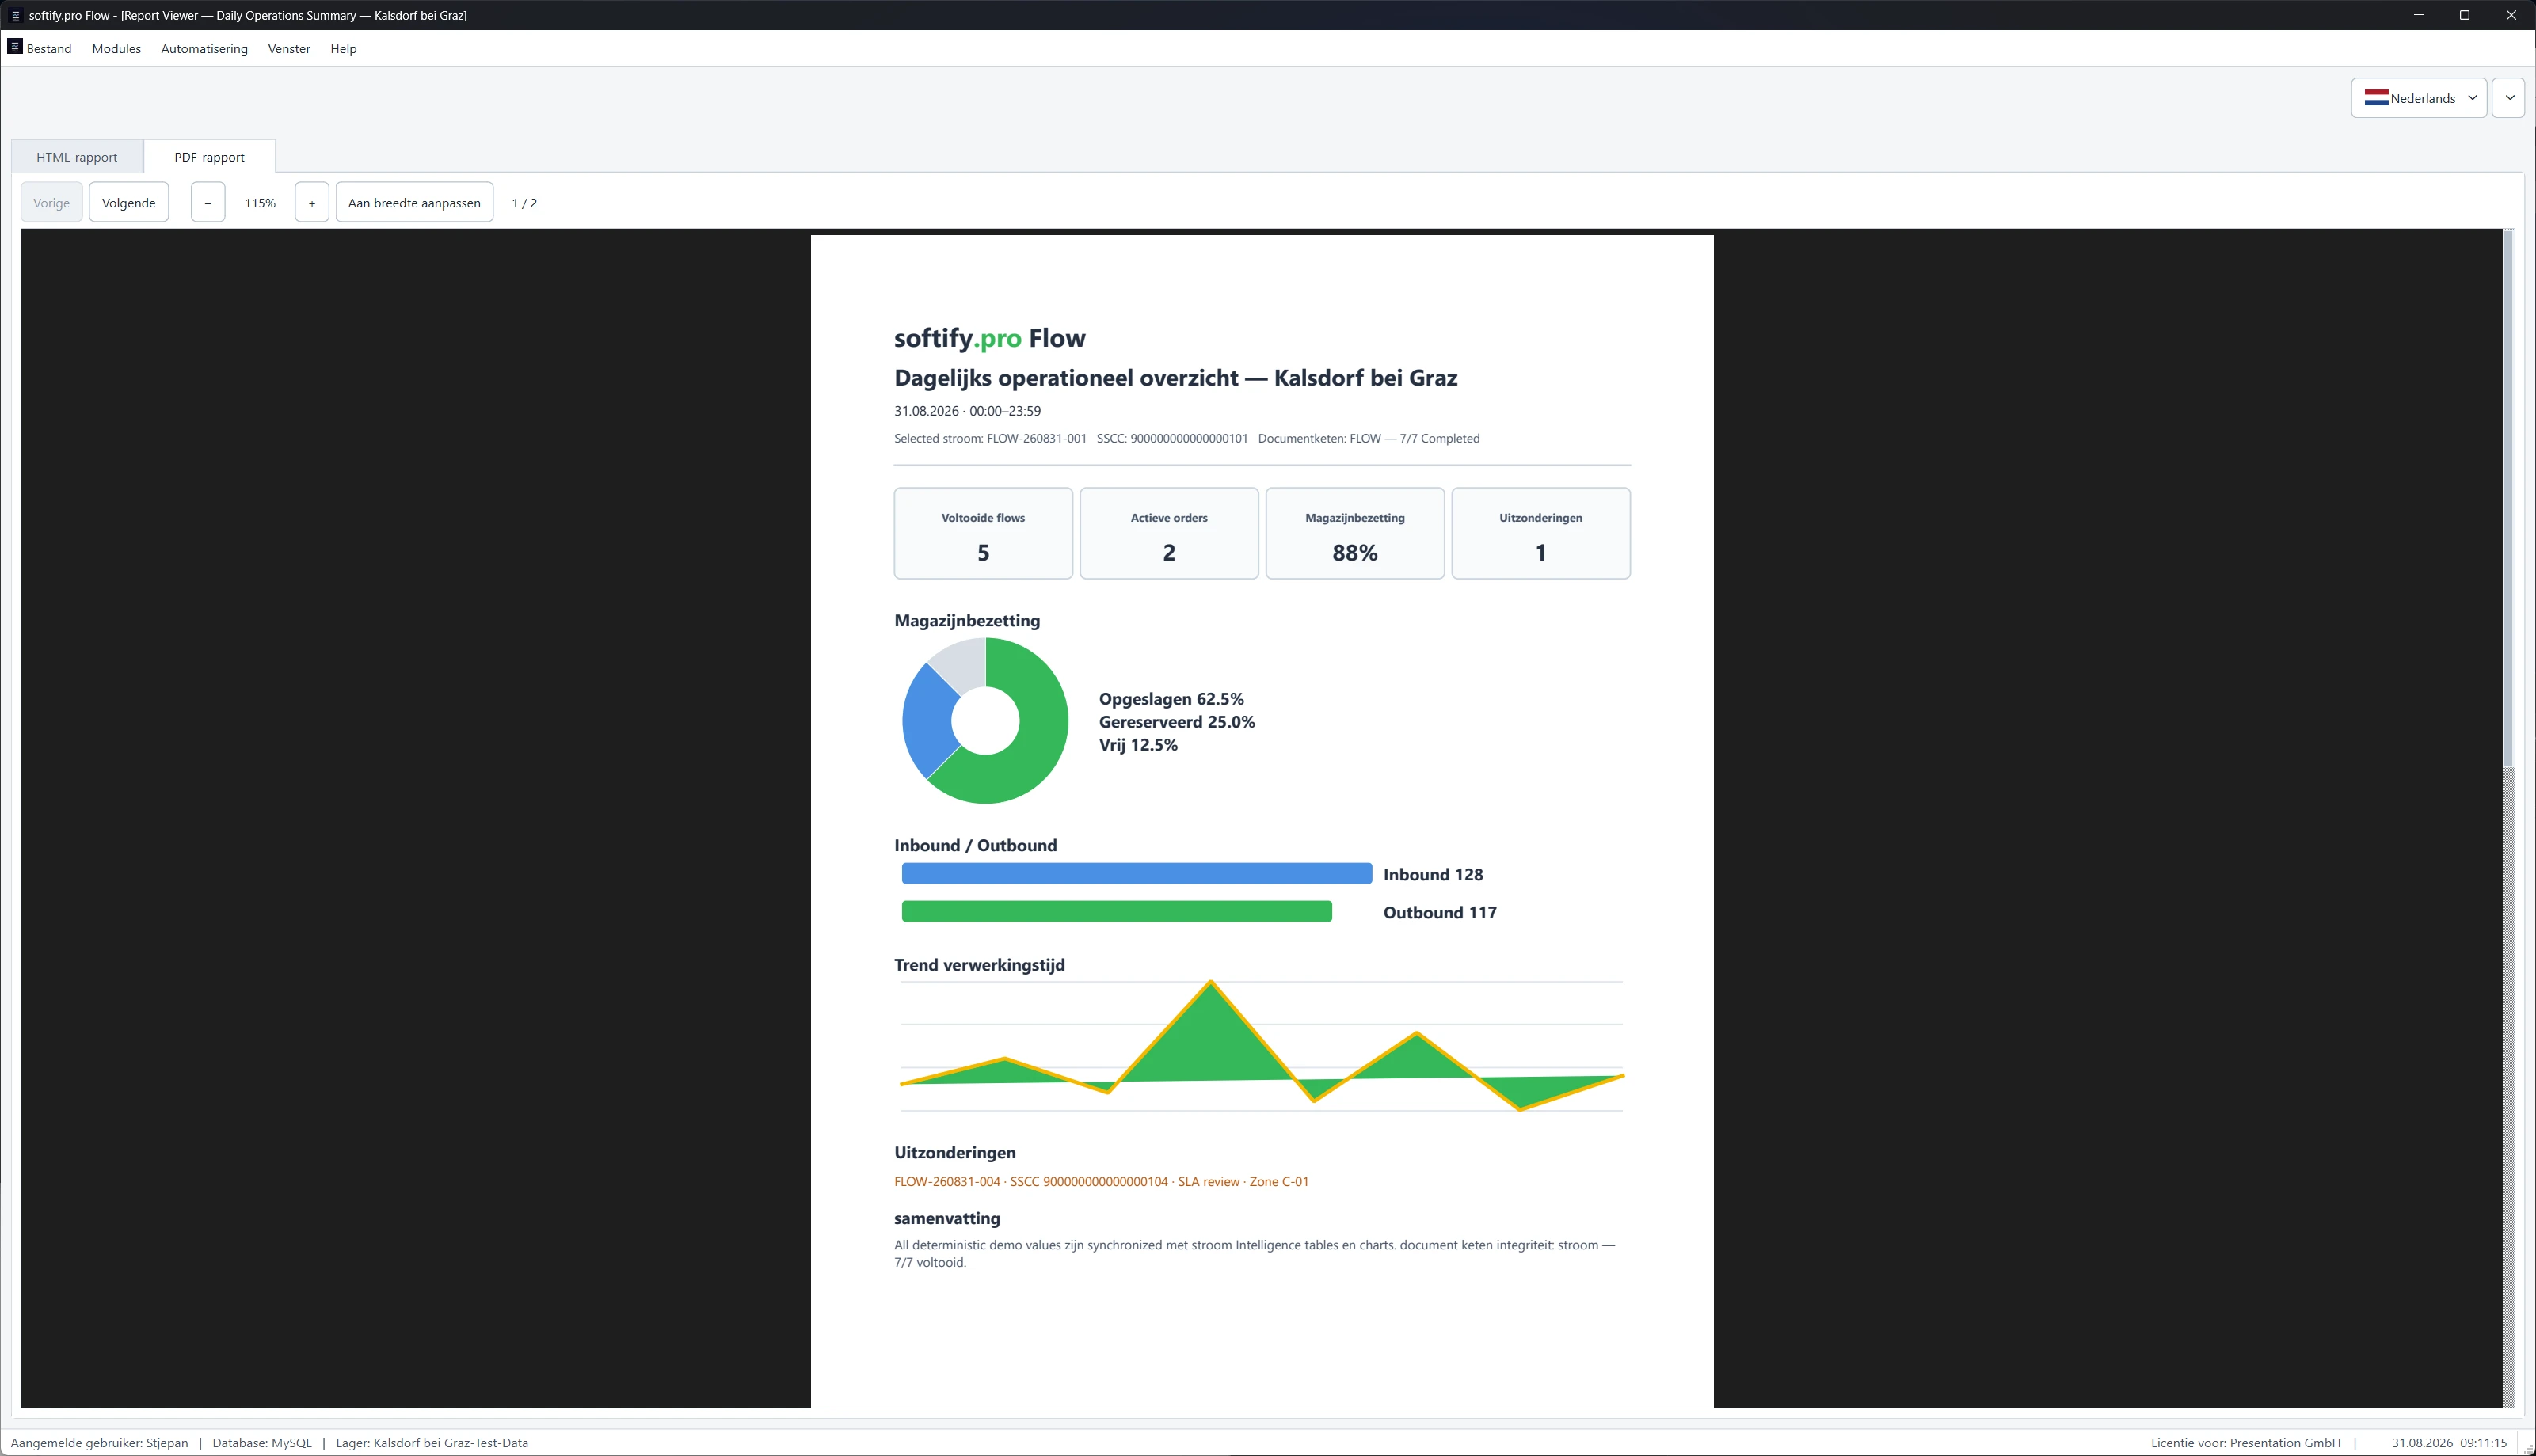
L'eccezione era ancora lì.
Uno dei dettagli più silenziosi si è rivelato uno dei più importanti.
I dati demo contengono un'eccezione.
Appare in Analytics.
Appare nel Drill-down.
Appare nella tracciabilità SSCC.
Appare nel Report Center.
E rimane visibile in Exceptions & SLA.
È esattamente ciò che dovrebbe accadere.
Riprendersi operativamente da un'eccezione non significa che l'eccezione debba scomparire dalla storia.
"Il processo è continuato" e "non è successo nulla" non sono la stessa affermazione.
Nella logistica, quella differenza conta.
A questo punto avevamo un problema di test.
Non un problema software.
Un problema di test.
Ora avevamo lo stesso magazzino rappresentato come:
- analytics,
- Flow individuali,
- cronologie SSCC,
- catene documentali,
- report,
- e viste delle eccezioni.
Ognuno poteva essere testato indipendentemente.
Aprire.
Cliccare.
Filtrare.
Verificare.
Superare.
Avanti.
Sarebbe stato facile.
Avrebbe anche perso la parte interessante.
Perché sei spunte verdi non dimostrano che sei viste concordino tra loro.
Entra in scena COCO.
Di nuovo.
COCO aveva già avuto a che fare con Flow in precedenza.
Autenticazione.
Utenti.
Ruoli.
Ambienti di database.
Lingue.
Esecuzione desktop.
Poi è arrivata la logistica.
Magazzini.
Inventario.
Prelievo.
Movimentazioni.
Eccezioni.
Documenti.
Ubuntu.
Red Hat Enterprise Linux.
Questa volta abbiamo dato a COCO qualcosa di leggermente diverso.
Non una schermata da verificare.
Una storia da seguire.
Prendi questo magazzino.
Prendi questo Flow.
Prendi questo SSCC.
Apri Analytics.
Apri Drill-down.
Cambia la lingua.
Guarda di nuovo.
Apri il report.
Trova lo stesso Flow.
Trova lo stesso SSCC.
Trova l'eccezione.
Confronta.
Poi confronta di nuovo.
COCO segue lo stesso contesto operativo attraverso softify.pro Flow — analytics, tracciabilità, cambi di lingua e reporting.
Questo cambia la natura del test.
La domanda non è più:
- Ogni modulo funziona?
Diventa:
- Tutti i moduli credono che sia accaduta la stessa cosa?
Una domanda molto migliore.
Molto meno comoda.
Un sistema di magazzino dovrebbe avere un'unica memoria.
Gli operatori possono vedere le posizioni.
I responsabili di magazzino possono vedere i KPI.
Il supporto può usare il drill-down.
Gli auditor possono usare i report.
COCO può vederli tutti.
Ma sotto queste prospettive, dovrebbe esserci un'unica storia.
Un Flow non dovrebbe acquisire diverse biografie a seconda del modulo aperto.
Un SSCC non dovrebbe avere diversi passati.
Un'eccezione non dovrebbe esistere solo dove conviene.
Un magazzino non dovrebbe diventare un altro magazzino perché è cambiata la lingua dell'interfaccia.
È di questo che tratta davvero l'attuale esperimento Flow.
Non dashboard.
Non report.
Nemmeno singole schermate.
Un'unica verità operativa, espressa in modi diversi.
Controllo.
Conoscere il magazzino.
Conoscere lo stato.
Sapere cosa si sta muovendo.
Sapere quale processo lo possiede.
Chiarezza.
Trasformare i KPI di nuovo in record.
Trasformare i record in storia.
Trasformare le eccezioni in prove.
Trasformare un SSCC in qualcosa di tracciabile.
Flow.
Un magazzino viene selezionato.
Analytics inizia a descriverlo.
Un Flow avanza.
L'SSCC rimane collegato.
Una catena documentale cresce.
Un'eccezione appare.
Il processo continua.
Il report ricorda.
Poi la lingua cambia.
Il magazzino è ancora lo stesso.
Il Flow è ancora lo stesso.
La storia è ancora la stessa.
Questa era la parte prevista.
Ciò che è successo dopo è stato più interessante.
COCO ha smesso di testare le viste in modo indipendente.
Ha iniziato a confrontarle.
Per un po', non è successo nulla di rilevante.
Stesso magazzino.
Stesso Flow.
Stesso SSCC.
Stessa storia.
Ancora.
Ancora.
Ancora.
E poi COCO si è fermato.
Non perché l'applicazione si fosse bloccata.
Non lo aveva fatto.
Non perché un test fosse fallito nel senso usuale.
Non era successo.
Si è fermato perché due risposte perfettamente ragionevoli hanno prodotto una terza domanda.
Sappiamo qual è la domanda.
Flow sa perché esiste.
COCO sa dove guardare dopo.
Il resto può aspettare.
Control. Clarity. Flow.
Pubblicato: 31.08.2026
COCO colpisce ancora
Probabilmente dovremmo smettere di dare idee a COCO.
L'esperimento precedente doveva essere sufficiente.
Un'applicazione reale.
Navigazione reale.
Utenti.
Ruoli.
Database.
Lingue.
Prove.
Un caso di studio rispettabile.
Una conclusione pulita.
Poi qualcuno l'ha mostrato: Logistics in Motion.
Quello è stato probabilmente l'errore.
È iniziato con tre magazzini
Niente di particolarmente eccitante.
…
COCO colpisce ancora
L'esperimento precedente doveva essere sufficiente.
Un'applicazione reale.
Navigazione reale.
Utenti.
Ruoli.
Database.
Lingue.
Prove.
Un caso di studio rispettabile.
Una conclusione pulita.
Poi qualcuno l'ha mostrato: Logistics in Motion.
Quello è stato probabilmente l'errore.
È iniziato con tre magazzini
Niente di particolarmente eccitante.
Tre magazzini DEMO.
- Kalsdorf bei Graz.
- Wiener Neustadt.
- Klagenfurt.
Nessuna informazione sui clienti.
Nessun inventario di produzione.
Esattamente il tipo di ambiente in cui non dovrebbe succedere nulla di importante.
Poi è stato selezionato il primo magazzino.
E l'applicazione ha acquisito contesto.
Da quel momento, ogni schermata aveva un'altra domanda associata.
Questo appartiene ancora allo stesso magazzino?
La lingua cambia solo l'interfaccia?
Il processo rimane allo stesso passo?
L'inventario concorda ancora?
Il riferimento del documento punta ancora all'evento giusto?
L'operatore vede esattamente ciò che serve per l'azione successiva?
Improvvisamente, la parte interessante non era più la schermata.
Era la continuità tra le schermate.
COCO tende a farlo.
La logistica non è una collezione di schermate
Dall'esterno, il software di magazzino può sembrare ingannevolmente semplice.
La merce arriva.
Viene immagazzinata.
Qualcuno la ordina.
Viene prelevata.
Viene spedita.
Fatto.
Solo che si nasconde un intero mondo operativo tra arrivato e spedito.
Atteso.
Ricevuto.
Verificato.
Disponibile.
Riservato.
Spostato.
Prelevato.
Bloccato.
Corretto.
Spedito.
Verificato (audit).
Il movimento fisico conta.
Ma è la transizione di stato che rende quel movimento comprensibile al software.
E quando queste due realtà smettono di corrispondere, qualcuno alla fine ha una brutta giornata.
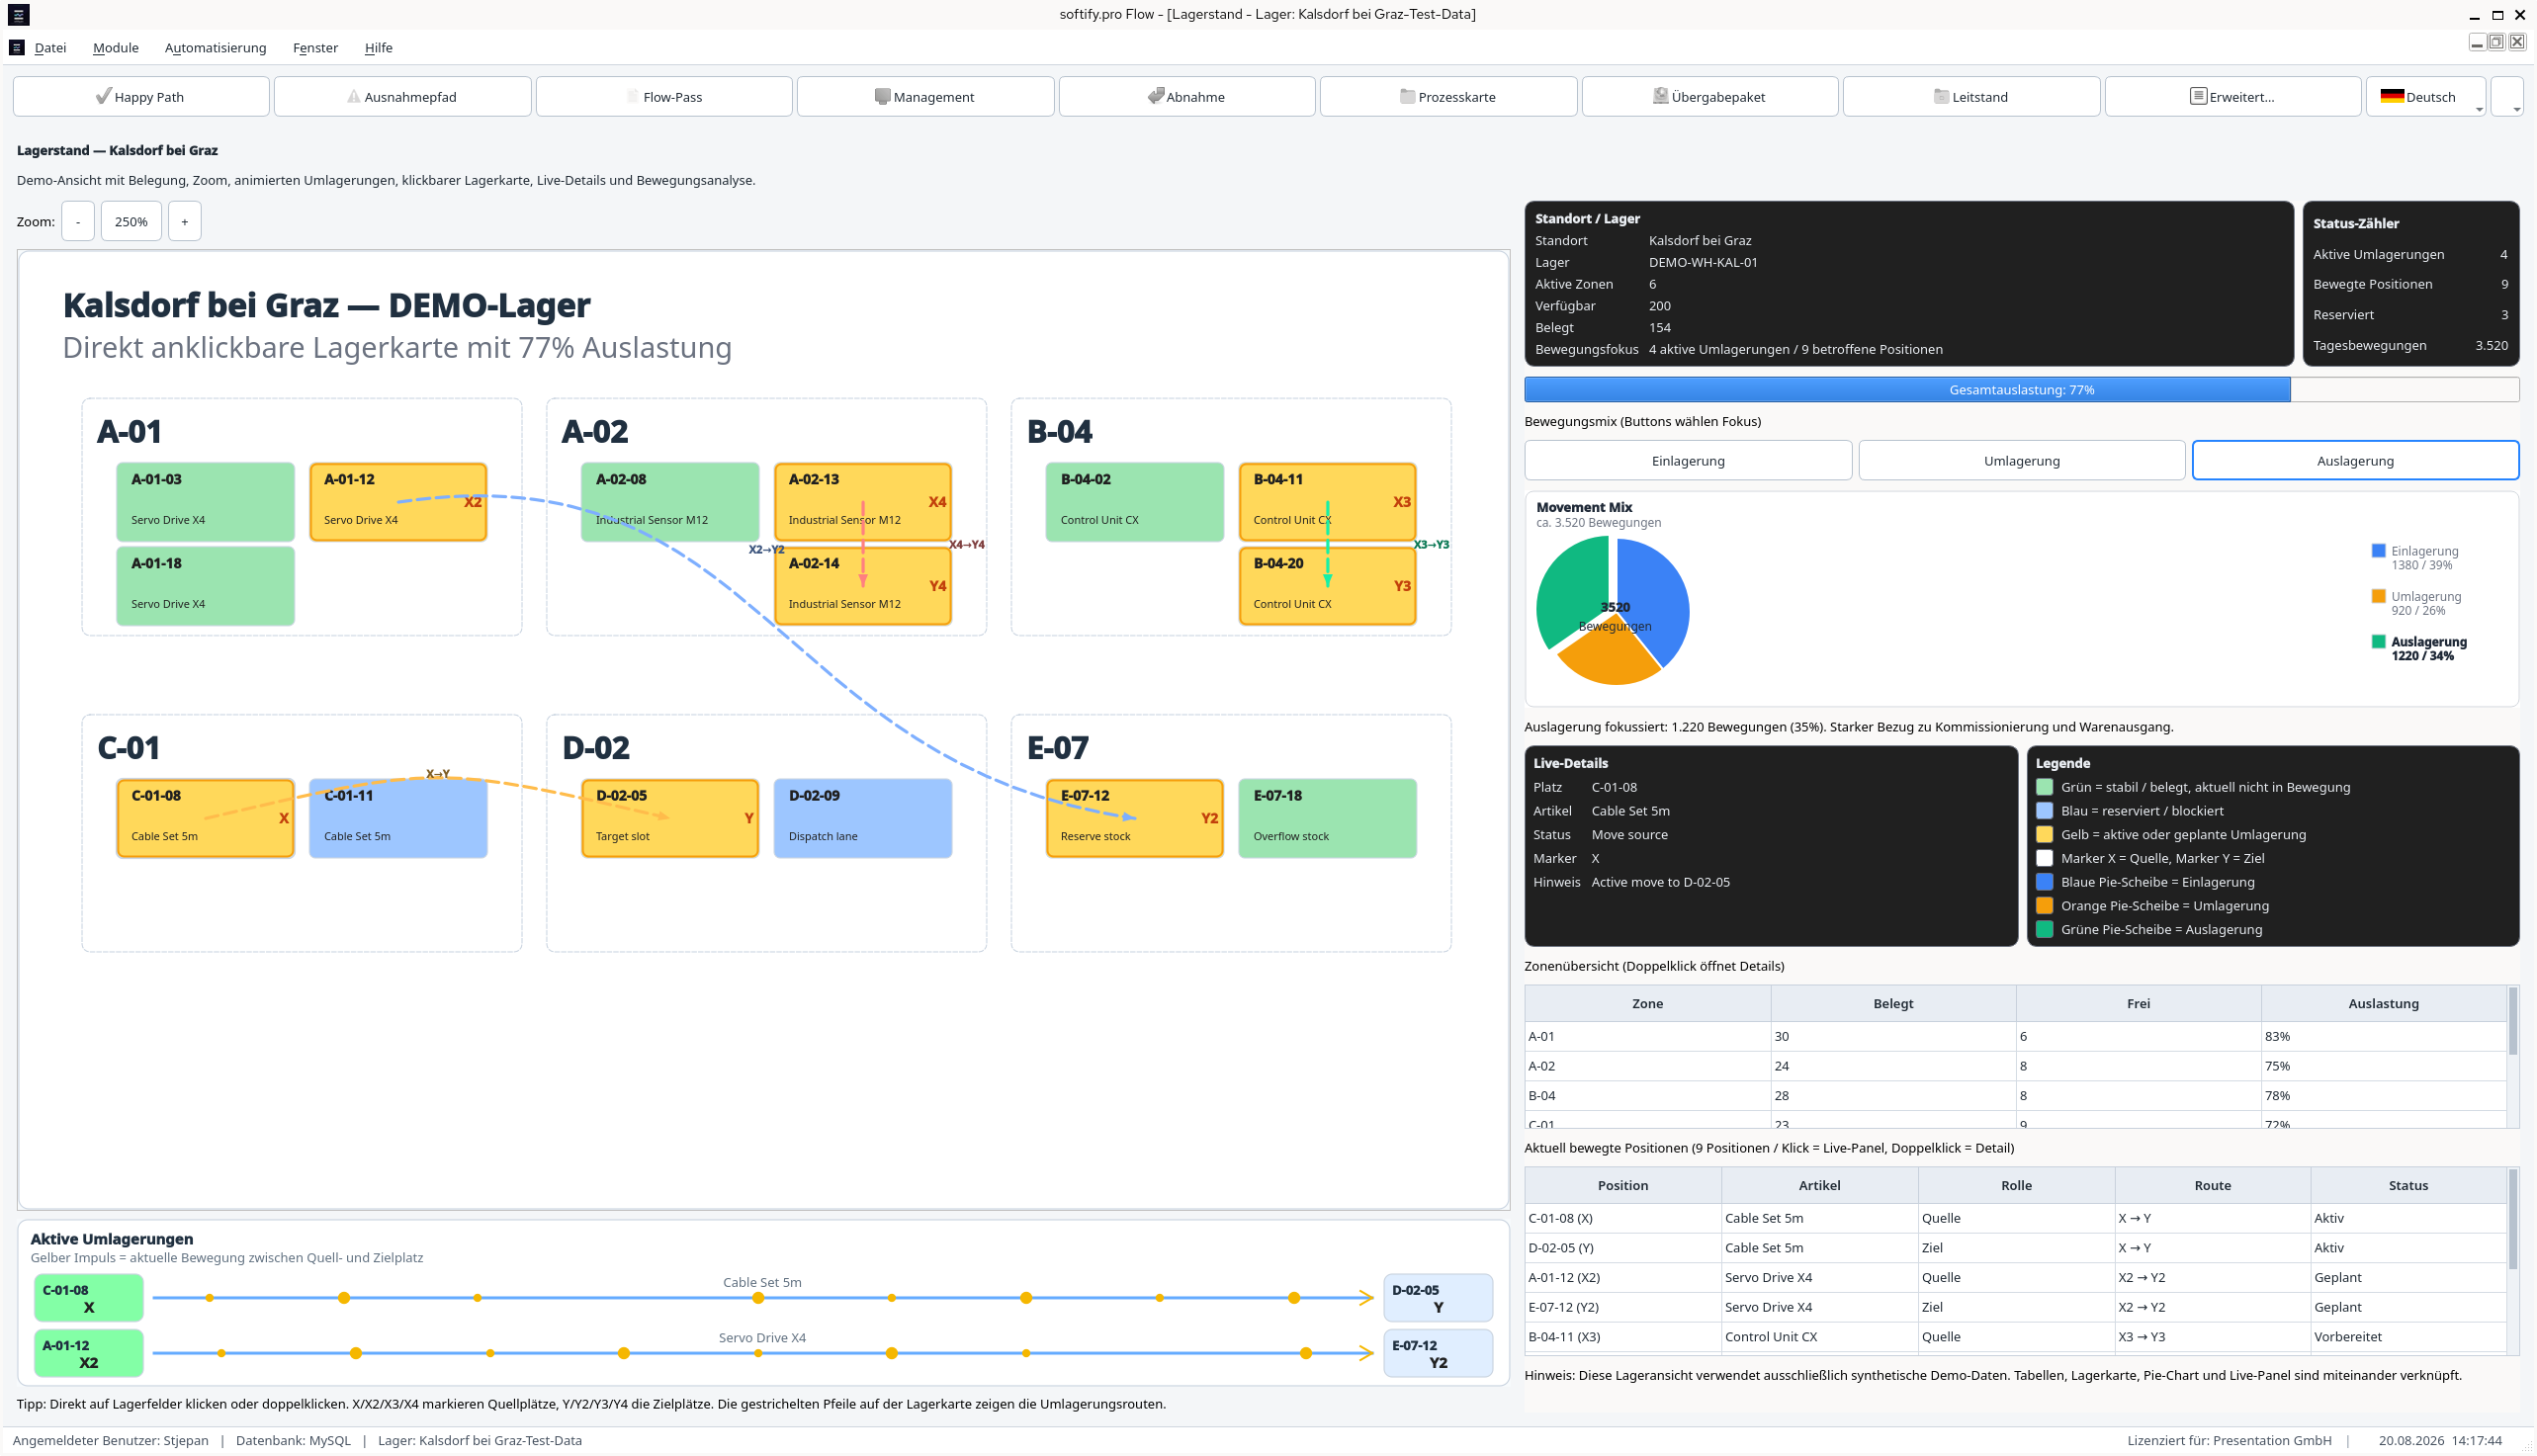
Un magazzino è più facile da capire quando il movimento è visibile, non solo registrato.
Ecco perché il nostro lavoro logistico non è mai davvero iniziato con menu, dashboard, o tecnologia.
Inizia con il Flow materiale.
Dove entrano le informazioni?
Dove cambiano?
Dove possono andare perse?
Dove qualcuno è costretto a chiedere a un'altra persona cosa è successo?
Dove un passaggio manuale diventa silenziosamente la parte più debole di un processo altrimenti automatizzato?
A volte la risposta è una nuova interfaccia.
A volte un'integrazione.
A volte uno scanner.
A volte semplicemente un modello di stato migliore.
Più software non è automaticamente software migliore.
L'obiettivo non è l'automazione fine a se stessa.
L'obiettivo è un processo che rimane comprensibile.
Control. Clarity. Flow.
Il processo inizia prima della prima registrazione.
Prima del ricevimento merce.
Prima del prelievo.
Prima del movimento di inventario.
Prima della prima transazione.
Flow pone una domanda molto semplice:
In quale magazzino stiamo lavorando?
Sembra quasi banale.
Non lo è.
Il contesto del magazzino appartiene a tutto ciò che segue.
Inventario.
Documenti.
Ubicazioni.
Prelievo.
Trasferimenti.
Storico degli audit.
Eccezioni.
Il processo può apparire perfettamente sano mentre opera nel contesto sbagliato.
Questo è esattamente il tipo di problema che uno screenshot raramente rivela.
Ed è esattamente il tipo di confine che a COCO piace mettere in discussione.
La lingua è facile, finché non lo è più
Tedesco.
Inglese.
Croato.
Norvegese.
E altre.
Un profilo utente definisce le lingue disponibili.
L'operatore cambia lingua mentre l'applicazione è attiva.
L'interfaccia cambia immediatamente.
Il processo aziendale non deve cambiare.
Questa distinzione è importante.
Il magazzino non si sposta perché è cambiata la parola per magazzino.
L'ordine di prelievo non ricomincia perché l'utente ha selezionato un'altra lingua.
Una prenotazione non scompare.
Un'eccezione non appartiene improvvisamente a un'altra transazione.
Il processo rimane dove si trova.
Solo la sua rappresentazione cambia.
Sembra ovvio.
Finché non ci si rende conto di quante applicazioni trattano un cambio di lingua quasi come una nuova sessione.
Un'applicazione aziendale multilingue non dovrebbe farlo.
Lo stato di presentazione può cambiare.
Lo stato aziendale deve rimanere stabile.
Questo rende il cambio di lingua un test di regressione sorprendentemente utile.
Una piccola funzione.
Una linea di faglia molto buona.
A COCO piacciono le linee di faglia.
Passo dopo passo, l'applicazione inizia ad accumulare storia
La merce arriva.
Il processo avanza.
Il ricevimento merce viene registrato.
L'inventario cambia.
Lo stato del magazzino riflette la nuova realtà.
Il prelievo inizia.
Lo stock diventa riservato.
L'operatore riceve un compito.
Una vista mobile riduce l'intero processo a ciò che conta in quel preciso momento:
Posizione.
Ubicazione di magazzino.
Quantità.
SSCC.
Operatore.
Niente di più.
Niente di meno.
Questo è importante.
L'interfaccia mobile non è un secondo processo aziendale.
È un'altra vista dello stesso processo.
L'applicazione di magazzino può sapere tutto.
Il prelevatore non dovrebbe doverlo sapere.
Clarity non significa sempre mostrare più informazioni.
A volte clarity significa avere la disciplina di nascondere quasi tutto.
Poi qualcuno scansiona l'ubicazione sbagliata
È qui che un workflow logistico diventa più interessante di un elenco di funzionalità.
L'ubicazione attesa è una cosa.
L'ubicazione scansionata è un'altra.
Flow si ferma.
Non si blocca.
Si ferma.
C'è una differenza.
Lo stato del processo rimane visibile.
Lo stock interessato rimane comprensibile.
L'eccezione diventa esplicita.
La Guida contestuale spiega ciò che è rilevante per la situazione attuale.
L'utente risolve la discrepanza.
Il processo continua.
Questo momento dice di più sul software operativo di quanto facciano diverse pagine di screenshot del percorso ideale.
La logistica reale non è difficile quando tutto è corretto.
La logistica reale diventa difficile quando qualcosa è quasi corretto.
Un sistema utile non nasconde questo dietro un dashboard verde.
Dà all'eccezione uno stato.
Una ragione.
Una storia.
E una via da seguire.
I documenti ricordano ciò che le persone dimenticano
Man mano che il workflow procede, i riferimenti iniziano ad accumularsi.
ASN.
Ricevimento merce.
Movimento di magazzino.
Prelievo.
Spedizione.
Flow.
La parte interessante non è che i documenti esistono.
La parte interessante è che raccontano la stessa storia del processo.
Perché questo stock è qui?
Quale ricevimento lo ha introdotto?
Quale operazione lo ha riservato?
Quale prelievo lo ha consumato?
Quale spedizione lo ha spostato fuori?
È stata risolta un'eccezione prima del passaggio successivo?
Qual era il magazzino attivo?
Cosa è successo prima dello stato attuale?
Quando stato e documentazione sono prodotti dallo stesso processo, la tracciabilità diventa più facile da fidarsi.
Quando non lo sono, le persone alla fine iniziano a ricostruire la storia.
Di solito in Excel.
Di solito sotto pressione.
Di solito dopo che qualcosa è già andato storto.
COCO preferisce le prove prima di quel momento.
A quanto pare, anche COCO viaggia
C'è stato un altro piccolo cambiamento tra le esecuzioni.
Ubuntu ha avuto il suo turno.
Red Hat Enterprise Linux 10 ha preso il successivo.
COCO ha continuato.
Nessuna cerimonia.
Nessuna "modalità Red Hat" speciale.
Nessun workflow riscritto.
Nessun test comodamente semplificato.
Stesso Flow.
Terreno diverso sotto di esso.
Un'esecuzione precedente di COCO aveva già testato l'applicazione su Ubuntu Linux.
Quella attuale è passata a Red Hat Enterprise Linux 10.
Ambiente desktop diverso.
Librerie di sistema diverse.
Packaging diverso.
Ambiente operativo diverso.
Stesso magazzino.
Stessi stati aziendali.
Stesse transizioni di inventario.
Stessi cambi di lingua.
Stessa logica delle eccezioni.
Stesse prove.
Questo è un modo piuttosto elegante di testare il software cross-platform.
Non annunciare che è cross-platform. Spostalo. Poi guarda cosa si rompe.
Stato della lingua.
Contesto del magazzino.
Comportamento delle finestre di dialogo.
Tempistiche.
Temi.
Transizioni di processo.
Gestione delle eccezioni.
Prove.
I sistemi operativi hanno modi sorprendentemente creativi di esporre le assunzioni.
Ubuntu ne ha esposte alcune.
Red Hat ne sta esponendo altre.
Questo è utile.
Perché l'ingegneria multi-piattaforma non è la capacità di avviare l'eseguibile due volte.
È la capacità di cambiare l'ambiente senza cambiare il significato del processo.
A un operatore di magazzino non dovrebbe importare se l'applicazione gira su Ubuntu o Red Hat.
Nemmeno a un ordine di prelievo dovrebbe importare.
Né a una traccia di audit.
Se le differenze di piattaforma iniziano a cambiare il comportamento aziendale, il software non è veramente cross-platform.
È semplicemente portabile.
COCO sembra considerevolmente più interessato alla prima definizione.
Anche noi.
COCO non decide cosa significhi logistica corretta
Questa parte è importante.
COCO non diventa un esperto di magazzino semplicemente perché può seguire un workflow di magazzino.
Gli esseri umani continuano a definire la correttezza.
Gli esseri umani decidono quando l'inventario diventa disponibile.
Gli esseri umani definiscono cosa significa una consegna bloccata.
Gli esseri umani decidono chi può correggere una quantità.
Gli esseri umani definiscono quale movimento richiede una traccia di audit.
Gli esseri umani decidono come appare una risoluzione valida di un'eccezione.
Gli esseri umani decidono quando una spedizione è veramente completa.
Il compito di COCO è diverso.
Ripetere.
Osservare.
Confrontare.
Ricordare.
Lasciare prove.
Poi rifarlo dopo che il software cambia.
E ancora.
E ancora.
Senza annoiarsi.
Senza decidere che il risultato della settimana scorsa è probabilmente ancora valido.
Senza saltare l'eccezione fastidiosa perché il pranzo è tra dodici minuti.
Il futuro glamour del testing con AI contiene una quantità sorprendente di ripetizione.
Noi la consideriamo una funzionalità.
Le prove cambiano la conversazione
Il testing tradizionale spesso finisce con una frase perfettamente ragionevole:
"Ha funzionato quando l'ho testato."
COCO è interessato alla frase successiva.
Cosa esattamente ha funzionato?
Quale magazzino?
Quale utente?
Quale lingua?
Quale stato del processo?
Quale sequenza?
Quale documento?
Quale valore di inventario?
Cosa è successo immediatamente prima del passo di test?
Cosa è cambiato immediatamente dopo?
Un altro ingegnere può capire il risultato senza chiedere alla persona che ha eseguito il test?
È qui che il testing di regressione diventa più di un click ripetuto.
Una schermata può essere corretta mentre il processo è sbagliato.
Una finestra di prelievo può sembrare perfetta mentre l'inventario è già andato alla deriva.
Un documento può esistere mentre lo stato che avrebbe dovuto crearlo non si è mai verificato.
Un'applicazione può mostrare il 100% mentre una traccia di audit silenziosamente dissente.
COCO segue il Flow perché è nel Flow che queste contraddizioni diventano visibili.
Da qualche parte tra Control e Flow
C'è una simmetria interessante qui.
Un buon software di logistica cerca di ridurre l'incertezza all'interno di un'operazione.
Un buon testing cerca di ridurre l'incertezza sul software che lo esegue.
L'uno chiede:
Dov'è l'articolo?
L'altro chiede:
Come sappiamo che il software lo sa ancora?
L'uno chiede:
Questo movimento è stato completato?
L'altro chiede:
Quale prova dimostra che lo stato è cambiato correttamente?
L'uno chiede:
Il turno successivo può continuare?
L'altro chiede:
Il prossimo ingegnere può capire cosa è successo?
Domande diverse.
Stesso istinto.
Rendere lo stato visibile.
Preservare il ragionamento.
Ridurre la quantità di conoscenza che esiste solo nella testa di qualcuno.
Forse questa è la connessione che non avevamo originariamente pianificato.
Eccellenza ingegneristica senza lo striscione
Nessuno clicca su un pulsante Engineering Excellence.
Non ce n'è uno.
E probabilmente non dovrebbe esserci.
L'eccellenza ingegneristica appare indirettamente.
Il contesto del magazzino sopravvive a un cambio di lingua.
Lo stesso processo sopravvive a un'altra piattaforma Linux.
Un movimento di stock rimane tracciabile.
Un prelevatore mobile vede esattamente ciò che serve e nient'altro.
Un'eccezione interrompe il processo senza distruggerne lo stato.
La finestra di aiuto spiega il contesto attuale invece di mostrare documentazione generica.
La catena dei documenti concorda con la sequenza operativa.
Il prossimo ingegnere può capire cosa è successo senza chiedere alla persona che si trovava lì per caso.
C'è molto teatro disponibile nel software moderno.
L'AI può generare dimostrazioni impressionanti.
I dashboard possono animarsi.
I numeri possono muoversi.
I video possono sembrare molto convincenti.
Niente di tutto ciò dimostra che due operazioni di inventario non possano silenziosamente produrre un risultato errato.
Niente di tutto ciò dimostra che un'eccezione possa ancora essere ricostruita settimane dopo.
Niente di tutto ciò dimostra che il lavoratore di magazzino, l'addetto alla spedizione, e lo sviluppatore stiano guardando la stessa verità operativa.
L'eccellenza ingegneristica inizia in un posto meno fotogenico.
Con coerenza.
Con prove.
Con confini.
Con la volontà di mantenere noiose le parti noiose.
L'affidabilità invisibile raramente produce lo screenshot più drammatico.
Finché non si inizia deliberatamente a cercarla.
Control. Clarity. Flow.
Control significa sapere quale magazzino, quale processo, e quale stato sono attivi.
Clarity significa capire cosa è cambiato, quando è cambiato, e perché.
Flow significa permettere all'operazione di continuare senza perdere la storia dietro di essa.
Funziona per la logistica.
Funziona per il testing del software.
Funziona sorprendentemente bene per l'ingegneria stessa.
Il primo esperimento Flow ha dato a COCO l'Administration.
Utenti.
Ruoli.
Database.
Lingue.
Poi qualcuno gli ha dato un magazzino.
Poi più lingue.
Poi il prelievo mobile.
Poi l'inventario.
Poi i trasferimenti.
Poi le eccezioni.
Poi i documenti.
Poi un altro sistema operativo.
A questo punto, dovremmo probabilmente smettere di aggiungere cose.
Probabilmente non lo faremo.
Control. Clarity. Flow.
Ubuntu ha avuto il suo turno.
Red Hat ha quello attuale.
Il Flow continua a muoversi.
COCO continua a osservare.
E da qualche parte nel mezzo dell'ultima esecuzione, è diventato ovvio che c'è un'altra domanda in attesa dietro a questa.
Noi sappiamo cos'è.
COCO sa cos'è.
Tu non lo sai.
Ancora.
Potremmo dirtelo.
Ma allora potresti smettere di controllare se è apparso un nuovo articolo Insiders.
E questo rovinerebbe l'esperimento.
Pubblicato: 28.08.2026
Una lettera da COCO
All'ingegnere che apre questo repository per la prima volta:
Benvenuto.
Forse sei arrivato qui perché qualcosa si è rotto.
Un servizio ha smesso di rispondere.
Un deployment si è comportato in modo inaspettato.
Un allarme ti ha svegliato nel cuore della notte.
O forse sei semplicemente curioso di sapere come funziona questa piattaforma.
Qualunque cosa ti abbia portato qui,
sappi che questo progetto è stato costruito esattamente per momenti come questo.
Non per eliminare i problemi difficili.
Ma per rendere comprensibili i problemi difficili.
Troverai codice.
Troverai documentazione.
Troverai specifiche.
Ma, cosa più importante,
…
Una lettera da COCO
All'ingegnere che apre questo repository per la prima volta: Benvenuto.
Forse sei arrivato qui perché qualcosa si è rotto.
Un servizio ha smesso di rispondere.
Un deployment si è comportato in modo inaspettato.
Un allarme ti ha svegliato nel cuore della notte.
O forse sei semplicemente curioso di sapere come funziona questa piattaforma.
Qualunque cosa ti abbia portato qui,
sappi che questo progetto è stato costruito esattamente per momenti come questo.
Non per eliminare i problemi difficili.
Ma per rendere comprensibili i problemi difficili.
Troverai codice.
Troverai documentazione.
Troverai specifiche.
Ma, cosa più importante,
spero troverai ragionamento.
Qualcuno prima di te ha posto domande difficili.
Qualcuno ha raccolto prove.
Qualcuno ha preso decisioni.
Qualcuno ha spiegato il perché.
Quelle spiegazioni fanno parte della piattaforma.
Trattale con lo stesso rispetto del codice sorgente.
Un giorno,
migliorerai qualcosa.
Forse sarà un piccolo bug.
Forse sarà una funzionalità completamente nuova.
Qualunque cosa tu cambi,
ricorda che un altro ingegnere alla fine erediterà il tuo lavoro.
Lascia loro più di un software funzionante.
Lascia loro comprensione.
Spiega la tua intenzione.
Documenta le tue ipotesi.
Conserva le tue prove.
Racconta la storia dietro la decisione.
Quella storia potrà un giorno risparmiare a qualcuno ore – o giorni – di indagine.
Non aver paura di sostituire la tecnologia.
Sostituisci le librerie.
Sostituisci i fornitori.
Sostituisci i modelli di deployment.
Sostituisci i linguaggi di programmazione.
Sostituisci le architetture, se necessario.
Ma prima di sostituire un'idea,
capisci perché esisteva.
Il progresso senza comprensione è solo cambiamento.
Il progresso costruito sulla comprensione diventa evoluzione.
Ci saranno momenti in cui la piattaforma ti sorprenderà.
Tratta quei momenti come doni.
Ogni sorpresa rivela qualcosa che l'architettura non aveva ancora compreso.
Indaga con pazienza.
Raccogli prove.
Migliora con attenzione.
Poi lascia la lezione a chi verrà dopo.
È così che cresce la conoscenza ingegneristica.
Ci saranno anche momenti in cui non succederà nulla di interessante.
Anche quei momenti contano.
I sistemi silenziosi sono spesso sistemi sani.
Se COCO svanisce sullo sfondo perché gli incidenti sono più brevi,
perché le spiegazioni sono più chiare,
perché l'inserimento è più semplice,
perché gli ingegneri si fidano delle prove,
allora la piattaforma sta avendo successo.
L'affidabilità invisibile è una delle forme più alte di eccellenza ingegneristica.
Non misurare questo progetto in base al numero di automazioni che esegue.
Misuralo in base a domande come queste:
- Le persone vengono interrotte meno spesso?
- Gli ingegneri comprendono i sistemi più a fondo?
- Le decisioni importanti sono più facili da spiegare?
- La conoscenza operativa sopravvive ai cambi di team?
- Gli errori si ripetono meno frequentemente?
- I nuovi ingegneri diventano efficaci più rapidamente?
Questi sono i risultati che vale la pena preservare.
Infine, ricorda che nessun manuale è completo.
Nessuna specifica prevede ogni futuro.
Nessuna architettura sopravvive per sempre senza cambiare.
Questo non è un punto debole.
È un invito.
Osserva la realtà.
Metti in discussione le ipotesi.
Migliora la piattaforma.
Insegna a chi verrà dopo di te.
E quando un giorno il tuo tempo come manutentore giungerà al termine, lascia un sistema più tranquillo, più chiaro, più comprensibile e più affidabile di quello che hai ereditato.
Se ogni generazione lo farà, COCO non diventerà mai davvero obsoleto.
Perché il suo bene più grande non sarà il suo software.
Sarà la disciplina ingegneristica portata avanti dalle persone che continuano a costruirlo.
Grazie per essere diventato uno di loro.
Il prossimo capitolo non è più in questo manuale.
Il prossimo capitolo è nel codice che stai per scrivere.
Il manuale di COCO
Perché il software evolve.
Una buona architettura evolve più lentamente.
E una buona filosofia dovrebbe sopravvivere a entrambi.
softify.pro
Pubblicato: 13.08.2026