softify.pro
Laster …
Tjenester Om oss COCO – vår AI-server Portefølje Insiders Case-studier Godt å vite Kontakt Logg inn

Godt å vite

Pure fluidity meets ultimate performance: hva som virkelig gjør forretningsprogramvare rask

Pure fluidity meets ultimate performance: hva som virkelig gjør forretningsprogramvare rask

En lagersjef kjenner ikke igjen dårlig programvare på en arkitekturtegning. Vedkommende kjenner den igjen på at medarbeidere igjen griper etter telefonen, registrerer følgesedler dobbelt eller etter et skift ikke kan si hvilke varer som faktisk er kommet. Pure fluidity meets ultimate performance må derfor ikke være et blott visuelt krav. For forretningsprogramvare betyr det at en sak føles naturlig og samtidig fungerer pålitelig under reelle forhold.

Et elegant grensesnitt er verdiløst hvis det hakker ved svakt WLAN i lageret. En rask applikasjon hjelper likeledes lite hvis den tvinger fram en arbeidsrekkefølge som ingen ved rampen kan følge. Gode digitale verktøy forener utforming, hastighet og prosessforståelse. De reduserer friksjon uten å presse virksomheten inn i en ferdiglaget standardlogikk.

Pure fluidity meets ultimate performance er et driftsspørsmål

Flyt forveksles ofte med animasjoner, store bilder og myke overganger. Det kan passe til et moderne merke. I arbeidshverdagen viser den seg likevel annerledes: et varemottak kan bokføres uten omveier. En medarbeider finner en ordre også når bare et referansenummer er kjent. En feil benevnes tydelig, i stedet for å forsvinne i en kryptisk melding.

Ytelse er likeledes mer enn en god verdi i en nettlesertest. Avgjørende er responstiden ved en ordre med mange posisjoner, stabiliteten ved månedsskiftet og spørsmålet om fem personer kan arbeide samtidig uten å overskrive hverandres datagrunnlag. Også en ren håndtering av tilkoblingsbrudd, rettigheter og sperrede kontoer hører med.

Begge er uatskillelige. Hvis et skjermbilde reagerer umiddelbart men har uklare obligatoriske felt, forblir det slitsomt. Hvis forløpet er klokt modellert men siden venter to sekunder ved hver bokføring, blir det omgått. Flyt oppstår der systemet støtter neste fornuftige handling og teknisk forblir raskt nok til at tankerekken ikke brytes.

Grensesnittet følger arbeidsveien, ikke organisasjonskartet

Mange standardløsninger strukturerer menyene sine etter moduler: innkjøp, salg, lager, rapportering, administrasjon. Fra et produktperspektiv er det forståelig. På lagergulvet begynner arbeidet imidlertid ofte med en situasjon: en lastebil står der, en pall mangler, en kunde trenger et leveringsbevis eller en forsendelse må merkes før mottaket stenger.

En god individuell applikasjon begynner derfor med disse situasjonene. Hvilken informasjon foreligger? Hvem avgjør? Hva må dokumenteres? Hva må ikke endres senere? Først deretter avgjøres hvilket inndataskjema, hvilken kontroll eller automatisering som er nødvendig.

Det betyr ikke å støpe hvert eksisterende forløp uendret i programvare. Noen tabeller er virkelig for feilutsatte, noen godkjenninger unødig trege. Men en fungerende Excel-liste må ikke nødvendigvis erstattes av et prosjekt. Hvis den bare vedlikeholdes av én person, kjenner få unntak og forblir sporbar, kan den være det passende verktøyet. Programvare lønner seg når den forbedrer koordineringen, reduserer feilkilder eller gjør informasjon pålitelig tilgjengelig for flere involverte.

Færre klikk er ikke automatisk bedre

Kravet om færrest mulig klikk høres fornuftig ut, men kan føre i feil retning. Ved en uopprettelig lagerbokføring er en kort bekreftelse meningsfull. Ved en forsendelsesgodkjenning kan en synlig sannsynlighetskontroll forhindre dyr etterarbeid. Riktig forløp avhenger av risikoen.

Avgjørende er at ekstra steg har et klart formål. En bekreftelse bør ikke dukke opp bare fordi rammeverket lett genererer den. Den bør stå nøyaktig der mennesker bevisst må ta en beslutning. Slik forblir applikasjonen rask uten å bli lettsindig.

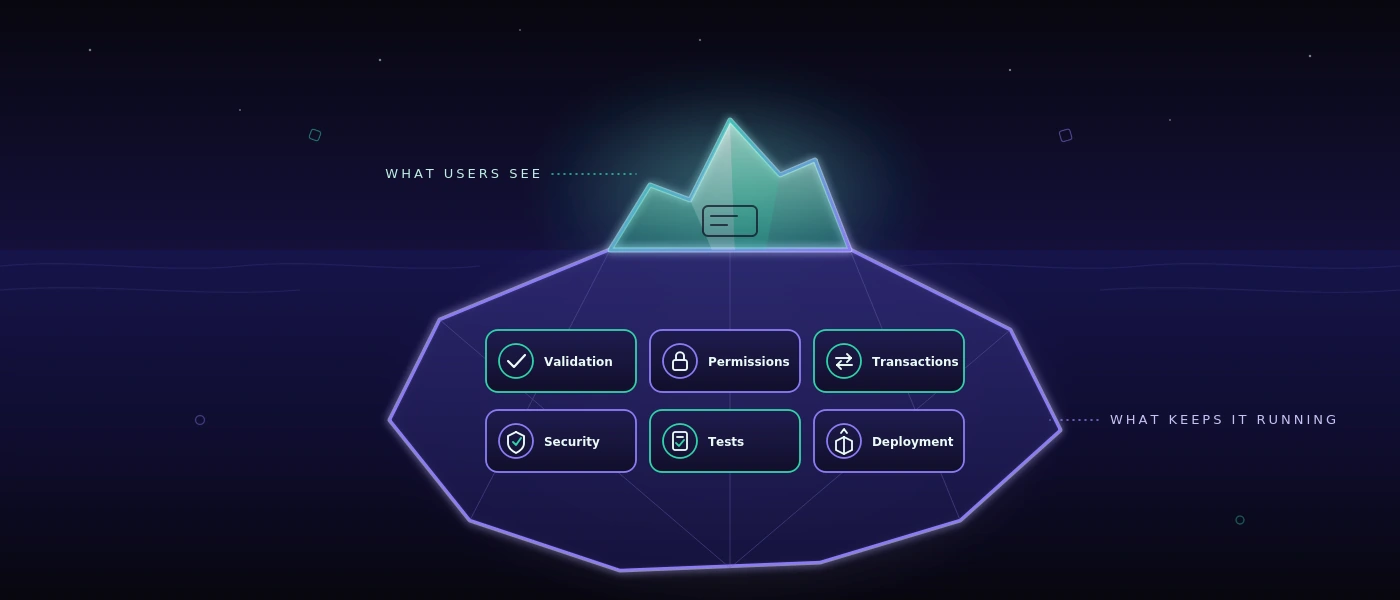
Ytelse oppstår i arkitekturen, ikke i den siste sprinten

Den som fremskynder et nettsted eller en webapplikasjon først kort før go-live, behandler som regel symptomer. Store spørringer, uklare datamodeller og i etterkant tilføyde spesialtilfeller lar seg ikke varig korrigere med én enkelt optimaliseringsdag.

Et bærekraftig grunnlag begynner med en database som tilsvarer de faktiske sammenhengene i virksomheten. I MySQL 8 trenger bevegelser, bilag, statusendringer og brukerhandlinger sporbare nøkler og fornuftige indekser. En beholdning må ikke bare fremstå som et tall hvis det senere må avklares hvilken bokføring den oppsto av. Samtidig trenger ikke hver historisk informasjon å beregnes på nytt ved hvert sidekall.

Ved moderne webapplikasjoner er også ansvarsfordelingen relevant. PHP 8.4 kan avbilde forretningsregler tydelig og vedlikeholdbart, mens moderne JavaScript brukes målrettet for reaktive områder. Det er ingen trosbekjennelse for en bestemt stack. Det er et vedlikeholdsspørsmål: kan endringer gjennomføres trygt om seks måneder? Er det synlig hvor en regel gjelder? La en feil seg reprodusere, i stedet for bare å mistenkes?

Ytelse trenger dessuten grenser. Søkefelt trenger fornuftige minimumstegn eller en presis filterlogikk hvis millioner av poster er tenkelige. Store lister trenger sider eller trinnvise etterlastingsprosesser. Bilder og dokumenter bør ikke blokkere den kritiske arbeidsflyten. Disse beslutningene virker lite spektakulære. Nettopp derfor forblir de ofte verdifulle lenger enn en iøynefallende frontend-effekt.

Synlig hastighet skaper tillit

Ikke hver prosess kan være ferdig på under et sekund. En etikettutskrift, et grensesnitt mot transportøren eller en kontroll mot eksterne data tar av og til tid. Avgjørende er da hvordan applikasjonen håndterer ventetid.

En tydelig status som «Forsendelsesetikett opprettes» er bedre enn en frossen knapp. Etter en avslutning bør det være synlig hvilket nummer som ble opprettet og om saken kan utløses på nytt. Hvis en ekstern tjeneste ikke er tilgjengelig, trenger teamet et forståelig handlingsalternativ i stedet for en feilmelding for utviklere.

Det er også et spørsmål om dataintegritet. Et dobbeltklikk må ikke opprette to leveranser. En avbrutt prosess må ikke i stillhet etterlate en halvferdig post. Gode systemer planlegger for slike tilfeller fordi de vil inntreffe i hverdagen. Spesielt ved skiftende skift, tidspress og mobile enheter er unntaket ikke noe randtema.

Kvalitet blir synlig før feilen

For applikasjoner med mange prosessvarianter er det ikke nok å klikke seg manuelt gjennom noen veier til slutt. Endringer i priser, roller, valideringer eller grensesnitt kan utløse følger på et fjerntliggende sted. Her blir automatisert testing en del av ytelsen: ikke bare teknisk, men organisatorisk.

Et testsystem bør kunne kontrollere reelle forløp, for eksempel opprette en ordre, endre en posisjon, generere en følgeseddel og kontrollere en rettighet. Det bør registrere bevis og formulere resultater slik at fagavdelinger kan plassere dem. En setning som «Forsendelsesprosessen ble ikke fullført etter adresseendringen» hjelper mer enn en ukommentert stacktrace.

For sikkerhetsbevisste team er også stedet relevant der disse testene kjører. Hvis skjermbilder, påloggingsopplysninger, testtilfeller eller interne applikasjonssteg ikke skal forlate bedriften, er en selvhostet tilnærming ofte fornuftigere enn en ekstern skytjeneste. Med COCO kan automatiserte tester for web- og Windows-applikasjoner kjøres i et dedikert miljø. Det er ikke nødvendig for hvert team. Ved sensitive data, regulerte områder eller interne fagapplikasjoner kan kontrollen over testdata likevel være en avgjørende fordel.

Utforming er god når den letter arbeidet

En sterk visuell identitet kan skape tillit. Den viser at en bedrift tar sin digitale tilstedeværelse på alvor. I det operative systemet må utformingen imidlertid yte enda mer: orientering under tidspress. Kontrast, typografi, tydelige tilstander og forståelige betegnelser avgjør om noen avslutter en sak trygt eller spør kollegaen.

Tilbakeholdenhet er her ofte det bedre valget. Et dashbord med ti fargede nøkkeltall kan se imponerende ut og likevel skjule det eneste relevante avviket. En redusert visning som gjør åpne varemottak, manglende skanninger og truede leveringstider synlige, er mer nyttig. Spørsmålet lyder ikke hvor mye grensesnitt som er mulig, men hvilken informasjon som forbedrer en beslutning.

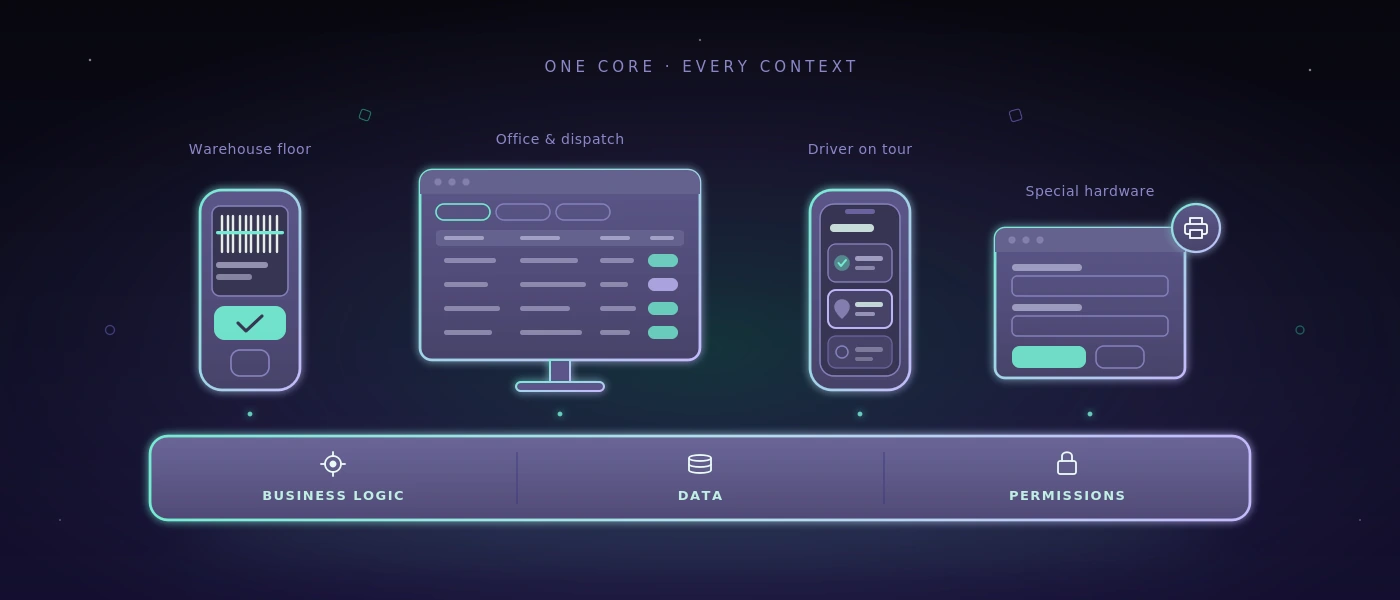
Det gjelder også responsive applikasjoner. Mobilkapasitet betyr ikke å presse hvert skrivebordsbilde inn i et mindre format. En smarttelefon ved varemottaket trenger kanskje bare skanning, mengde, lagerplass og bekreftelse. Den utførlige etterbehandlingen hører muligens hjemme på en større skjerm. Ulike enheter fortjener ulike prioriteringer, selv om de bruker det samme pålitelige datagrunnlaget.

En fornuftig målestokk for neste beslutning

Før et team bestemmer seg for en ny plattform, en automatisering eller en fullstendig nybygging, hjelper en enkel kontroll: blir forløpet klarere, raskere eller tryggere for menneskene som utfører det daglig? Og lar løsningen seg fortsatt forstå når krav, medarbeidere eller grensesnitt endres?

Hvis begge svarene holder, blir et vakkert løfte et brukbart system. Da viser pure fluidity meets ultimate performance seg ikke på et lysbilde, men på en rolig arbeidsdag der ordrer, data og beslutninger fortsetter uten unødig friksjon.
Permalenke →

SaaS Flow Web: innføre arbeidsflyter trygt under løpende drift

SaaS Flow Web: innføre arbeidsflyter trygt under løpende drift

Et varemottak blir ikke liggende fordi et team ikke kjenner enda en programvare. Det blir liggende fordi informasjon går tapt mellom e-post, papirskjema, Excel-fil og telefonsamtale. Ved SaaS - «Flow Web» på flow.softify.pro - bør derfor ikke grensesnittet være det første spørsmålet. Avgjørende er om tjenesten pålitelig avbilder en konkret arbeidsflyt - også på hektiske dager, ved skiftende ansvar og når en leveranse ikke tilsvarer planen.

For små og mellomstore bedrifter er SaaS ofte fornuftig, fordi de ikke først må bygge egne servere, utgivelser og grunnfunksjoner. Men det er ikke noe fribillett for hver prosess. Den som innfører et verktøy som gjør hverdagen mer komplisert eller presser viktige data inn i uklare sidelister, digitaliserer ikke arbeid. Vedkommende flytter bare friksjonen.

Hva SaaS «Flow Web» må yte

En nettbasert arbeidsflyt er god når medarbeidere uten tolkning vet hva som skal gjøres neste. Ved et varemottak kan det bety: registrere leveransen, kontrollere mengder mot bestillingen, dokumentere avvik, tildele lagerplass og ved behov informere en ansvarlig. Forløpet trenger ikke være spektakulært. Det må være sporbart, raskt og gjentakbart.

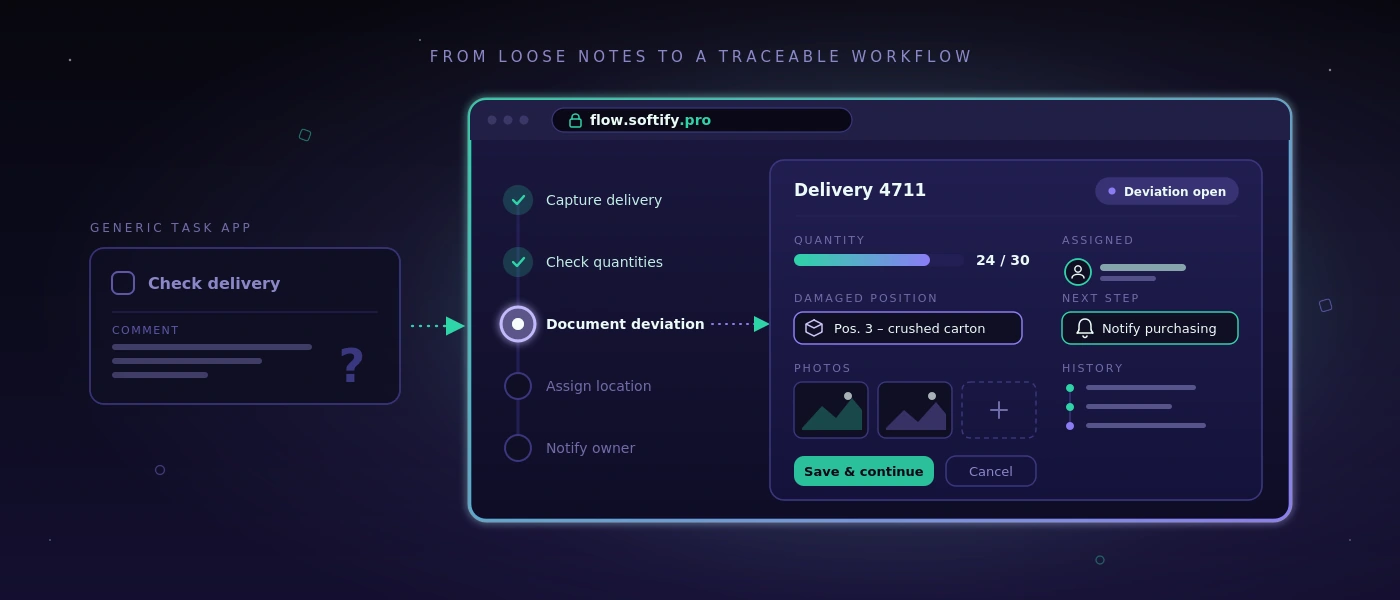
Akkurat her ligger forskjellen mellom en generell oppgaveapp og et faglig prosessystem. En oppgaveapp kan opprette et punkt som heter «Kontrollere leveranse». En faglig arbeidsflyt kan i tillegg registrere hvilken leveranse som menes, hvem som tok imot den, hvilken posisjon som var skadet, hvilke bilder som finnes og om en ettersendelse er utestående. Disse dataene står da ikke som fritekst i en enkelt kommentar, men der neste person trenger dem.

For en løsning som Flow Web på flow.softify.pro bør vurderingen derfor begynne ved sakene, ikke ved en funksjonsliste. En bedrift med fem lagerbevegelser om dagen trenger noe annet enn et forsendelsesteam med flere cut-off-tider, ulike transportører og regelmessig håndtering av delleveranser. SaaS er ingen erstatning for prosessforståelse.

Først navngi flaskehalsen, deretter konfigurere

Mange digitaliseringsprosjekter starter for bredt: «Vi vil digitalisere lageret.» Det høres plausibelt ut, men fører raskt til et system med for mange skjermbilder, spesialtilfeller og opplæringsmateriell. Bedre er en presis uttalelse som: «Varemottak bokføres først neste dag, fordi følgesedler ved skiftslutt ligger på skrivebordet.»

Fra en slik setning kan en fornuftig start utledes. Den første versjonen kan registrere følgesedler, bekrefte artikler og mengder, markere avvik og føre bokføringen videre til ansvarlig enhet. Når dette forløpet fungerer, kan etiketter, leverandørvurderinger eller automatiske bestillingsforslag legges til senere. Ikke hvert fornuftig utbyggingstrinn hører hjemme i den første utrullingen.

Også en velholdt tabell kan bli hvis den oppfyller sitt formål. For eksempel kan en månedlig evaluering med få involverte i en eksisterende fil være rimeligere og mer transparent enn en egen modul. SaaS lønner seg der informasjon brukes flere ganger, behandlingstider er kritiske eller feil oppstår fra mediebrudd.

De riktige spørsmålene før innføringen

Før konfigurasjonen bør et team spille gjennom en virkelig sak fra begynnelse til slutt. Ikke idealprosessen, men tilfellet som skaper problemer i hverdagen: feil mengde, manglende referanse, hastig forsendelse eller en ordre med spesialgodkjenning. Der viser reglene seg som et system faktisk må avbilde.

Relevante er blant annet disse punktene: hvem får opprette, endre eller avslutte en sak? Hvilke inndata er obligatoriske, hvilke bare nyttige? Når må en leder informeres? Hvilke data overleveres til regnskap, forsendelse eller kundeservice? Og hva skjer hvis WLAN i lageret er svakt eller en medarbeider ikke lenger har påloggingsopplysningene sine?

Svarene bestemmer kvaliteten på innføringen sterkere enn en lang katalog med visuelle krav. En ren rolleprosess, en forståelig feilmelding og et dokumentert godkjenningssteg forhindrer i drift som regel mer arbeid enn en ekstra rapport på startsiden.

Datalagring og roller er ingen bisak

SaaS behandles ofte som et rent betjeningsspørsmål. For drifts- og IT-ansvarlige er det imidlertid minst like viktig hva som skjer med dataene. Det gjelder stamdata, leveringsinformasjon, medarbeiderdata, bilder av skader og eventuelt kundedata. Før innføringen bør ansvar, oppbevaring og eksportmuligheter være klare.

Praktisk betyr det: bedriften må vite hvilke data som ligger i systemet, hvem som har administrativ tilgang og hvordan data stilles til rådighet ved bytte eller opphør av avtale. En eksport som bare er tilgjengelig som tungt lesbar PDF-fil hjelper sjelden. For operative data er strukturerte, brukbare formater avgjørende.

Også rettighetskonseptet fortjener konkret oppmerksomhet. I lageret trenger ikke hver person å se priser, kundevilkår eller globale innstillinger. Samtidig må en for snever rettighetstildeling ikke blokkere flyten. Fornuftige er roller som er innrettet etter faktiske oppgaver: mottak, disposisjon, forsendelse, teamledelse og administrasjon. Kritiske endringer bør være sporbare, slik at man ved spørsmål ikke må gjette hvem som endret en bokføring.

Selve tilgangen bør beskyttes med solide grunnlag. Dit hører sikre passordpolicyer, en regulert tilbakestilling av passord, kontolåsing ved gjentatte mislykkede forsøk og, der risikoprofilen krever det, ytterligere påloggingssteg. Sikkerhet virker profesjonell når den er forutsigbar og ikke merkes først når noen er blitt låst ute.

Integrasjon bare der den målbart avlaster

En nettbasert arbeidsflyt utfolder ofte sin verdi først i samspill med eksisterende systemer. Det kan være et ERP, en nettbutikk, en forsendelsesløsning, en tidsregistrering eller en database. Likevel er ikke hvert grensesnitt automatisk fornuftig. Hver integrasjon skaper avhengigheter, feilbilder og vedlikeholdsarbeid.

Det sentrale spørsmålet lyder: hvilket manuelt steg fjerner forbindelsen konkret? Hvis et grensesnitt hver dag sparer 30 minutter overføringsarbeid og reduserer skrivefeil, er nytten klar. Hvis det bare speiler en informasjon som uansett kontrolleres én gang i uken, kan en manuell eksport først være den fornuftigere løsningen.

Ved individuelle utvidelser teller det tekniske grunnlaget. Dokumenterte grensesnitt, tydelig definerte datafelt og sporbare feilprotokoller letter senere drift. Hvis et system kobles til en skreddersydd webapplikasjon, bør teknologier og databasestruktur velges slik at de forblir vedlikeholdbare på lang sikt. En velholdt applikasjon basert på PHP 8.4, moderne JavaScript og MySQL 8 er mer verdifull enn en kortsiktig imponerende spesialløsning uten dokumentasjon.

Innføring under løpende drift

Den vanligste feilen er en hard start uten sammenligningsfase. Team skal da mandag morgen straks arbeide annerledes, mens åpne spørsmål først oppstår fra virkelige problemer. Det øker avvisningen, selv om programvaren i prinsippet passer.

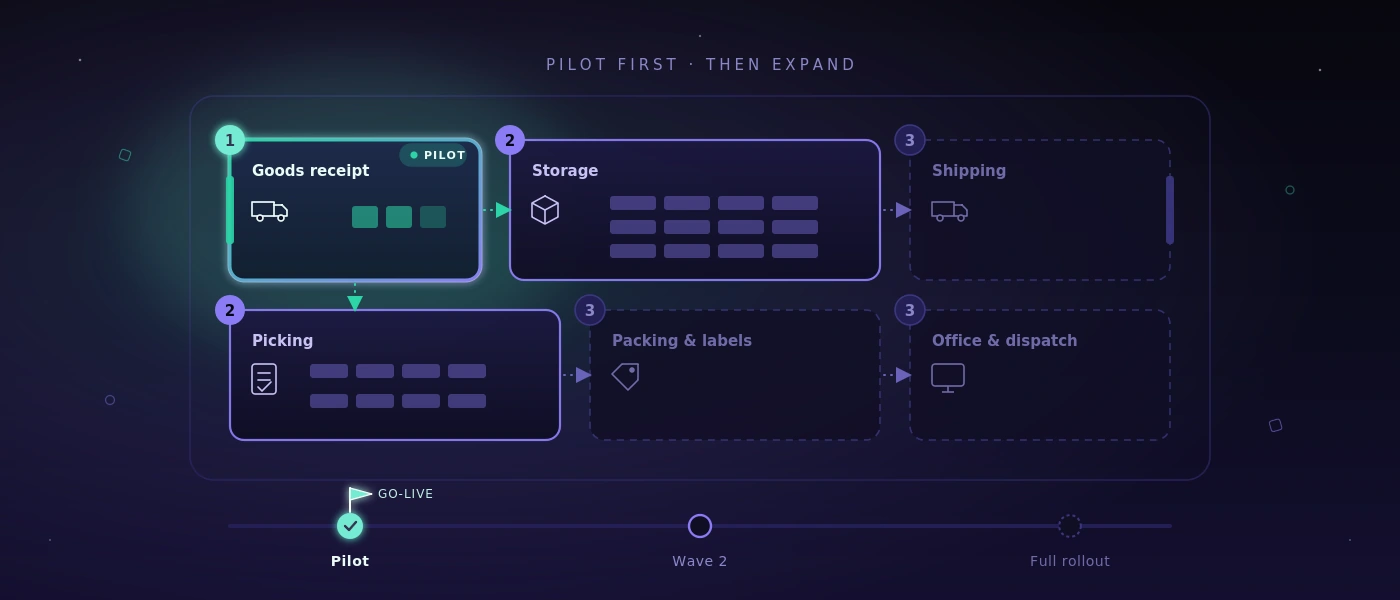
Bedre er en begrenset pilot med ett team, én prosessvariant eller et tydelig avgrenset stedsområde. I denne tiden kontrolleres det om registrering og godkjenninger fungerer, om begreper er forståelige og om unntakstilfeller lander rent. Viktig er å ikke bare samle tilbakemeldinger som en ønskeliste. Hver endring bør prøves mot nytten for gjennomløpstid, feilrate eller transparens.

Også nøkkeltall bør fastsettes tidlig. For eksempel kan behandlingstid per varemottak, antall åpne avvik, forespørsler om leveringsstatus eller korreksjonsbokføringer følges. Uten utgangsverdi forblir «føles raskere» den eneste vurderingen. Det kan stemme, men er ikke nok for en holdbar investeringsbeslutning.

Drift trenger en tydelig eier

SaaS reduserer teknisk innsats, men fritar ikke en bedrift fra ansvaret for sin egen prosess. Internt trengs noen som forvalter roller, samler tilbakemeldinger, oppdager opplæringsbehov og avgjør hvilke endringer som virkelig er nødvendige. Denne personen trenger ikke kunne programmere. Vedkommende bør imidlertid forstå arbeidsflyten og ha tilgang til de ansvarlige.

Like viktig er en kort, holdbar driftsdokumentasjon. Den forklarer ikke hvert skjermbilde, men besvarer spørsmålene som oppstår i hverdagen: hva gjøre ved en feilaktig bokføring? Hvem godkjenner nye brukere? Hvordan kommuniseres et avbrudd? Hvor ligger eksporterte data? Slik klarhet forhindrer at et digitalt system etter noen måneder igjen blir avhengig av personlige tilrop.

En god SaaS-løsning kjenner man derfor ikke igjen på hvor mange menypunkter den tilbyr. Den viser sin verdi når en ny kollega trygt kan behandle en sak, et avvik ikke forsvinner og en leder ser statusen uten å ringe tre personer. Nettopp etter denne målestokken bør Flow Web måles: ikke etter løfter, men etter en arbeidsdag som påviselig går roligere og mer pålitelig.

Permalenke →

Webutvikling med aktuelle rammeverk: hva bedrifter virkelig får ut av det

Webutvikling med aktuelle rammeverk: hva bedrifter virkelig får ut av det

Hvis et varemottak fortsatt pendler mellom papirskjema, telefonsamtale og tre Excel-filer, løser ikke et moderne frontend problemet alene. Webutvikling med aktuelle rammeverk er fornuftig når den synlig forenkler forløp: medarbeidere ser neste steg, data registreres bare én gang, og applikasjonen forblir forståelig vedlikeholdbar også etter den første go-live.

For små og mellomstore bedrifter er rammeverksspørsmålet derfor ingen trosspørsmål. Avgjørende er ikke om et grensesnitt bærer spesielt mange tekniske moteord. Avgjørende er om lagerbevegelser, ordrer, kontroller eller godkjenninger kommer pålitelig gjennom arbeidsdagen - også under tidspress, skiftbytter og svingende nettverksforbindelse.

Rammeverk er et middel, ikke et prosjektmål

Et rammeverk leverer en velprøvd struktur for gjentakende oppgaver: routing, skjemaer, rettighetsstyring, datatilgang, tester og visning av grensesnitt. Det reduserer ikke automatisk hver risiko. Men det forhindrer at et prosjekt gang på gang må finne opp grunnleggende funksjoner på nytt.

Ved en individuell webapplikasjon kan et moderne JavaScript-rammeverk for eksempel fornuftig avbilde interaktive skjermbilder: en plukkliste som fortløpende oppdaterer posisjoner, en ruteplanlegging med klare statusbytter eller en kontrollprotokoll som knytter bilder og kommentarer direkte til en sak. I backend sørger etablerte PHP-rammeverk for sporbare regler, tydelig adskilte ansvarsområder og konsistente grensesnitt mot databasen.

Det er spesielt relevant når en i utgangspunktet liten løsning blir et daglig brukt driftssystem for en prosess. Et inndataskjema for leveringsvarsler kan begynne oversiktlig. Så snart det oppdaterer lagerbeholdninger, skriver ut etiketter, tar hensyn til roller og kommuniserer med en transportør, trenger det en ren teknisk basis. Rammeverk hjelper til med å ikke forhandle om denne basisen på nytt ved hver utvidelse.

Hva aktuelle webrammeverk konkret gjør bedre

Verdien av moderne rammeverk ligger sjelden i spektakulære effekter. Den viser seg i de usynlige delene av en applikasjon. Skjemaer kan kontrollere inndata direkte, uten at feilaktige data oppdages først etter innsending. Rettigheter kan defineres sentralt, slik at en sjåfør ser annen informasjon enn disposisjonen. Endringer i en bestilling lagres sporbart, i stedet for stille å overskrive en tabellcelle.

På serversiden skaper et aktuelt miljø med PHP 8.4 og MySQL 8 et bæredyktig grunnlag for forretningskritisk logikk. Databasetransaksjoner forhindrer for eksempel at en beholdning reduseres mens den tilhørende bokføringen mislykkes. Unike nøkler og valideringsregler unngår duplikater. Bakgrunnsprosesser kan opprette dokumenter eller kalle grensesnitt uten at personen ved skjermen må vente.

Heller ikke sikkerhet er en funksjon i etterkant. Et tidsmessig rammeverk støtter sikker passordlagring, beskyttelse mot typiske inndataangrep, sporbare sesjoner og definerte kontolåsingsflyter. Likevel forblir gjennomføringen en prosjektoppgave: rettigheter må modelleres faglig riktig, og sensitive funksjoner trenger ekstra kontroller. Et rammeverk gir rekkverk, men ingen kunnskap om hvem i bedriften som kan gi hvilken godkjenning.

Å avgjøre webutvikling med aktuelle rammeverk riktig

Den beste teknologien oppstår ikke gjennom en liste over populære verktøy, men gjennom den faktiske bruken. En intern applikasjon for ti personer har andre krav enn en kundeportal med flere tusen samtidige tilganger. En lagerterminal med skanner trenger en annen betjeningslogikk enn en ledelsesanalyse på skrivebordet.

Derfor begynner en fornuftig beslutning med konkrete spørsmål: hvilke forløp koster i dag målbart tid? Hvilke data overføres flere ganger? Hvor oppstår feil fordi informasjon blir synlig for sent? Hvilken eksisterende tabell fungerer godt nok og bør til å begynne med bli? Nettopp det siste punktet beskytter mot dyre digitaliseringsprosjekter uten operativ nytte.

For mange individuelle forretningsapplikasjoner er et servergjengitt system med målrettede interaktive komponenter det fornuftigste valget. Det laster raskt, er oversiktlig å drifte og unngår unødvendig kompleksitet. En fullstendig frikoblet single-page-applikasjon kan derimot være passende når grensesnittet håndterer svært mange dynamiske tilstander, må fungere offline eller senere skal stille de samme funksjonene til rådighet også for en mobilapp.

Begge kan være faglig riktige. Spørsmålet lyder ikke: hvilket rammeverk er mest moderne? Det lyder: hvilken arkitektur er om to år fortsatt trygt utvidbar, testbar og forståelig for eget team?

Når mindre teknikk er bedre teknikk

Ikke hver prosess trenger et komplekst frontend. Et slankt inndataskjema for interne bestillinger kan være raskere, mer stabilt og rimeligere enn et omstendelig animert grensesnitt. Hvis en Excel-fil bare vedlikeholdes én gang i måneden og ikke forårsaker feil, er den muligens fortsatt det riktige verktøyet.

Kompleksitet lønner seg først når den fjerner reell friksjon. Det kan være tilfellet når ordrer tastes inn flere ganger, leveringsstatus må etterspørres per telefon eller ingen er sikker på hvilken versjon av et dokument som gjelder. Da skaper en sentral applikasjon en klar nytte: ett datagrunnlag, entydige ansvarsområder og færre forespørsler.

Vedlikeholdbarhet begynner før første kodelinje

Rammeverk blir ofte sett som akseleratorer. Det stemmer bare hvis de faglige reglene på forhånd er tilstrekkelig klare. En utvikler kan bygge en tilstandsmaskin teknisk rent. Men om statusrekkefølgen virkelig passer til prosessen, avgjøres ved kartleggingen: når regnes varer som mottatt? Hvem får lukke et avvik? Hva skjer ved en delleveranse?

Disse beslutningene hører dokumentert, i likhet med grensesnitt, datafelt og unntak. Det gjør ikke prosjekter langsommere. Det reduserer senere diskusjoner, fordi det blir synlig hvilken regel som ble bevisst gjennomført og hvilken antakelse som fortsatt er åpen.

Vedlikeholdbarhet viser seg også i små disipliner. Databaseendringer må versjoneres. Driftsettingssteg må dokumenteres. Feilmeldinger skal være brukbare for drift og utvikling uten å avsløre konfidensielle detaljer. Automatiserte tester kontrollerer ved hver endring sentrale forløp, for eksempel opprettelsen av en ordre, beregningen av en mengde eller utskriften av en følgeseddel.

Ved kritiske applikasjoner er ikke én enkelt testtype nok. Enhetstester sikrer enkeltregler, integrasjonstester kontrollerer samspillet med database og grensesnitt, og ende-til-ende-tester spiller av virkelige betjeningsveier i nettleseren. For web- og Windows-applikasjoner kan et selvhostet testmiljø i tillegg levere skjermbilder, kjøringsprotokoller og forståelige vurderinger, uten å unødig gi interne testdata til eksterne skytjenester.

Ytelse oppstår fra arkitektur og datamodell

Et moderne grensesnitt blir ikke raskt fordi det bruker et aktuelt rammeverk. Trege databasespørringer, overdimensjonerte bilder eller uklare grensesnitt forblir trege, uavhengig av frontend. Spesielt ved lister med ordrer, artikler eller bevegelsesdata avgjør datamodellen den opplevde hastigheten.

Rene indekser i MySQL 8, paginerte spørringer og bevisst lastede data er ofte mer effektive enn senere optimalisering i grensesnittet. Like viktig er et tydelig cachingkonsept. Stamdata kan under visse omstendigheter bufres, aktuelle beholdninger eller godkjenningsstatus derimot ikke blindt. Her finnes ingen generell regel, fordi datas faglige betydning bestemmer hvor aktuelle de må være.

Responsiv utforming hører også med til den tekniske planleggingen. På kontorskjermen kan en bred tabell være fornuftig. På en håndskanner eller et nettbrett i lageret trenger den samme informasjonen store trykkflater, korte veier og en visning som forblir brukbar også med hansker eller i dårlig lys. Pure fluidity meets ultimate performance betyr i denne sammenhengen ikke mest mulig bevegelse på skjermen. Det betyr at applikasjonen fungerer uten friksjon på enheten som faktisk brukes i prosessen.

Den fornuftige veien fra idé til drift

Et solid webprosjekt starter med en begrenset, etterprøvbar kjerne. I stedet for å automatisere hvert tenkelig unntak på forhånd, velges en prosess som forekommer ofte og forårsaker merkbar innsats. Etter første bruk viser virkelige data og tilbakemeldinger hvilken utvidelse som virkelig har neste prioritet.

Den tekniske overleveringen bør ikke skje først på slutten. Ansvar for hosting, sikkerhetskopier, overvåking, oppdateringer og tilgangsrettigheter må avklares tidlig. Et system er bare så pålitelig som driften av det. Den som daglig trenger en applikasjon til forsendelse eller ordrebehandling, trenger definerte gjenopprettingsveier og et klart svar på hva som skjer ved en forstyrrelse.

softify.pro satser derfor på vedlikeholdbare teknologier, dokumentert levering og direkte teknisk ansvar i stedet for kortlivede rammeverksmoter. Det er ingen magisk snarvei. Det skaper forutsetningen for at en applikasjon etter lanseringen fortsetter å virke, kan videreutvikles og ikke blir det neste skjøre spesialtilfellet.

Den rette webapplikasjonen føles i beste fall ikke som et nytt IT-prosjekt. Den føles som et forløp som endelig fungerer uten omveier - med nok teknisk substans til å ta imot også den neste endringen i driften med ro.

Permalenke →

Planlegge en programvareutrulling: slik lykkes innføringen under løpende drift

Planlegge en programvareutrulling: slik lykkes innføringen under løpende drift

Et nytt system mislykkes sjelden fordi en knapp mangler. Det mislykkes mandag morgen: morgenskiftet finner ikke varemottaket, en følgeseddel skrives ut to ganger eller en Excel-fil blir plutselig den uoffisielle sannheten. Den som vil planlegge en programvareutrulling, må derfor ikke bare innføre funksjoner, men sikre den reelle driften.

Nettopp i lager, verksted, disposisjon og administrasjon er en utrulling ikke en IT-avtale. Den endrer håndgrep, ansvar og informasjonsveier. En god innføring holder arbeidet i bevegelse, gjør feil synlige tidlig og gir medarbeidere et klart svar på det avgjørende spørsmålet: hva gjør jeg annerledes fra i morgen?

Utrullingen begynner før den første opplæringen

Mange prosjekter starter med en funksjonsliste: registrere ordrer, bokføre lagerbevegelser, skrive ut forsendelsesetiketter, planlegge ruter. Det er nødvendig, men ikke nok. Før start må det være avklart hvilke prosesser som faktisk skal gå via det nye systemet den første produktive dagen - og hvilke som bevisst ikke skal det ennå.

Denne avgrensningen er ikke et tegn på ufullstendighet. Den reduserer risiko. Hvis en mellomstor bedrift hittil har koordinert varemottak via papir, telefon og tabeller, trenger den ikke første dag samtidig å digitalisere hele lagerstyringen, returhåndteringen, turplanleggingen og leverandørvurderingen. Et fornuftig første omfang kunne ligge i varemottaket, entydige lagerbevegelser og utskrift av leveringsdokumenter.

Avgjørende er å beskrive målprosessen konkret. Ikke: «Varemottaket blir digitalt.» Men: «Medarbeideren skanner leveransen, kontrollerer mengde og tilstand, tildeler en lagerplass og oppretter ved avvik en sak for innkjøp.» Først på dette nivået blir åpne spørsmål synlige: hva skjer ved manglende bestilling? Hvem får korrigere mengder? Får en leveranse uten etikett lagres inn?

Å planlegge en programvareutrulling betyr: prioritere kritiske flyter

Ikke hver prosess har samme betydning. Et utfall innen stamdatavedlikehold kan være ubehagelig. Et utfall ved forsendelse, plukking eller fakturagodkjenning kan blokkere en hel dags arbeid. Derfor trenger utrullingen en prioritering etter driftsrisiko, ikke etter rekkefølgen i kravspesifikasjonen.

En enkel inndeling har vist seg å fungere: forretningskritisk, viktig og utsettbar. Forretningskritiske er alle flyter som beveger varer, penger eller bindende kundekommunikasjon. Viktige er funksjoner som gjør hverdagen raskere, men hvis bortfall midlertidig kan dempes manuelt. Utsettbare er komfortfunksjoner, sjeldne spesialtilfeller eller evalueringer som til å begynne med fortsatt kan komme fra en eksisterende kilde.

Denne inndelingen påvirker testdybden. For en kritisk forsendelsesprosess er det ikke nok å klikke seg gjennom én enkelt ordre vellykket. Testes må også delleveranser, kanselleringer, manglende skrivere, feil adresser, parallell behandling og overleveringen til transportøren. For en sjelden brukt statistikkfunksjon kan en senere testsyklus være passende.

Gjør suksesskriterier målbare på forhånd

«Applikasjonen kjører» er ikke et akseptkriterium. Bedre er etterprøvbare utsagn: et varemottak på 30 posisjoner kan bokføres innen ti minutter. Forsendelsesetiketter skrives ut på den tiltenkte arbeidsplassen. Lagerendringer vises umiddelbart i disposisjonen. En sperret brukerkonto kan bare reaktiveres via den definerte godkjenningsprosessen.

Slike kriterier forbinder fagavdeling og utvikling. De forhindrer også at godkjenningen blir en samling vage inntrykk. Ikke hver tilbakemelding må være løst før go-live. Men hver tilbakemelding trenger en innplassering: kritisk feil, relevant forbedring eller punkt for et senere utbyggingstrinn.

Datamigrering: bare rene data fortjener tillit

Gamle data undervurderes ofte. I tabeller finnes doble artikkelnumre, ulike enheter, utløpte kundeadresser og lagerbeholdninger hvis opprinnelse ingen lenger kan forklare. Den som overtar disse dataene uten kontroll, flytter gammel uklarhet inn i et nytt system - bare med et bedre grensesnitt.

Før migreringen bør det fastsettes hvilke data som virkelig trengs. Ofte er aktuelle artikler, aktive kunder, åpne ordrer, relevante leverandører og kontrollerte inngangsbeholdninger fornuftige. Historiske poster trenger ikke nødvendigvis å flytte helt over til den nye applikasjonen. Det kan holde å arkivere dem lesbart, hvis de forblir nødvendige for bevis eller forespørsler.

Spesielt viktig er en prøvelasting. Da importeres data ikke bare teknisk, men kontrolleres faglig: stemmer mengder, enheter og tilordninger? Er obligatoriske felt komplette? Lar typiske ordrer seg behandle riktig med dem? For go-live trengs deretter en klar stoppdato. Fra når brukes hvilket ledende system? Uten denne regelen oppstår dobbeltvedlikehold og motstridende beholdninger.

Pilotdrift i stedet for en stor bryter

En big bang kan være fornuftig hvis et lite team bruker en tydelig avgrenset prosess og den gamle og den nye løsningen ikke kan fungere parallelt. I de fleste operative miljøer er pilotdrift likevel det mer kontrollerbare valget.

Piloten bør arbeide med reelle tilfeller, men innenfor en begrenset ramme: ett lagerområde, ett skift, én produktgruppe eller et utvalgt team. Avgjørende er at pilotgruppen ikke bare omfatter spesielt teknikkinteresserte medarbeidere. Den bør gjenspeile den senere hverdagen realistisk, inkludert menneskene som arbeider under tidspress og har berettigede innvendinger.

I pilotdriften viser det seg om skannere, skrivere, nettverk og rettigheter fungerer på den faktiske arbeidsplassen. Likeledes blir prosesshull synlige som ingen nevnte i møter. Kanskje settes varer i hverdagen først på en mellomplass. Kanskje trenger sjåfører en annen følgeseddel enn administrasjonen. Slike erkjennelser er ikke et tilbakeskritt. De er grunnen til å gjennomføre piloten før den brede starten.

Opplæring som arbeidssituasjon, ikke som programvarerunde

En opplæring som bare forklarer menypunkter, skaper lite trygghet. Medarbeidere må lære på sine oppgaver: «Dere tar imot en skadet leveranse», «Dere plukker en hastig ordre», «Dere korrigerer en feilbokført mengde». Konteksten setter seg fordi den tilsvarer arbeidshverdagen.

Korte opplæringer nær go-live er som regel mer effektive enn én lang avtale uker i forveien. Dessuten hjelper kortfattede arbeidsinstrukser direkte på arbeidsplassen. De bør ikke forklare hele systemet, men vise de hyppigste forløpene, klare ansvarsområder og veien ved forstyrrelser.

Utpek dessuten kontaktpersoner per område. Disse personene trenger ikke selv å løse hvert tekniske problem. Men de bør kunne avgjøre om det dreier seg om en betjeningsfeil, en faglig uklarhet eller en faktisk systemfeil. Det beskytter prosjektteamet mot ustrukturerte tilrop og fremskynder hjelpen til skiftet.

Go-live trenger en driftsplan

Go-live-dagen trenger mer enn et klokkeslett. Definer hvem som avgjør faglig, hvem som er ansvarlig for tekniske endringer og via hvilken kanal forstyrrelser meldes. Ved kritiske flyter bør det være synlig om sentrale funksjoner fungerer: pålogging, rettigheter, datainnhenting, grensesnitt, utskrift og sikkerhetskopiering.

Også en reserveplan hører med. Det betyr ikke at man ved minste problem straks vender helt tilbake til den gamle verden. Det betyr å bestemme på forhånd hvilken forstyrrelse som rettferdiggjør et stopp, hvordan ordrer om nødvendig dokumenteres og hvordan man etterpå registrerer rent. Et papirskjema noen timer kan være fornuftig. En permanent parallellføring uten ende er det ikke.

Tekniske detaljer teller her: er tilganger opprettet i tide? Virker roller og kontolåsingsregler riktig? Er etikettskrivere koblet til de riktige malene? Finnes det en testet sikkerhetskopi av databasen? Ved individuelt utviklede applikasjoner hører dokumenterte driftsettinger, sporbare versjonsstatuser og en klar vei for feilretting til standarden.

De første ukene avgjør aksepten

Etter starten begynner fasen der en applikasjon enten blir et arbeidsmiddel eller et uønsket ekstra steg. Planlegg derfor korte daglige tilbakemeldingsrunder. Hvilke feil oppstår gjentatte ganger? Hvor oppstår omveier? Hvilke felt misforstås? Hvilken evaluering mangler en leder egentlig?

Ikke hver observasjon krever en umiddelbar endring. Noen problemer løses gjennom mer presise arbeidsregler eller bedre opplæring. Andre viser reelle svakheter i prosessen eller applikasjonen. Kunsten er å ikke forveksle de to. Et system bør ikke uten grunn gjøre eksisterende fungerende forløp mer kompliserte. Hvis en velholdt tabell for et sjeldent spesialtilfelle fortsatt er den bedre løsningen, får den bli.

Mål effekten ved hjelp av noen få konkrete nøkkeltall: behandlingstid per forløp, antall forespørsler, feilbokføringer, omutskrifter, åpne ordrer eller lagerdifferanser. Først disse verdiene viser om utrullingen faktisk forbedrer driften - i stedet for bare å innføre nye skjermbilder.

En god utrulling føles etter noen uker ikke lenger som et prosjekt. Den blir en pålitelig arbeidsrutine: de riktige dataene står der de trengs, unntak er sporbare og team må ringe mindre etter informasjon. Akkurat det bør planleggingen sikte mot - ikke en spektakulær startdag, men en roligere, bedre styrbar hverdag.

Permalenke →

Planlegge Multiplatform Application Development: først prosessen, deretter plattformen

Planlegge Multiplatform Application Development: først prosessen, deretter plattformen

En lagersjef bekrefter et varemottak på håndskanneren. Disposisjonen kontrollerer den samme prosessen i nettleseren. En sjåfør trenger leveringsstatusen underveis på smarttelefonen. Multiplatform application development høres i dette øyeblikket ut som et teknisk spørsmål. I virkeligheten handler det først om en driftsflyt: hvilket arbeid må gjøres hvor, med hvilken pålitelighet og med hvilken enhet?

For små og mellomstore bedrifter er det riktige svaret sjelden: vi bygger alt nativt for hver plattform. Oftere lyder det: vi definerer en felles prosess, velger målrettet de nødvendige brukergrensesnittene og unngår dobbel logikk. Det sparer ikke bare utviklingsbudsjett. Det forhindrer også at lager, kontor og feltservice arbeider med ulike datagrunnlag.

Hva Multiplatform Application Development skal oppnå

Multiplatform Application Development betegner utviklingen av en applikasjon som kan brukes i flere miljøer, for eksempel i nettleseren, på iOS og Android eller på Windows-skrivebordssystemer. Begrepet reduseres ofte til spørsmålet om én enkelt kodebase kan skape flere apper. Det er bare en del av beslutningen.

For operative systemer teller først og fremst om applikasjonen fungerer der den brukes. Et varemottak kan trenge et kamera for å lese strekkoder, store betjeningselementer for hansker og en brukbar reaksjon ved ustabil WLAN-dekning. Administrasjonen trenger derimot tabeller, filtre, rettighetskonsepter og sporbare endringslogger. En sjåfør trenger en redusert visning, ikke samme grensesnitt som disposisjonen.

Et felles teknisk grunnlag kan forene disse kravene på en fornuftig måte. Men det må ikke føre til at hver plattform betjenes som et dårlig kompromiss. Den beste felles koden er verdiløs hvis medarbeidere tar omveier fordi applikasjonen ikke avspeiler deres faktiske arbeidsflyt.

Først bestemme prosessen, deretter plattformen

Før team snakker om rammeverk, bør de granske ett konkret forløp fra begynnelse til slutt. Ta en levering: ordren kommer inn, varer plukkes, en følgeseddel opprettes, overleveringen bekreftes og statusen rapporteres tilbake til salg eller kundeservice. Hvor oppstår mediebruddet i dag? Hvor noteres noe på papir, tastes inn senere eller etterspørres per telefon?

Denne observasjonen skiller ekte plattformkrav fra ønskelister. Hvis bare to medarbeidere på kontoret bruker en funksjon, er et godt laget webgrensesnitt som regel nok. Hvis ti personer på lagergulvet gjør bokføringer, kan et mobilt, skannervennlig grensesnitt utgjøre forskjellen. Må et eksisterende Windows-program arbeide med spesialmaskinvare, kan en skrivebordsintegrasjon være nødvendig.

Ikke hver funksjon hører hjemme på hver enhet. Det er ingen mangel ved en multiplattformløsning, men et tegn på rene produktbeslutninger. Felles data og forretningsregler betyr ikke nødvendigvis identiske skjermbilder.

De tre spørsmålene som avklarer kostnad og nytte

Det første spørsmålet lyder: hvilke enheter er allerede i bruk, og hvor lenge forblir de det? En bedrift med administrerte Windows-terminaler har andre krav enn en feltservice med private smarttelefoner. Det andre lyder: hva skjer uten nettverksforbindelse? Offline-evne øker innsatsen betydelig, fordi data må lagres lokalt, synkroniseres senere og håndteres rent ved konflikter. Den er fornuftig hvis prosessen ellers stopper opp - ikke som standardutstyr.

Det tredje spørsmålet gjelder følgene av et utfall. Kan en medarbeider registrere en bokføring i etterkant, eller henger en forsendelsesetikett, en lagerbeholdning eller en sikkerhetsgodkjenning på den? Jo mer kritisk prosessen er, desto sterkere må rettigheter, kontrollregler, gjentakbarhet og logging planlegges.

En arkitektur som ikke faller sammen ved den andre plattformen

Ved en bærekraftig løsning ligger forretningslogikken ikke spredt i flere grensesnitt. Lagerkontroller, statusbytter, nummerserier, rettigheter og dokumentgenerering trenger et sentralt, testet grunnlag. Nettleser, mobilapplikasjon og skrivebordsklient får tilgang via klart definerte grensesnitt.

For mange interne forretningsprosesser er en moderne webapplikasjon det mest økonomiske utgangspunktet. Den kan oppdateres sentralt, krever ingen installasjon på hver arbeidsplass og fungerer på PC, nettbrett og smarttelefon. Med PHP 8.4, moderne JavaScript og MySQL 8 kan det bygges et vedlikeholdbart fundament, forutsatt at datamodell, tilgangsrettigheter og utrulling ikke vurderes først kort før go-live.

En installerbar mobil- eller skrivebordsapplikasjon legges til når den gir en klar fordel: dyp integrasjon med skanner, skriver eller kamera, pålitelig offline-drift, spesielle bakgrunnsfunksjoner eller krav fra enhetsadministrasjonen. Det er en målrettet utbygging, ikke et mål i seg selv.

En vanlig feil er fullstendig gjenbruk av brukergrensesnittet for enhver pris. Teknisk kan det se attraktivt ut. I praksis oppstår små tekster på store skjermer, overbelastede skjemaer på smarttelefoner eller betjening som ikke passer til plattformen. Bedre er å dele datamodell, regler og komponenter der det er fornuftig, mens betjeningen tilpasses den respektive konteksten.

Datakonsistens er viktigere enn en felles kodebase

Flere plattformer øker faren for motstridende data. En ordre endres på kontoret mens en sjåfør fortsatt ser en gammel versjon på enheten sin. To medarbeidere bokfører samtidig den samme artikkelbeholdningen. En offline-enhet sender endringene sine tilbake timer senere. Disse tilfellene er ikke et randtema, men kjernen i arkitekturen.

Systemet trenger derfor entydige identiteter, tidsstempler, sporbare tilstandsbytter og regler for konflikter. Ved en leveringsstatus kan den sist bekreftede endringen være tilstrekkelig. Ved lagerbeholdninger er det ofte for grovt. Der må det være klart hvilken bevegelse som ble bokført, fra hvilken lagerplass den stammer og om en korrigering må begrunnes.

Også rettigheter bør reguleres sentralt. En medarbeider kan kanskje registrere varemottak, men ikke godkjenne lagerkorrigeringer. En ekstern sjåfør skal bare se sin egen tur. Sesjonsvarighet, flerfaktorautentisering for kritiske roller og kontolåsingsflyter er ikke dekorative sikkerhetsfunksjoner. De beskytter konkrete forløp og gjør ansvar synlig.

Teste Multiplatform Application Development slik man faktisk arbeider

En applikasjon kan starte på tre operativsystemer og likevel mislykkes i drift. Avgjørende er forløpene under reelle forhold: skanneren reagerer for sakte, en etikettskriver er ikke tilgjengelig, en rettighet slår ikke inn etter et rollebytte, eller en synkronisering skaper doble bokføringer.

Derfor bør kritiske prosesser kontrolleres automatisert. Dit hører innlogging og sperreatferd, ordreregistrering, lagerbevegelser, dokumentopprettelse og behandlingen av feilaktige inndata. For web- og Windows-applikasjoner kan gjentakende tester kjøres på en selvhostet infrastruktur. Det er spesielt relevant hvis skjermbilder, interne ordredata eller testtilganger ikke skal gis videre til eksterne skytjenester.

Automatisering erstatter ikke kontroll av mennesker på lagergulvet. Men den sørger for at kjente forløp kontrolleres gang på gang etter endringer. Gode testrapporter nevner ikke bare en teknisk feil, men den berørte prosessen: leveringsbevis kan ikke opprettes, brukerkonto forblir sperret etter vellykket godkjenning eller turdata oppdateres ikke.

Når en plattformstrategi er for mye

Noen bedrifter trenger ingen egen app. Hvis en stabil nettlesertilgang er nok, flyten sjelden er mobil og antallet brukere forblir oversiktlig, er en responsiv webapplikasjon ofte det fornuftigste valget. Den reduserer vedlikeholdsinnsats, distribusjonsproblemer og antallet mulige feilkilder.

Heller ikke en eksisterende tabell må erstattes umiddelbart. Hvis den bare fungerer som enkel evaluering, vedlikeholdes av én person og ikke skaper feilutsatte overleveringer, kan den oppfylle sitt formål. Tidspunktet for et system er nådd når kunnskap sitter i enkeltes hoder, versjoner glir fra hverandre, oppfølgingsspørsmål øker eller et forløp ikke lenger kan spores pålitelig.

Omvendt blir en slank plattformstrategi raskt for liten når medarbeidere må arbeide offline, maskinvare kobles til eller kunder og partnere trenger kontrollert tilgang. Da lønner det seg å finansiere de tilkommende kravene bevisst, i stedet for å bygge dem på senere under tidspress.

Begynn med en solid pilot

En god start er ikke en funksjonskatalog med hundre punkter, men en fullstendig, målbar flyt. For eksempel: registrere varemottak, oppdatere lager, dokumentere avvik og opprette en oppgave for avklaring. Denne piloten viser tidlig om datamodell, enheter, rettigheter og betjening passer sammen.

Deretter kan løsningen vokse i fornuftige trinn: plukking, forsendelse, turplanlegging eller evalueringer. Hver utvidelse bør bestå det samme spørsmålet: forkorter den en ekte flyt, reduserer den feil eller skaper den pålitelig åpenhet? Hvis ikke, kan den vente.

Den mest fornuftige plattformen er til slutt ikke den med flest tekniske alternativer. Det er den der et team begynner arbeidet raskere om morgenen, spør mindre under skiftet og kan spore om kvelden hva som faktisk skjedde.

Permalenke →

Å vurdere Test Automation Results riktig

Å vurdere Test Automation Results riktig

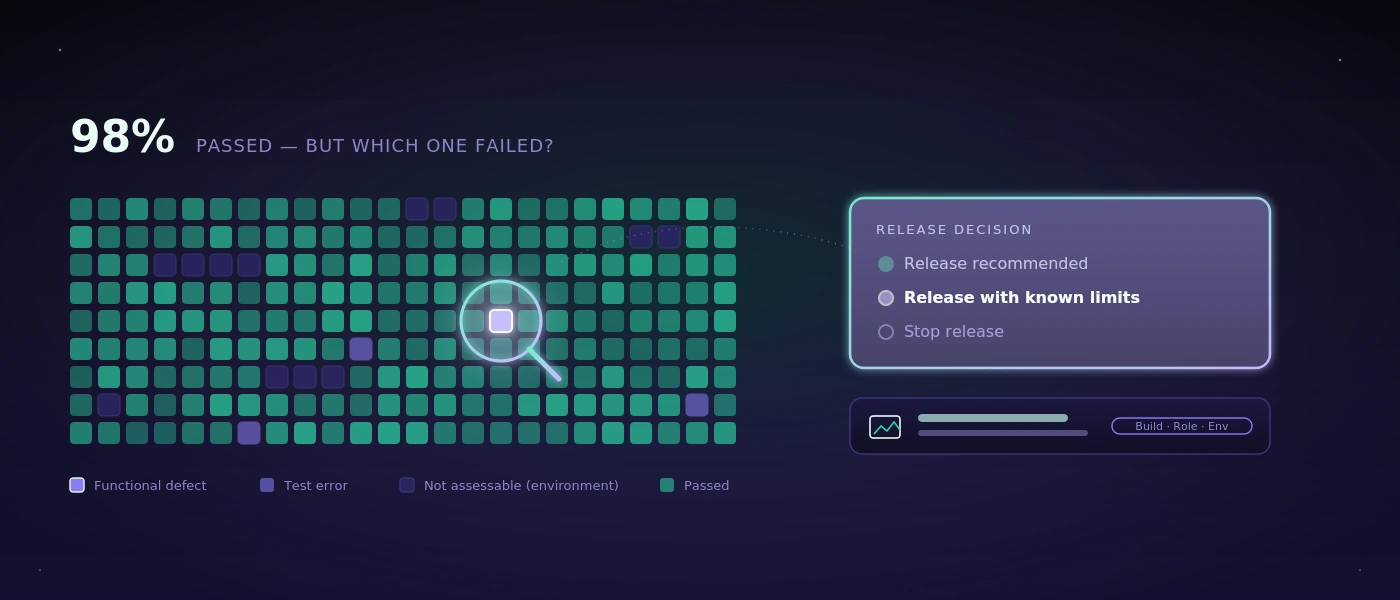
En regresjonstest kan om morgenen ende med 98 prosent vellykkede tilfeller og likevel ikke være gode nyheter. Kanskje er den mislykkede testen akkurat innloggingen til en storkunde. Kanskje ble 40 tester hoppet over fordi testmiljøet ikke var tilgjengelig. Eller kjøringen var grønn, men sjekket bare om knapper finnes, ikke om en ordre faktisk lagres, en følgeseddel genereres og lageret justeres riktig. Test automation results er ingen kvalitetspåstand så lenge konteksten deres mangler.

For QA-ledelse, utvikling og fagavdelinger ligger det egentlige arbeidet derfor ikke bare i å automatisere tester. Avgjørende er å tilrettelegge resultatene slik at pålitelige beslutninger oppstår: kan en utgivelse rulles ut? Må en feil håndteres umiddelbart? Er feilen ny, gjentatt eller bare et problem i testmiljøet? Og finnes det bevis som også en fagavdeling uten testkode kan følge?

Hva Test Automation Results egentlig sier

Det enkleste nøkkeltallet lyder: bestått eller ikke bestått. Det er nyttig, men sjelden tilstrekkelig. En høy suksessandel kan skape tillit hvis testene dekker kritiske flyter, testdataene er plausible og miljøet ligner den senere driften. Mangler en av disse faktorene, forblir tallet først og fremst et signal om at en automatisert kjøring ble utført.

Ved forretningskritiske applikasjoner veier andre spørsmål tyngre. I en lagerløsning er ikke hvert skjermbilde like viktig. En visningsfeil i en intern hjelpetekst kan vente. En feil som bokfører feil mengde ved varemottak eller genererer en forsendelsesetikett uten mottakeradresse, kan ikke det. Gode testresultater veier derfor risikoer i stedet for å behandle alle tilfeller likt.

Heller ikke en mislykket test er automatisk en produktfeil. Den kan utløses av utløpt påloggingsinformasjon, en sperret testrolle, utilgjengelige grensesnitt, endrede testdata eller et tregt miljø. Den som ikke skiller disse årsakene, produserer støy. Teamet bruker da tid på falske alarmer mens ekte feil forsvinner blant røde statusmeldinger.

Fire statustyper i stedet for én rød liste

I praksis har en tydelig inndeling vist seg å fungere: faglig feil, teknisk testfeil, miljøproblem og forventet endring. En faglig feil betyr at applikasjonen bryter et definert krav. En teknisk testfeil peker heller mot selve testen, for eksempel en selektor som ikke lenger passer etter et bevisst endret grensesnitt.

Et miljøproblem foreligger når for eksempel et testsystem eller et tilkoblet grensesnitt ikke er tilgjengelig. Forventede endringer oppstår når en prosess er bevisst tilpasset, men automatiseringen fortsatt kontrollerer den gamle måltilstanden. Disse kategoriene forhindrer ikke enhver diskusjon. Men de sørger for at diskusjonen begynner på riktig punkt.

Fra testkjøringer til beslutningsklare rapporter

En brukbar rapport svarer ikke bare på at noe mislyktes, men hva som skjedde, hvor alvorlig det er og om feilen virker reproduserbar. Det krever mer enn en liste med testnavn og tidsstempler.

Til hver relevant kjøring hører den kontrollerte builden, testmiljøet, rollen som ble brukt, sentrale testdata samt start- og sluttid. Særlig ved Windows-skrivebordsapplikasjoner eller komplekse nettplattformer trengs denne informasjonen for å avgrense forskjeller. En feil som bare oppstår under en begrenset lagerrolle, er noe annet enn en feil som blokkerer hver pålogging.

Meningsfulle resultater inneholder dessuten sporbare bevis: skjermbilder, innspilte trinn, feilmeldinger og ved behov tekniske logger. Et skjermbilde alene kan imidlertid lure. Det viser et øyeblikk, ikke årsaken. Kombinasjonen av trinnrekkefølge, synlig tilstand og forventet reaksjon er betydelig mer nyttig.

KI-støttede systemer kan omforme disse bevisene til forståelige vurderinger. Hos COCO for eksempel kjøres tester på en egen, selvhostet KI-server. Evalueringen kan forklare at en ordre riktignok ble opprettet, men at den forventede statusendringen uteble, og direkte knytte opptaket av kjøringen til dette. For sikkerhetsbevisste team er det relevant hvor skjermbilder, applikasjonsdata og testtrafikk behandles. Lokal kontroll er ikke automatisk nødvendig, men kan ved interne applikasjoner og sensitive data være den fornuftigere veien enn en ekstern skytjeneste.

Riktig detaljnivå for ulike mottakere

Utviklingsteam trenger feilmeldinger, tekniske trinn og så presise anvisninger som mulig for reproduksjon. En operations manager trenger derimot først den berørte funksjonen, forretningsrisikoen og en klar uttalelse om driftsevnen. Begge perspektiver må kunne oppstå fra samme kjøring, uten at noen manuelt må overføre resultater til presentasjoner.

En god rapport begynner derfor med et kort beslutningsnivå: utgivelse anbefalt, utgivelse med kjente begrensninger eller stopp utgivelsen. Under står de kritiske avvikene med prioritet og bevis. De tekniske detaljene følger først etterpå. Det er ingen forenkling på bekostning av nøyaktighet, men en ren adskillelse av informasjonsbehov.

Måle dekning uten å innbille seg sikkerhet

Testdekning fremstilles ofte som en prosentverdi. Denne verdien er nyttig når det er klart hva den måler. Kodedekning viser for eksempel hvilke deler av programkoden som ble kjørt under tester. Det beviser ikke at en forretningsprosess fungerer riktig. En test kan berøre mange kodelinjer og likevel aldri kontrollere om en feil leveringsadresse dukker opp på dokumentet.

For fagavdelinger er prosessdekning ofte mer talende. Den beskriver hvilke reelle flyter som er beskyttet: registrere en ordre, reservere lager, bokføre en delleveranse, ta imot en retur eller godkjenne en faktura. Spesielt verdifulle er overgangene mellom systemer og roller, for der oppstår ofte feil: ved import av en bestilling, ved utskrift av en etikett eller ved bytte fra kontor til lagerterminal.

Prioriter ikke etter antall mulige tester, men etter skadevirkning og endringsfrekvens. En sjelden brukt prosess med høy økonomisk eller juridisk risiko fortjener ofte automatisering tidligere enn en ofte brukt, men harmløs visning. Omvendt kan en stabil, lite kritisk flyt fortsatt klare seg med en kort manuell kontroll. Ikke hver kontroll må automatiseres bare fordi den kan automatiseres.

Ustabile tester er et eget kvalitetsproblem

Tester som uten gjenkjennelig produktendring av og til består og av og til mislykkes, kalles ofte flaky. De skader tilliten raskere enn en permanent rød test. Så snart team refleksmessig starter røde resultater på nytt, mister automatiseringen sin varslingsfunksjon.

Årsakene er som regel konkrete: faste ventetider, felles brukte testdata, parallelle tilganger, asynkron behandling eller et miljø som ikke tilbakestilles. En kort pause på tre sekunder i testen kan tilfeldigvis hjelpe, men er ingen løsning. Bedre er å vente på en påviselig tilstand, gjøre testdata entydige og isolere flyter fra hverandre.

Ikke all ustabilitet kan unngås helt. Eksterne grensesnitt kan svinge, og reell infrastruktur har utfall. Da bør rapporten tydelig markere om en test ikke lot seg vurdere på grunn av en ekstern avhengighet. En gjentatt kjøring kan være fornuftig for diagnose, men må ikke gjøre det første funnet usynlig.

Et fornuftig forløp etter hver testkjøring

Etter en automatisert kjøring bør ikke hvert resultat umiddelbart behandles likt. Først kontrolleres blokkerende feil og kritiske tester som ikke lot seg vurdere. Deretter følger innplasseringen av nye avvik mot kjente, aksepterte problemer. Først da er en utgivelsesbeslutning holdbar.

Fastsatte terskelverdier hjelper, men de må passe til prosessen. For eksempel kan en mislykket test i betalings- eller tilgangsflyten utløse et umiddelbart stopp. Ved et rent kosmetisk avvik kan et dokumentert unntak være forsvarlig. Slike regler bør ikke først oppstå under tidspress før en utgivelse.

Like viktig er tilbakemeldingen: hver produksjonsfeil som testene ikke oppdaget, er en anledning til å sjekke om et scenario, en testdatavariant eller et kontrollpunkt mangler. Målet er ikke å hope opp flest mulig tester. Det er å bygge bedre sikring, målrettet, ut fra reelle feil.

De mest nyttige testresultatene er til slutt ikke de med den grønneste oversikten. Det er de der en ansvarlig mandag morgen kan forstå hva som ble kontrollert, hvilken risiko som gjenstår og hvilken handling som nå er fornuftig.

Permalenke →

Inventory Discrepancy Causes: vanlige årsaker til lagerdifferanser

Inventory Discrepancy Causes: vanlige årsaker til lagerdifferanser

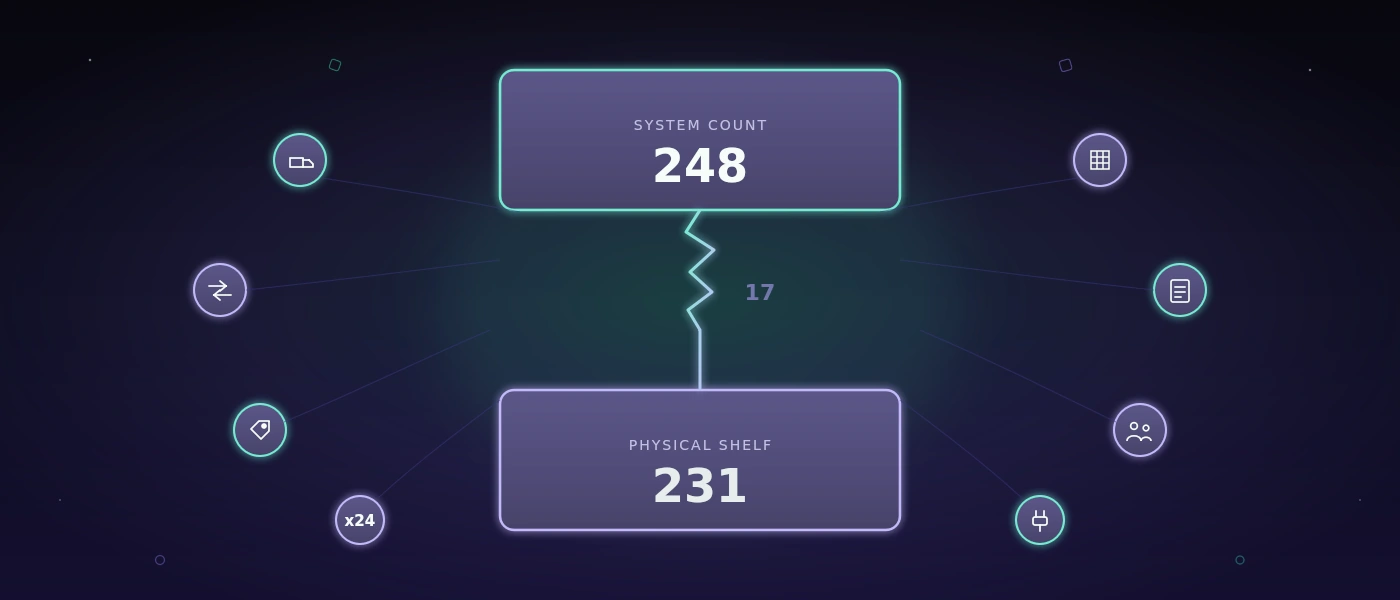
Lageret i systemet sier 248 stykker, på hyllen ligger det 231. Disse 17 enhetene virker først som en tellefeil. Men det er nettopp der den feilaktige analysen ofte begynner. Inventory discrepancy causes er i praksis sjelden en enkelt forglemmelse. Oftest oppstår de der varemottak, lagerbevegelse, plukking, og bokføring driver fra hverandre i tid eller organisatorisk.

For en liten eller mellomstor bedrift er lagerdifferanser ikke bare et tema for varetellingen. De fører til feilbestillinger, ekspressleveranser, unødvendige sikkerhetslagre, og leveringsløfter som ikke kan holdes. Den som skiller årsakene rent, trenger ikke innføre et stort ERP-system med en gang. Ofte er tydeligere bokføringsregler, passende registreringsenheter, og et system som gjenspeiler reelle arbeidsprosesser nok.

Inventory discrepancy causes: hvor differanser oppstår

En lagerdifferanse er differansen mellom børverdien i det ledende systemet og det faktisk tilstedeværende lageret. Avgjørende her er ordet "ledende". Hvis en Excel-fil, en papirliste, og et varehåndteringssystem vedlikeholdes parallelt, finnes det praktisk talt flere sannheter. Da har differansen ikke bare oppstått i lageret, men var allerede innebygd i datahåndteringen.

Den effektive mottiltaket avhenger derfor av feiltypen. En feiltalt pall trenger en annen løsning enn en levering som fysisk ble mottatt, men aldri bokført. Før team restrukturerer prosesser, bør de evaluere differanser etter artikkel, lagerplass, skift, bevegelsestype, og tidspunkt. Først dette mønsteret viser om det dreier seg om et enkelttilfelle eller en tilbakevendende prosessfeil.

1. Varemottak bokføres sent eller ufullstendig

Varemottak er et klassisk bruddpunkt. Varer ankommer om morgenen, settes til side for kontroll, og flyttes senere direkte til produksjon eller hyllen. Bokføringen skjer om ettermiddagen, neste dag, eller ikke i det hele tatt. Så lenge varene fysisk er til stede, fremstår systemlageret for lavt. Er de allerede forbrukt eller utlevert, blir følgefeil mer sannsynlige.

Spesielt utsatt er delleveranser, erstatningsartikler, og overleveranser. Står det en mengde på følgeseddelen, men en annen mengde ankommer, bør ingen bare bokføre dokumentet "omtrent passende". Differansen må forbli synlig som unntak, inkludert årsak, ansvarlig person, og godkjenning. Ellers forsvinner avviket fra prosessen og dukker først opp igjen ved varetellingen.

2. Lagerbevegelser skjer uten transaksjon

En artikkel plasseres fra varemottak inn i høylager, flyttes fra en hylleplass til plukksonen, eller reserveres for en ordre. Fysisk er det en liten, rask bevegelse. I systemet kan den være avgjørende.

Hvis medarbeidere omorganiserer lagerplasser kun etter følelse, kan det totale lageret fortsatt stemme, men tilgjengeligheten på riktig sted ikke. Det forårsaker søketid, feilplukk, og unødvendige påfyllingsturer. En god lagerløsning trenger ikke gjøre hver bevegelse komplisert. Den må registrere de få bevegelsene som er relevante for tilgjengelighet, sporbarhet, og etterbestilling.

I verksteder eller mindre lagre er det ofte fornuftigere å opprettholde noen få entydige soner enn en teoretisk perfekt hyllestruktur som ingen vedlikeholder i hverdagen. Presisjon fungerer bare hvis den forblir arbeidsfør.

3. Plukking og forsendelse bokføres for tidlig

Mange team bokfører en ordre som "utbokført" ved plukking, selv om varen fortsatt ligger på en klargjøringsplass. Endres ordren deretter, kanselleres, eller sendes bare delvis, stemmer ikke lenger system- og fysisk lager overens.

Bedre er en klar separasjon mellom reservert, plukket, og sendt. Ikke alle bedrifter trenger komplekse statuskjeder for dette. Men tidspunktet for lagerreduksjonen må være entydig. For forsendelsesvarer ligger det ofte nærmere den faktiske overleveringen til transportøren enn det første grepet mot hyllen.

Også returer hører til denne flyten. Kommer varer tilbake, er de ikke automatisk tilgjengelige igjen. Først kontroll, kvalitetsbeslutning, og innlagring bør bestemme om de går tilbake til salgbart lager, forblir sperret, eller kasseres.

4. Feil enheter og stamdatafeil

En eske, en forpakning, en rull, og et enkelt stykke kan alle gjelde samme artikkel. Hvis omregningen ikke vedlikeholdes rent, oppstår differanser med imponerende hastighet. En medarbeider bokfører "1", mener en eske med 24 stykker. Systemet forstår ett stykke.

Stamdatafeil er spesielt lumske fordi bokføringsprosessen kan se teknisk korrekt ut. Kontroller derfor emballasjeenheter, omregningsfaktorer, minimumsmengder, lagerplasser, og artikkelnumre. Også lignende navngitte varianter, for eksempel ulike lengder, farger, eller partier, forveksles lett.

Her hjelper ingen generell regel som "skann mer". Strekkoder er bare like pålitelige som koblingen bak. Ved små sortimenter kan en rent vedlikeholdt artikkelstamme med lett lesbare etiketter oppnå mer enn et omfattende, men dårlig konfigurert skannerlandskap.

5. Parallelle tabeller og manuelle korrigeringer

Den tabellen på skrivebordet oppstår sjelden av slurv. Oftest fyller den et reelt gap: en spesialreservasjon, en manglende evalueringsverdi, eller en prosess som den eksisterende programvaren ikke avbilder. Den blir problematisk når den blir den andre lagerboken.

Da bokføres innganger i systemet, men uttak noteres i tabellen. Eller en korrigering skjer bare der den akkurat hjelper neste ordre. Ingen kan senere pålitelig forklare hvilken verdi som gjelder.

Ikke hver tabell trenger å avskaffes. En beregning for planlegging eller analyser kan forbli fornuftig. Lagerendrende prosesser bør imidlertid ha nøyaktig ett ledende system. Justeringer trenger en årsakskode, et tidsstempel, og ideelt sett en person som kan spores. Det er ikke byråkrati for byråkratiets skyld, men forutsetningen for solide årsaksanalyser.

6. Tellefeil og uegnede varetellingsmetoder

Selv korrekte prosesser beskytter ikke mot menneskelige feil. Artikler telles dobbelt, paller overses, åpne esker estimeres, eller lagerplasser sperres ikke mens man teller. En årlig fulltelling oppdager disse problemene sent og under høyt press.

For mange virksomheter er en syklisk telling det fornuftigere alternativet. Raskt omløpende eller verdifulle artikler kontrolleres oftere, stabile C-artikler sjeldnere. Viktig er ikke å produsere flest mulig tellinger, men å kontrollere avvik i tide mot de siste bevegelsene. Korrigeres en differanseartikkel bare uten å dokumentere årsaken, forblir mønsteret usynlig.

En motkontroll er spesielt fornuftig ved høye verdier, serienumre, eller partier. For skruer i et forbrukslager kan den være økonomisk overdreven. Kontrolldybden bør matche risikoen.

7. Uklare ansvarsforhold mellom skift og områder

Lagerfeil oppstår ofte ved overleveringer. Tidligskiftet klargjør varer, senskiftet sender dem. Varemottaket aksepterer en levering, disposisjonen endrer parallelt ordren. Hvert enkelt steg kan være sporbart, men ingen eier hele prosessen.

Definer derfor ikke bare roller, men overleveringspunkter: hvem bekrefter varemottaket? Når skifter ansvaret for plukket vare? Hvem kontrollerer åpne unntak ved skiftslutt? En felles digital tavle eller en enkel unntaksliste er ofte mer effektiv enn ekstra møter.

Systemet bør gjøre åpne prosesser synlige, i stedet for å tvinge medarbeidere til å huske. For eksempel må leveranser uten mengdekontroll, plukkinger uten forsendelsesavslutning, eller returer uten kvalitetsbeslutning legges merke til før de blir stille lagerfeil.

8. Svak systemintegrasjon og manglende kontrollregler

Hvis butikk, ordrehåndtering, lager, og regnskap utveksler data med tidsforsinkelse eller via fil, kan doble eller manglende bokføringer oppstå. En import kjøres to ganger. Et grensesnitt feiler stille. En ordre endres etter at forsendelsesstatusen allerede er overført.

Løsningen er ikke nødvendigvis en fullstendig erstatning. Ofte trengs klart definerte grensesnitt, entydige dokumentnumre, og tekniske kontroller. En lagerbokføring bør sporbart lagre når den skjedde, fra hvilken prosess den stammer, og om den senere ble kansellert. Kritiske prosesser trenger feilmeldinger og køer, ikke bare en stille oppføring i loggfilen.

Med skreddersydd utviklede logistikksystemer kan slike regler tilpasses målrettet til driften: ingen negativ mengde uten godkjenning, ingen forsendelsesbekreftelse uten forsendelsesposisjon, ingen dobbel behandling av samme eksterne referanse. Den beste regelen her er ikke den strengeste, men den som stopper reelle feil uten å blokkere driften ved normale unntak.

Kontrollere lagerdifferanser systematisk

Begynn ikke med en overordnet korrigering. Velg de ti artiklene med de hyppigste eller dyreste differansene, og spor deres siste bevegelse bakover: varemottak, omlagring, uttak, retur, telling, og eventuell manuell justering. Klynger tilfellene seg rundt ett sted, ett skift, eller én bevegelsestype, er det et solid utgangspunkt.

Deretter bør hvert tiltak være målbart. Innføres nye strekkodeskanninger, observer ikke bare antall skanninger, men differanseraten per artikkelgruppe. Legges en ny status for klargjøring til, kontroller åpne klargjøringer daglig. Gode prosesser skaper ikke skinnpresisjon. De gjør unntak synlige og sporbare tidlig.

Det fornuftige neste steget er ofte lite: definer et overleveringspunkt, rydd opp en lagerplass, eller sikre teknisk en tilbakevendende manuell korrigering. Pålitelige lagre oppstår ikke av mer programvare på mistanke, men av prosesser som fortsatt er korrekt gjennomførbare en hektisk tirsdag klokken 16:45.

Permalenke →

Å gjøre prosessautomatisering riktig for SMB-er

Å gjøre prosessautomatisering riktig for SMB-er

En følgeseddel mangler fordi dataene fortsatt står på en lapp. En varemottak registreres to ganger fordi lager og kontor jobber med forskjellige tabeller. En godkjenning forsinkes fordi den ansvarlige personen ikke svarer på telefonen akkurat nå. Slik friksjon koster sjelden mye penger på en gang. Men over uker summeres forespørsler, søketid, feilrettinger, og unødvendig venting. Nettopp der er prosessautomatisering for SMB-er fornuftig.

Det handler ikke om å erstatte flest mulig aktiviteter med programvare. God automatisering gjør prosesser sporbare, reduserer unngåelige overleveringer, og gir medarbeidere tid til beslutninger som krever erfaring. Det er spesielt avgjørende i små og mellomstore bedrifter: teamene er nær den daglige driften. Når en prosess hakker, merker ofte hele skiftet det umiddelbart.

Ikke automatiser hver prosess

Den vanligste feilen er å begynne med det mest synlige irritasjonsmomentet. Kanskje irriterer en Excel-fil, kanskje trengs et nytt dashboard. Begge deler kan være berettiget. Men et digitalisert kaos forblir kaos - bare raskere og med mer data.

Før en teknisk beslutning bør prosessen først beskrives slik den faktisk foregår. Ikke slik den burde stå i håndboken. Hvem utløser prosessen? Hvilken informasjon trengs? Hvor overføres noe manuelt? Hvem bestemmer ved unntak? Og hvordan gjenkjenner teamet at prosessen er fullført?

Nettopp i lageret eller ordrebehandlingen ligger de kritiske punktene ofte mellom systemer: en ordre kommer per e-post, kopieres inn i en tabell, avstemmes per telefon, og legges senere inn i en fraktprogramvare. Hver overlevering øker sannsynligheten for at mengder, datoer, eller adresser avviker.

En automatisering lønner seg spesielt når en prosess forekommer ofte, har klare regler, og feil forårsaker merkbare konsekvenser. Det kan være varemottak, opprettelse av følgesedler, tildeling av lagerbevegelser, eller overlevering av godkjente ordrer til frakt. Sjeldne spesialtilfeller med mange skjønnsmessige avgjørelser forblir derimot ofte bedre håndtert manuelt - i det minste til å begynne med.

Prosessautomatisering for SMB-er begynner med prioriteringer

Ikke enhver unødvendig aktivitet fortjener umiddelbart et prosjekt. En enkel prioritering skaper klarhet. Vurder enkeltprosesser etter frekvens, behandlingstid, feilkostnader, og avhengigheter. En prosess som skjer femti ganger daglig og bare sparer to minutter hver gang, kan være mer økonomisk enn en komplisert månedlig prosess.

Spørsmålet om feilkonsekvensen er minst like viktig. Et feilaktig utskrevet internt dokument er irriterende. En feilaktig batchtildeling, en tapt leveringsadresse, eller et udokumentert varemottak kan utløse reklamasjoner, søkearbeid, og lagerdifferanser. Der skaper automatisering ikke bare tempo, men pålitelighet.

Et fornuftig første steg er som regel lite nok til å være verifiserbart i løpet av noen uker. For eksempel kan en medarbeider registrere varer via en strekkode, systemet kontrollerer artikkel og mengde, oppdaterer lageret i en sentral database, og genererer om nødvendig direkte et lagringsbilag. Teamet trenger da ikke å gjette hvilken versjon av en tabell som er gjeldende.

En klar måltilstand i stedet for en funksjonsliste

Mange prosjekter starter med en lang liste over ønskede funksjoner. Bedre er et konkret driftsbilde: hva skal være synlig ved slutten av en prosess uten at noen trenger å spørre? Ved frakt kunne det bety at en ordre etter godkjenning automatisk får en plukkliste, leveringsadressen kontrolleres, og en etikett kan genereres. Unntak havner synlig i en avklaringsliste, i stedet for i en uoversiktlig e-postinnboks.

Dette målbildet tvinger frem nyttige beslutninger. Må hver bestilling behandles helt automatisk? Eller bør ordrer over en bestemt vareverdi, med avvikende leveringsadresse, eller med manglende lager, bevisst legges frem for kontroll? Automatisering trenger ikke hundre prosent mørkebehandling for å skape stor nytte.

Den passende teknikken avhenger av prosessen

Det finnes ingen teknisk standardvei for hver SMB. En tabelløsning kan fortsatt være fornuftig for en oversiktlig evaluering. Den er raskt tilpasset, kjent, og forårsaker lite innføringsinnsats. Så snart flere personer jobber samtidig, bokføringer må være sporbare, eller data utveksles med andre systemer, støter den imidlertid på grenser.

Da er ofte en slank, arbeidsflytspesifikk applikasjon mer fornuftig enn en overdimensjonert enterprise-suite. Den kan avbilde nøyaktig de trinnene som trengs i driften: registrere ordre, kontrollere lager, flytte vare, generere dokument, bokføre frakt, og rapportere status tilbake. Ikke mer, men heller ikke mindre.

Teknisk sett spiller det mindre rolle om et system reklamerer med det nyeste moteordet. Avgjørende er solide grunnlag: en rent modellert database, sporbare rettigheter, logger for relevante endringer, pålitelige grensesnitt, og dokumenterte driftsettinger. En applikasjon basert på PHP 8.4, moderne JavaScript, og MySQL 8 kan være svært godt vedlikeholdbar på lang sikt, hvis arkitektur og drift tenkes gjennom fra starten.

Også integrasjoner fortjener oppmerksomhet. En automatisk datautveksling med butikk, ERP, fraktleverandør, eller regnskap sparer bare tid hvis feil håndteres synlig. Hva skjer ved en ugyldig adresse? Forsøkes en mislykket etikettutskrift på nytt? Kan teamet se hvilke data som er overført og hvilke som fortsatt mangler? Stille feil er farligere enn et tydelig merket unntakstilfelle.

Innføring under løpende drift

Et nytt system må tilpasse seg skiftbytter, leveringsfrister, og eksisterende arbeidsrutiner. Derfor er en trinnvis utrulling som regel sikrere enn en hard frist for alle områder. Start med en avgrenset prosess, en produktgruppe, eller et lagerområde. Det reduserer risiko og skaper ekte tilbakemelding fra hverdagen.

Paralleldrift er dermed ikke et tegn på usikkerhet, men en kontrollert test. I en begrenset periode kan gammel og ny registrering sammenlignes. Forskjeller avslører ikke bare programvarefeil, men ofte også regler som hittil bare har eksistert i hodet til enkeltmedarbeidere. Disse reglene hører synlig hjemme i prosessen - ikke permanent i personlig erfaring.

Medarbeidere bør ikke konfronteres med den nye prosessen først under opplæringen. Den som utfører prosessen daglig, gjenkjenner snarveier, spesialtilfeller, og upraktiske skjermer tidlig. God programvare respekterer denne kunnskapen, uten å bygge inn hvert historisk utviklet unntak uendret. Det riktige spørsmålet er: hvilket unntak beskytter et viktig forretningstilfelle, og hvilket er bare en omvei for et gammelt problem?

Gjøre det målbart om innsatsen lønner seg

Før start bør to eller tre nøkkeltall fastsettes. Det kan være gjennomløpstid per ordre, antall manuelle rettelser, lagerdifferanser, eller tiden til frakt. Uten en utgangsverdi blir enhver senere vurdering til en magefølelse.

Ikke enhver effekt viser seg umiddelbart i kroner. Når et lagerteam alltid vet hvor varer befinner seg, synker antallet avbrudd. Når leveringsdokumenter oppstår fra de samme dataene som ordren, synker risikoen for motstridende opplysninger. Og når ansvar er synlig i systemet, avhenger en prosess mindre av enkeltpersoner.

Automatisering trenger vedlikehold og grenser

En automatisert prosess er ikke et prosjekt som fryser etter go-live. Artikkelstrukturer endres, kunder krever nye dokumenter, fraktleverandører tilpasser grensesnitt. Derfor hører ansvar, oppdateringer, sikkerhetskopier, og en regulert håndtering av rettigheter til selve systemet.

Spesielt for applikasjoner med kunde-, ordre-, eller lagerdata bør det være klart hvem som får tilgang og hvorfor. Roller må passe til arbeidshverdagen: et lagerteam trenger andre funksjoner enn regnskap eller salg. Loggede endringer, sikre påloggingsflyter, og testede gjenopprettinger virker uspektakulære. Ved en driftsforstyrrelse avgjør nettopp disse detaljene om driften kan fortsette.

Også tester er en del av driftssikkerheten. Tilbakevendende kontroller for ordreregistrering, lagerbokføring, dokumentgenerering, og rettighetsstyring forhindrer at en tilpasning ett sted skader en fungerende prosess et annet sted. For kritiske web- eller skrivebordsapplikasjoner kan et kontrollert, selvhostet testmiljø være fornuftig, hvis skjermbilder, testdata, og interne prosesser ikke skal nå eksterne skytjenester.

softify.pro følger slike prosjekter med et enkelt prinsipp: først forstå den faktiske prosessen, deretter bygge den minste bærekraftige løsningen. Noen ganger er det en skreddersydd applikasjon. Noen ganger er det nok å strukturere en eksisterende tabell renere og automatisere ett enkelt overleveringstrinn.

Det beste neste steget er derfor ingen programvaresammenligning, men en gjennomgang av en reell prosess - fra utløser til fullføring. Ta en ordre, et varemottak, eller en reklamasjon og følg den med de involverte personene. Der informasjon legges inn på nytt, ingen kjenner statusen, eller beslutninger venter unødvendig, ligger som regel den mest fornuftige tilnærmingen til automatisering.

Permalenke →

Teste Windows-applikasjoner: en praktisk plan

Teste Windows-applikasjoner: en praktisk plan

En Windows-applikasjon kan se ren ut i demomodus og likevel bremse driften mandag morgen. En ulagret følgeseddel, en bruker som blokkeres etter tre mislykkede forsøk, eller en utskriftsdialog som reagerer annerledes etter en oppdatering, er ikke kosmetiske feil. Den som vil vite hvordan man tester Windows-applikasjoner, bør derfor ikke begynne med enkeltstående knapper, men med prosessene som koster arbeid, penger, eller sporbarhet.

Nettopp i lager, verksted, utsendelse, og administrasjon går mange kritiske prosesser gjennom skrivebordsprogramvare som har vokst fram over årene. Der teller det ikke om et testtilfelle er imponerende formulert. Avgjørende er om medarbeidere pålitelig kan utføre sine oppgaver under realistiske forhold - også med ufullstendige data, skiftende rettigheter, trege nettverk, og uplanlagte avbrudd.

Å teste Windows-applikasjoner begynner med de kritiske prosessene

Ikke alle funksjoner fortjener samme testinnsats. En sjelden brukt eksport med manuelt etterarbeid bør vurderes annerledes enn bokføring av en varemottak, etikettoppretting, eller den daglige ordreavstemmingen. Start derfor med et enkelt spørsmål: hva skjer konkret hvis denne prosessen mislykkes?

Høy prioritet har prosesser med direkte innvirkning på lager, levering, fakturering, sikkerhet, eller kundekommunikasjon. Dit hører for eksempel innlogging og rettighetskontroll, opprettelse og endring av stamdata, transaksjonsbokføringer, dokumentutskrift, grensesnitt mot ERP- eller forsendelsestjenester, samt gjenoppretting etter en feil. Selv funksjoner som bare en liten gruppe bruker, kan være kritiske hvis de blokkerer en månedsavslutning eller frigivelse av varer.

Fra disse prosessene oppstår ikke abstrakte testlister, men sporbare arbeidstrinn. En varemottakstest kunne for eksempel begynne med en eksisterende ordre, registrere en dellevering, rapportere en avvikende mengde, tildele en lagerplass, og deretter kontrollere om lagerbeholdning, bokføringslogg, og utskrevet dokument stemmer overens. Slik tester du programvarens faktiske effekt, ikke bare enkeltstående innmatingsfelt.

Bygg et testgrunnlag som gjenspeiler driften

Mange feil blir først synlige når testmiljøet nærmer seg virkeligheten. En applikasjon oppfører seg ofte annerledes med en tom testleietaker enn med flere års bevegelsesdata, sperrede artikler, manglende obligatorisk informasjon, eller allerede åpnede transaksjoner.

Sett derfor opp testdata bevisst. Du trenger ikke nødvendigvis en fullstendig kopi av produksjonen. Mer fornuftig er en kontrollert datamengde med typiske, grense-, og bevisst feilaktige tilfeller: artikler med ulike måleenheter, kunder med spesialvilkår, ordrer med delleveranser, brukere med ulike roller, og transaksjoner som allerede er under behandling. Personopplysninger bør anonymiseres eller erstattes med realistiske eksempeldata.

Til testgrunnlaget hører også det tekniske miljøet. Dokumenter Windows-versjon, oppløsning, skalering, installerte skrivere, nettverksstasjoner, databaseversjon, tilkoblede tjenester, og rettigheter. Det høres nøkternt ut, men sparer tid senere. Hvis en feil bare oppstår på arbeidsstasjoner med 125 prosent skalering eller med en bestemt skriverdriver, må det være reproduserbart.

Ikke bare kontroller idealtilfellet

Idealtilfellet beviser først og fremst at applikasjonen er bygget for den forventede veien. I driften oppstår de vanskelige situasjonene ved siden av. Hva skjer hvis en bruker lar et obligatorisk felt stå tomt, utløser samme bokføring to ganger, eller mister forbindelsen under lagring? Forblir transaksjonen konsistent? Får personen en forståelig melding? Kan hen fortsette å arbeide trygt?

Ved Windows-applikasjoner er dessuten betjening og tilstand spesielt relevant. Dialogvinduer kan dukke opp i bakgrunnen, hurtigtaster kan overlappe, filvalgsdialoger kan blokkere forløpet. Kontroller om fokus, feilmeldinger, og sperrer er entydige. Et teknisk unntak uten handlingsanvisning hjelper ikke skiftlederen videre.

Bruk manuelle tester der det kreves skjønn

Manuelle tester er ikke et tegn på manglende modenhet. De er uunnværlige når en ny prosess oppstår, et grensesnitt bygges om, eller fagkunnskap avgjør kvaliteten. En erfaren lagersjef oppdager raskere enn et skript om en skjerm er forståelig under høyt tidspress, eller om en advarsel kommer for sent.

Manuell testing blir imidlertid dyr og upålitelig når de samme stabile prosessene gjentas før hver versjon. Da avhenger utgivelsen av tilgjengelige personer, hukommelse, og spredte notater. Det riktige overgangspunktet til automatisering ligger som regel der en prosess kjøres ofte, kan forårsake stor skade, og har klare forventede resultater.

Et godt manuelt testtilfelle beskriver utgangssituasjon, trinn, forventet resultat, og nødvendige data. Ved en feil, legg til et skjermbilde, tidsstempel, applikasjons- og byggversjon, samt den nøyaktige handlingen. «Utskrift virker ikke» er ikke en brukbar feilbeskrivelse. «Etter endring av leveringsadressen forblir utskriftsdialogen åpen, ordre 4711 får ingen PDF, og det vises ingen melding» er det.

Automatiserte regresjonstester for tilbakevendende risikoer

Automatisering kontrollerer ikke om programvare grunnleggende sett er god. Den kontrollerer om tidligere fungerende, definerte prosesser fortsatt fungerer etter en endring. Det er spesielt verdifullt for Windows-programvare hvis grensesnitt, databaselogikk, og eksterne grensesnitt videreutvikles over årene.

Start smått. Velg først fem til ti forretningskritiske prosesser som bør kontrolleres ved hver utgivelse. Dit kan innlogging med en account-lockout-flyt, ordreregistrering, lagerbokføring, PDF- eller etikettutskrift, rollebytte, og en sentral import høre. Først når disse testene kjører pålitelig, lønner det seg å utvide til spesialtilfeller.

Ved skrivebordsapplikasjoner styrer automatiserte tester ofte synlige grensesnittelementer: vinduer, innmatingsfelt, tabeller, knapper, og dialoger. Det fungerer, men er mer sårbart enn en ren grensesnittstest. Små layoutendringer, tregere maskiner, eller tvetydig navngitte elementer kan bryte tester. Derfor bør utviklere, fagavdeling, og testansvarlige i fellesskap fastsette hvilke elementer som er stabilt adresserbare, og hvilke kontrolltrinn som bedre sikres via database, logg, eller grensesnitt.

En fornuftig test kontrollerer dessuten ikke bare at en knapp kunne klikkes. Den kontrollerer den forretningsmessige konsekvensen: ble bokføringen lagret? Er lagerbeholdningen korrekt? Ble et dokument generert? Ble ingen duplikat opprettet? Synlig interaksjon og verifiserbart resultat hører sammen.

Bevis er en del av testresultatet

En grønn status alene er sjelden nok for kritiske applikasjoner. Når en test mislykkes, trenger team raskt svar på tre spørsmål: hva var utgangssituasjonen? Ved hvilket trinn mislyktes prosessen? Hva viste applikasjonen på det tidspunktet?

Skjermbilder, kjøringslogger, og eventuelt skjermopptak gjør feil diskuterbare. De forkorter overleveringen mellom drift, QA, og utvikling betydelig. For regulerte eller sikkerhetsbevisste selskaper er de dessuten et solid grunnlag for å spore godkjenninger og avvik.

Lagringsstedet er ikke en bisak her. Testkjøringer kan inneholde interne kundedata, prislister, ordreinformasjon, eller skjermvisninger. Den som automatisert tester sensitive Windows-applikasjoner, bør avklare om disse dataene får forlate egen infrastruktur. Et selvhostet miljø som COCO kan være fornuftig her, fordi testkjøring, bevis, og evaluering forblir under egen kontroll. Om det er nødvendig, avhenger av personvernkrav, avtalesituasjon, og beskyttelsesbehov - ikke alle team trenger samme arkitektur for det.

Bygg testing inn i utgivelsesprosessen

Den beste testkatalogen mister verdi hvis den først brukes etter en hektisk produksjonssetting. Definer et fast tidspunkt: automatiserte kjerneregresjoner kjøres før hver utgivelse, manuell akseptanse kontrollerer nye eller endrede prosesser, og kjente begrensninger dokumenteres åpent.

Ikke hver mislykkede test trenger å stoppe en utgivelse. En feil i en sjelden brukt administrasjonsvisning kan være akseptabel hvis en trygg omvei finnes og det berørte området er tydelig informert. En feil som bokfører lagerbeholdning feil eller ubemerket blokkerer brukere, må behandles annerledes. Denne beslutningen bør tas basert på forretningspåvirkning, ikke bare antallet røde tester.

Vedlikehold testene sammen med applikasjonen. Når en prosess bevisst endres, oppdater testtilfelle, testdata, og forventet resultat sammen med kravet. Utdaterte tester skaper støy og blir til slutt ignorert. Noen få pålitelige kontroller er mer verdifulle enn hundrevis av automatiserte prosesser hvis resultater ingen lenger tar på alvor.

Til syvende og sist handler det ikke om å simulere hver tenkelige inndata. Det handler om å beskytte arbeidet som må fungere igjen neste morgen. Start med én eneste kritisk prosess, gjør resultatet dens bevisbart, og bygg videre derfra.

Permalenke →

Secure test data management uten å miste kontrollen

Secure test data management uten å miste kontrollen

En mislykket testkjøring er irriterende. En vellykket testkjøring med ekte kundedata i et utilstrekkelig beskyttet miljø kan vise seg å bli betydelig dyrere. Secure test data management løser ikke denne motsetningen med ett enkelt verktøy, men med tydelige regler for data, tilgang, testmiljøer, og bevis. For team som automatisert tester web- eller Windows-applikasjoner, hører dette derfor til kvalitetsarbeidet - ikke bare til etterlevelse.

Hvorfor testdata blir et sikkerhetsproblem

Produksjonsdata er forlokkende for tester fordi de inneholder reelle spesialtilfeller: ufullstendige adresser, uvanlige ordrekombinasjoner, historiske prisregler, eller feilaktige inndata. Men nettopp disse dataene inneholder ofte navn, kontaktopplysninger, kontraktsinformasjon, personalnumre, bankopplysninger, eller intern forretningslogikk.

Risikoen oppstår sjelden av én enkelt grov feil. Den vokser vanligvis trinnvis: en databaseeksport opprettes for en test, legges i en delt katalog, og kopieres senere til et annet miljø. En ekstern tjeneste mottar skjermbilder for feilanalyse. En testkonto beholder omfattende rettigheter fordi en opprydding kan forstyrre neste kjøring. Etter noen måneder vet ingen lenger pålitelig hvilke data som ligger hvor.

Hos små og mellomstore bedrifter forverres problemet ofte av knapp kapasitet. Teamet vil holde en utgivelsesfrist, ikke drive et eget personvernprosjekt. Ansvaret består likevel. Den som bruker data til kvalitetssikring må kunne spore hvilke data som behandles, hvem som har tilgang, og når de fjernes igjen.

Secure test data management begynner før testtilfellet

Det avgjørende spørsmålet er ikke: «Hvordan beskytter vi testdatabeholdningen?» Det er: «Hvilken informasjon trenger denne testen egentlig?» Mange regresjonstester trenger ingen reelle personreferanser i det hele tatt. En forsendelsesprosess må for eksempel kontrollere om leveringsadresser, vekter, soner, etiketter, og statusendringer behandles korrekt. Til det er syntetiske kunder, plausible artikkelstamdata, og bevisst definerte grensetilfeller nok.

Dette skillet fører til en praktisk dataklassifisering. Ikke alle testmiljøer trenger samme datadybde. For enhets- og integrasjonstester holder det ofte med helt kunstige datasett. For ende-til-ende-tester kan pseudonymiserte kopier være fornuftige, hvis reelle datamønstre er faglig relevante. Produksjonslignende data bør være unntaket - med dokumentert formål, begrenset tilgang, og en fast levetid.

Viktig her er kvaliteten på erstatningsdataene. Tilfeldige fantasidata hjelper lite hvis de ikke gjenspeiler realistiske avhengigheter. Et testdatasett for en lagerapplikasjon må for eksempel inneholde artikkelvarianter, lagerplasser, sperret beholdning, delleveranser, og returer i en samstemt kombinasjon. God testdata beskytter ikke bare personopplysninger. De finner feil som aldri ville blitt synlige med tomme tabeller og eksempelkunden «Ola Nordmann».

Syntetisere, maskere, eller minimere?

Syntetiske data er det tryggeste valget når de faglige reglene kan modelleres rent. De oppstår målrettet fra testkrav og inneholder ingen kopi av reelle personer eller transaksjoner. Innsatsen ligger i vedlikeholdet: endrer datamodellen seg eller kommer det nye prosessregler, må generatorer og fixtures vokse med.

Maskering egner seg når en applikasjons oppførsel er sterkt avhengig av produksjonsstrukturer. Da erstattes eller endres sensitive felt, mens relasjoner beholdes. Navn blir plausible, men fiktive navn; e-postadresser blir ikke-leverbare testadresser; kontonumre blir verdier med korrekt format uten reell tilknytning. En maskering er bare robust hvis også indirekte slutninger tas med i betraktningen. En kombinasjon av et sjeldent sted, fødselsdato, og kontraktsegenskap kan fortsatt gjøre en person identifiserbar.

Dataminimering er ofte den undervurderte tredje veien. I stedet for å kopiere en fullstendig eksport, tilbys bare det nødvendige utsnittet. Det reduserer angrepsflaten, lagringsbehovet, og opprydningsinnsatsen. For å teste en rabattlogikk trenger ingen hele et års kundehistorikk.

Tilgang og miljøer må matche risikoen

Et beskyttet datasett mister sin verdi hvis det ligger i et fritt tilgjengelig testmiljø. Testsystemer trenger derfor egne sikkerhetsgrenser - separate databaser, egne tjenestekontoer, klart definert nettverkstilgang, og ingen stilltiende forbindelse til produksjon.

Tilgangsrettigheter bør baseres på roller, ikke på delte kontoer. Utviklere kan trenge andre rettigheter enn QA, support, eller eksterne tjenesteleverandører. Administratortilgang er noen ganger nødvendig, men bør være tidsbegrenset, logget, og knyttet til en sporbar godkjenning. Også for testkontoer gjelder fornuftige passordregler, multifaktorautentisering der den er tilgjengelig, og kontosperreflyter ved gjentatte mislykkede forsøk.

Automatiserte tester bringer med seg enda et spesialtilfelle: de genererer bevis. Skjermbilder, skjermopptak, logger, og feilmeldinger kan inneholde sensitivt innhold, selv når databasen er maskert. Et skjermbilde av en kundeskjerm, et nettlesersport med øktinformasjon, eller en logg med API-nyttelast hører til samme beskyttelsesvurdering som testdatabasen.

Derfor trenger testartefakter oppbevaringsregler. Ikke hver vellykkede kjøring trenger å lagres permanent. For kritiske godkjenninger kan sporbart bevis være fornuftig, for eksempel med tidsstempel, byggnummer, testversjon, og resultat. Mislykkede kjøringer trenger ofte et lengre analysevindu. Etter det bør artefakter slettes automatisk. Det som ikke lenger finnes, kan ikke ved et uhell deles eller kompromitteres.

Automatisering uten ukontrollerte datalekkasjer

KI-støttet testautomatisering kan betydelig fremskynde tester, spesielt for omfattende web- og Windows-applikasjoner. Men det endrer sikkerhetsspørsmålet: hvor går skjermbilder, inndata, feilbeskrivelser, og applikasjonstrafikk? Hvem behandler dem? Hvor lenge blir de der?

For sikkerhetsbevisste team er selvhostet kjøring ofte den bedre arkitekturen. Et system som COCO kan kjøre innenfor egen eller en klart avgrenset infrastruktur, utføre teststeg, lagre bevis, og generere forståelige vurderinger. Det er ikke obligatorisk i alle situasjoner. For en offentlig markedsføringsside med rent syntetiske skjemaverdier kan en ekstern tjeneste være forsvarlig. Ved interne fagapplikasjoner, kundeportaler, eller programvare med personrelaterte prosesser er lokal kontroll imidlertid en konkret fordel.

Selvhosting er ikke et frikort. Driften krever oppdateringer, sikkerhetskopikonsepter, tilgangslogger, og en ansvarlig instans. Til gjengjeld forblir datasuvereniteten der den hører hjemme. Den riktige tilnærmingen avhenger av beskyttelsesbehov, eksisterende driftsevne, og typen testet applikasjon - ikke av det aktuelle hypet rundt et bestemt testverktøy.

Slik blir regler til en arbeidsdyktig prosess

En gjennomførbar prosess trenger ikke å blokkere utgivelsen. Begynn med et datakart: hvilke testmiljøer finnes, hvilke datatyper ligger der, og hvilke systemer genererer ytterligere artefakter? Denne kartleggingen avdekker som regel allerede gamle eksporter, glemte staging-systemer, og uklare ansvarsforhold.

Deretter lønner det seg med en enkel beslutningsmatrise per testklasse. Den fastsetter om syntetiske data er nok, en maskering er nødvendig, eller om et klart begrunnet produksjonsutdrag trengs. Den suppleres med eiere, slettefrister, og tilgangsroller. Det trenger ikke være et overbelastet regelverk. En kort, faktisk fulgt retningslinje er bedre enn et sikkerhetsdokument som ingen finner under en driftsforstyrrelse.

Teknisk hører dataklargjøring og opprydding hjemme i testpipelinen. En kjøring oppretter de datasettene den trenger reproduserbart, bruker unike merkinger, og fjerner dem deretter igjen. Det hindrer at testmiljøer fylles med restdata og resultater blir mindre pålitelige for hver sprint. For kritiske prosesser bør team dessuten sjekke om datatilgang og testbevis må logges på en revisjonssikker måte.

Sikkerhet som gjør testingen raskere

Secure test data management blir ofte betraktet som ekstra kontrollbyrde. Dårlig implementert kan det virkelig være det. Godt implementert skaper det imidlertid pålitelige, repeterbare utgangsforhold. Team kaster bort mindre tid på å lete etter en brukbar dataeksport, unngår ødelagte tester på grunn av uoppryddet gammel data, og kan bedre begrunne godkjenninger.

Det mest fornuftige første trinnet er sjelden et stort plattformprosjekt. Ta testprosessen med høyest risiko eller størst friksjon - for eksempel godkjenningen av en intern ordreapplikasjon - og gjør datakilde, tilgang, artefakter, og sletting synlige der. Fra dette konkrete arbeidet vokser det frem en sikkerhetsrutine som ikke gjør testene tyngre, men mer troverdige.

Permalenke →