
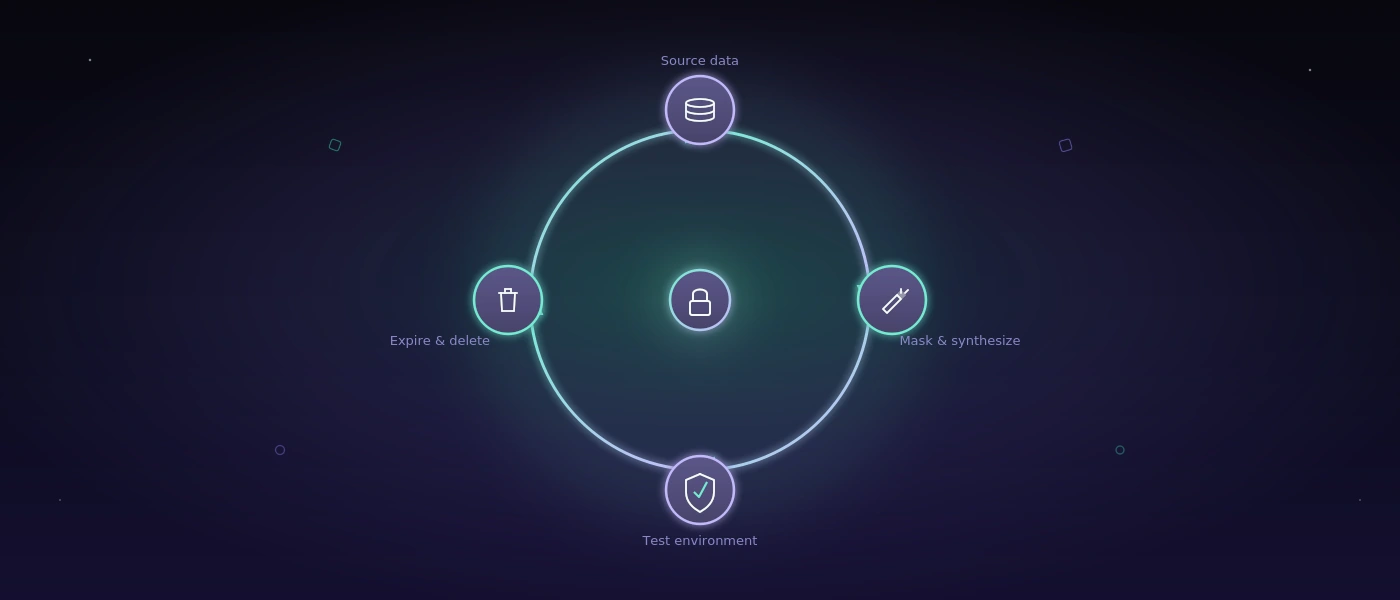
Secure Test Data Management ohne Kontrollverlust
Ein fehlgeschlagener Testlauf ist ärgerlich. Ein erfolgreicher Testlauf mit echten Kundendaten in einer unzureichend geschützten Umgebung kann deutlich teurer werden. Secure Test Data Management löst diesen Widerspruch nicht mit einem einzelnen Tool, sondern mit klaren Regeln für Daten, Zugriffe, Testumgebungen und Nachweise. Für Teams, die Web- oder Windows-Anwendungen automatisiert testen, gehört es damit zur Qualitätsarbeit - nicht nur zur Compliance.
Warum Testdaten ein Sicherheitsproblem werden
Produktivdaten sind für Tests verführerisch, weil sie reale Sonderfälle enthalten: unvollständige Adressen, ungewöhnliche Bestellkonstellationen, historische Preisregeln oder fehlerhafte Eingaben. Genau diese Daten enthalten aber häufig Namen, Kontaktdaten, Vertragsinformationen, Personalnummern, Bankdaten oder interne Geschäftslogik.
Das Risiko entsteht selten durch einen einzelnen groben Fehler. Meist wächst es schrittweise: Ein Datenbankexport wird für einen Test erstellt, in einem gemeinsamen Verzeichnis abgelegt und später in eine weitere Umgebung kopiert. Ein externer Dienst erhält Screenshots zur Fehleranalyse. Ein Testkonto behält weitreichende Rechte, weil eine Bereinigung den nächsten Lauf stören könnte. Nach einigen Monaten weiß niemand mehr verlässlich, welche Daten wo liegen.
Bei kleinen und mittleren Unternehmen verschärft sich das Problem oft durch knappe Kapazitäten. Das Team will eine Release-Frist halten, nicht ein eigenes Datenschutzprojekt betreiben. Trotzdem bleibt die Verantwortung bestehen. Wer Daten für Qualitätssicherung nutzt, muss nachvollziehen können, welche Daten verarbeitet werden, wer Zugriff hat und wann sie wieder entfernt werden.
Secure Test Data Management beginnt vor dem Testfall
Die entscheidende Frage lautet nicht: „Wie schützen wir den Testdatenbestand?" Sie lautet: „Welche Information braucht dieser Test tatsächlich?" Viele Regressionstests benötigen keine echten Personenbezüge. Ein Versandprozess muss beispielsweise prüfen, ob Lieferadressen, Gewichte, Zonen, Etiketten und Statuswechsel korrekt verarbeitet werden. Dafür reichen synthetische Kunden, plausible Artikelstammdaten und bewusst definierte Grenzfälle.
Diese Unterscheidung führt zu einer praktikablen Datenklassifizierung. Nicht jede Testumgebung braucht dieselbe Datentiefe. Für Unit- und Integrationstests genügen oft vollständig künstliche Datensätze. Für End-to-End-Tests können pseudonymisierte Kopien sinnvoll sein, wenn reale Datenmuster fachlich relevant sind. Produktionsähnliche Daten sollten die Ausnahme sein - mit dokumentiertem Zweck, begrenztem Zugriff und einer festen Lebensdauer.
Wichtig ist dabei die Qualität der Ersatzdaten. Zufällige Fantasiedaten helfen wenig, wenn sie keine realistischen Abhängigkeiten abbilden. Ein Testdatensatz für eine Lageranwendung muss etwa Artikelvarianten, Lagerplätze, Sperrbestände, Teillieferungen und Retouren in stimmiger Kombination enthalten. Gute Testdaten schützen nicht nur personenbezogene Informationen. Sie finden Fehler, die mit leeren Tabellen und dem Musterkunden „Max Mustermann" nie sichtbar würden.
Synthetisieren, maskieren oder minimieren?
Synthetische Daten sind die sicherste Wahl, wenn sich die fachlichen Regeln sauber modellieren lassen. Sie entstehen gezielt aus Testanforderungen und enthalten keine Kopie realer Personen oder Vorgänge. Der Aufwand liegt in der Pflege: Ändert sich das Datenmodell oder kommen neue Prozessregeln hinzu, müssen Generatoren und Fixtures mitwachsen.
Maskierung eignet sich, wenn das Verhalten einer Anwendung stark von Produktionsstrukturen abhängt. Dabei werden sensible Felder ersetzt oder verändert, während Beziehungen erhalten bleiben. Aus Namen werden plausible, aber fiktive Namen; aus E-Mail-Adressen werden nicht zustellbare Testadressen; aus Kontonummern werden Werte mit korrektem Format ohne echten Bezug. Eine Maskierung ist nur dann belastbar, wenn auch indirekte Rückschlüsse bedacht werden. Eine Kombination aus seltenem Ort, Geburtsdatum und Vertragsmerkmal kann eine Person weiterhin erkennbar machen.
Datenminimierung ist oft der unterschätzte dritte Weg. Statt einen kompletten Export zu kopieren, wird nur der erforderliche Ausschnitt bereitgestellt. Das reduziert Angriffsfläche, Speicherbedarf und Bereinigungsaufwand. Für einen Test einer Rabattlogik braucht niemand die gesamte Kundenhistorie eines Jahres.
Zugriffe und Umgebungen müssen zum Risiko passen
Ein geschützter Datensatz verliert seinen Wert, wenn er in einer frei erreichbaren Testumgebung liegt. Testsysteme brauchen daher eigene Sicherheitsgrenzen - getrennte Datenbanken, eigene Servicekonten, klar definierte Netzwerkzugänge und keine stillschweigende Verbindung zur Produktion.
Zugriffsrechte sollten auf Rollen beruhen, nicht auf gemeinsam genutzten Konten. Entwickelnde benötigen unter Umständen andere Rechte als QA, Support oder externe Dienstleister. Administratorzugriffe sind manchmal nötig, aber sie sollten zeitlich begrenzt, protokolliert und mit einer nachvollziehbaren Freigabe verbunden sein. Auch für Testkonten gelten sinnvolle Passwortregeln, Multi-Faktor-Authentifizierung, wo sie verfügbar ist, und Account-Lockout-Flows bei wiederholten Fehlversuchen.
Automatisierte Tests bringen einen weiteren Sonderfall mit: Sie erzeugen Beweise. Screenshots, Bildschirmaufzeichnungen, Logs und Fehlermeldungen können sensible Inhalte enthalten, selbst wenn die Datenbank maskiert wurde. Ein Screenshot einer Kundenmaske, ein Browser-Trace mit Session-Informationen oder ein Log mit API-Payload gehört in dieselbe Schutzbetrachtung wie die Testdatenbank.
Deshalb brauchen Testartefakte Aufbewahrungsregeln. Nicht jeder erfolgreiche Lauf muss dauerhaft gespeichert werden. Für kritische Freigaben kann eine nachvollziehbare Evidenz sinnvoll sein, etwa mit Zeitstempel, Build-Nummer, Testversion und Ergebnis. Fehlgeschlagene Läufe benötigen oft eine längere Analysefrist. Danach sollten Artefakte automatisiert gelöscht werden. Was nicht mehr existiert, kann nicht versehentlich geteilt oder kompromittiert werden.
Automatisierung ohne unkontrollierte Datenabflüsse
KI-gestützte Testautomatisierung kann Tests deutlich beschleunigen, besonders bei umfangreichen Web- und Windows-Anwendungen. Sie verändert aber die Sicherheitsfrage: Wohin gehen Screenshots, Eingaben, Fehlerbeschreibungen und Anwendungstraffic? Wer verarbeitet sie? Wie lange bleiben sie dort?
Für sicherheitsbewusste Teams ist eine selbst gehostete Ausführung oft die bessere Architektur. Ein System wie COCO kann innerhalb der eigenen oder einer klar abgegrenzten Infrastruktur laufen, Testschritte ausführen, Nachweise speichern und verständliche Bewertungen erzeugen. Das ist nicht in jeder Situation zwingend. Für eine öffentliche Marketingseite mit rein synthetischen Formularwerten kann ein externer Dienst vertretbar sein. Bei internen Fachanwendungen, Kundenportalen oder Software mit personenbezogenen Vorgängen ist die lokale Kontrolle jedoch ein handfester Vorteil.
Selbsthosting ist kein Freifahrtschein. Der Betrieb verlangt Updates, Backup-Konzepte, Zugriffsprotokolle und eine verantwortliche Stelle. Dafür bleibt die Datenhoheit dort, wo sie hingehört. Der richtige Ansatz hängt vom Schutzbedarf, den vorhandenen Betriebsfähigkeiten und der Art der getesteten Anwendung ab - nicht vom aktuellen Hype um ein bestimmtes Testwerkzeug.
So wird aus Regeln ein arbeitsfähiger Prozess
Ein praktikabler Prozess muss den Release nicht blockieren. Beginnen Sie mit einer Datenlandkarte: Welche Testumgebungen gibt es, welche Datenarten liegen dort und welche Systeme erzeugen zusätzliche Artefakte? Diese Bestandsaufnahme deckt meist schon alte Exporte, vergessene Staging-Systeme und unklare Verantwortlichkeiten auf.
Danach lohnt sich eine einfache Entscheidungsmatrix pro Testklasse. Sie legt fest, ob synthetische Daten genügen, eine Maskierung erforderlich ist oder ein klar begründeter Produktionsauszug gebraucht wird. Ergänzt wird sie durch Eigentümer, Löschfristen und Zugriffsrollen. Das muss kein überladenes Regelwerk sein. Eine kurze, gelebte Vorgabe ist besser als ein Sicherheitsdokument, das während einer Störung niemand findet.
Technisch gehören Datenbereitstellung und Bereinigung in die Testpipeline. Ein Lauf erstellt seine benötigten Datensätze reproduzierbar, nutzt eindeutige Kennzeichnungen und entfernt sie anschließend wieder. Das verhindert, dass sich Testumgebungen mit Restdaten füllen und Ergebnisse mit jedem Sprint weniger vertrauenswürdig werden. Für kritische Prozesse sollten Teams außerdem prüfen, ob Datenzugriffe und Testnachweise revisionsfähig protokolliert werden müssen.
Sicherheit, die den Test schneller macht
Secure Test Data Management wird häufig als zusätzlicher Kontrollaufwand betrachtet. Schlecht umgesetzt kann es das auch sein. Gut umgesetzt schafft es aber verlässliche, wiederholbare Ausgangsbedingungen. Teams verschwenden weniger Zeit mit der Suche nach einem brauchbaren Datenexport, vermeiden defekte Tests durch unbereinigte Altdaten und können Freigaben besser begründen.
Der sinnvollste erste Schritt ist selten ein großes Plattformprojekt. Nehmen Sie den Testprozess mit dem höchsten Risiko oder der größten Reibung - etwa die Freigabe einer internen Auftragsanwendung - und machen Sie Datenquelle, Zugriffe, Artefakte und Löschung dort sichtbar. Aus dieser konkreten Arbeit entsteht eine Sicherheitsroutine, die Tests nicht schwerfälliger macht, sondern glaubwürdiger.