
Um armazém. Uma verdade.
Há uma forma simples de fazer um software de armazém parecer convincente.
Abrir um painel.
Mostrar alguns números a verde.
Adicionar um gráfico.
Colocar algum stock num mapa do armazém.
Terminar com um relatório.
Tudo parece estar bem.
E, ainda assim, tudo pode estar errado.
Porque a um armazém não interessa quão bonito o painel parece.
Interessa-lhe se cada parte do sistema concorda sobre o que realmente aconteceu.
Isso tornou-se a parte interessante da mais recente experiência softify.pro Flow.
Não outro ecrã.
Não outro KPI.
Não outro relatório.
Algo muito menos visível.
Consistência.
Começou com um armazém.
A demo atual do softify.pro Flow funciona com vários ambientes de armazém sintéticos.
Diferentes IDs de armazém.
Diferentes capacidades.
Diferentes estruturas de zona.
Sem inventário de produção.
Sem dados de clientes.
Sem informação operacional real.
Mas a lógica do processo comporta-se como se tudo isso importasse.
Porque na logística real, importa.
Assim que um armazém é selecionado, esse contexto torna-se parte de tudo o que se segue.
Flows.
SSCCs.
Movimentos.
Operadores.
Analytics.
Relatórios.
Isso soa óbvio.
Torna-se consideravelmente menos óbvio quando o mesmo processo começa a aparecer em várias partes diferentes da aplicação.
Depois abrimos outra vista.
Operational Analytics.
De repente, o armazém parecia completamente diferente.
Sem posições de armazenamento.
Sem setas de movimento.
Em vez disso:
- Flows concluídos,
- encomendas ativas,
- utilização do armazém,
- exceções,
- entradas,
- saídas,
- tempo de processamento.
A representação visual tinha mudado.
O armazém não.
Essa distinção tornou-se importante.
Porque por baixo dos KPIs continuavam a existir registos individuais.
IDs de Flow.
SSCCs.
Zonas.
Estados.
Operadores.
Tempos de processamento.
Vista diferente.
Mesma realidade operacional.
Até aqui, tudo bem.
Operational Analytics — estado agregado do armazém, com os registos Flow subjacentes ainda visíveis.
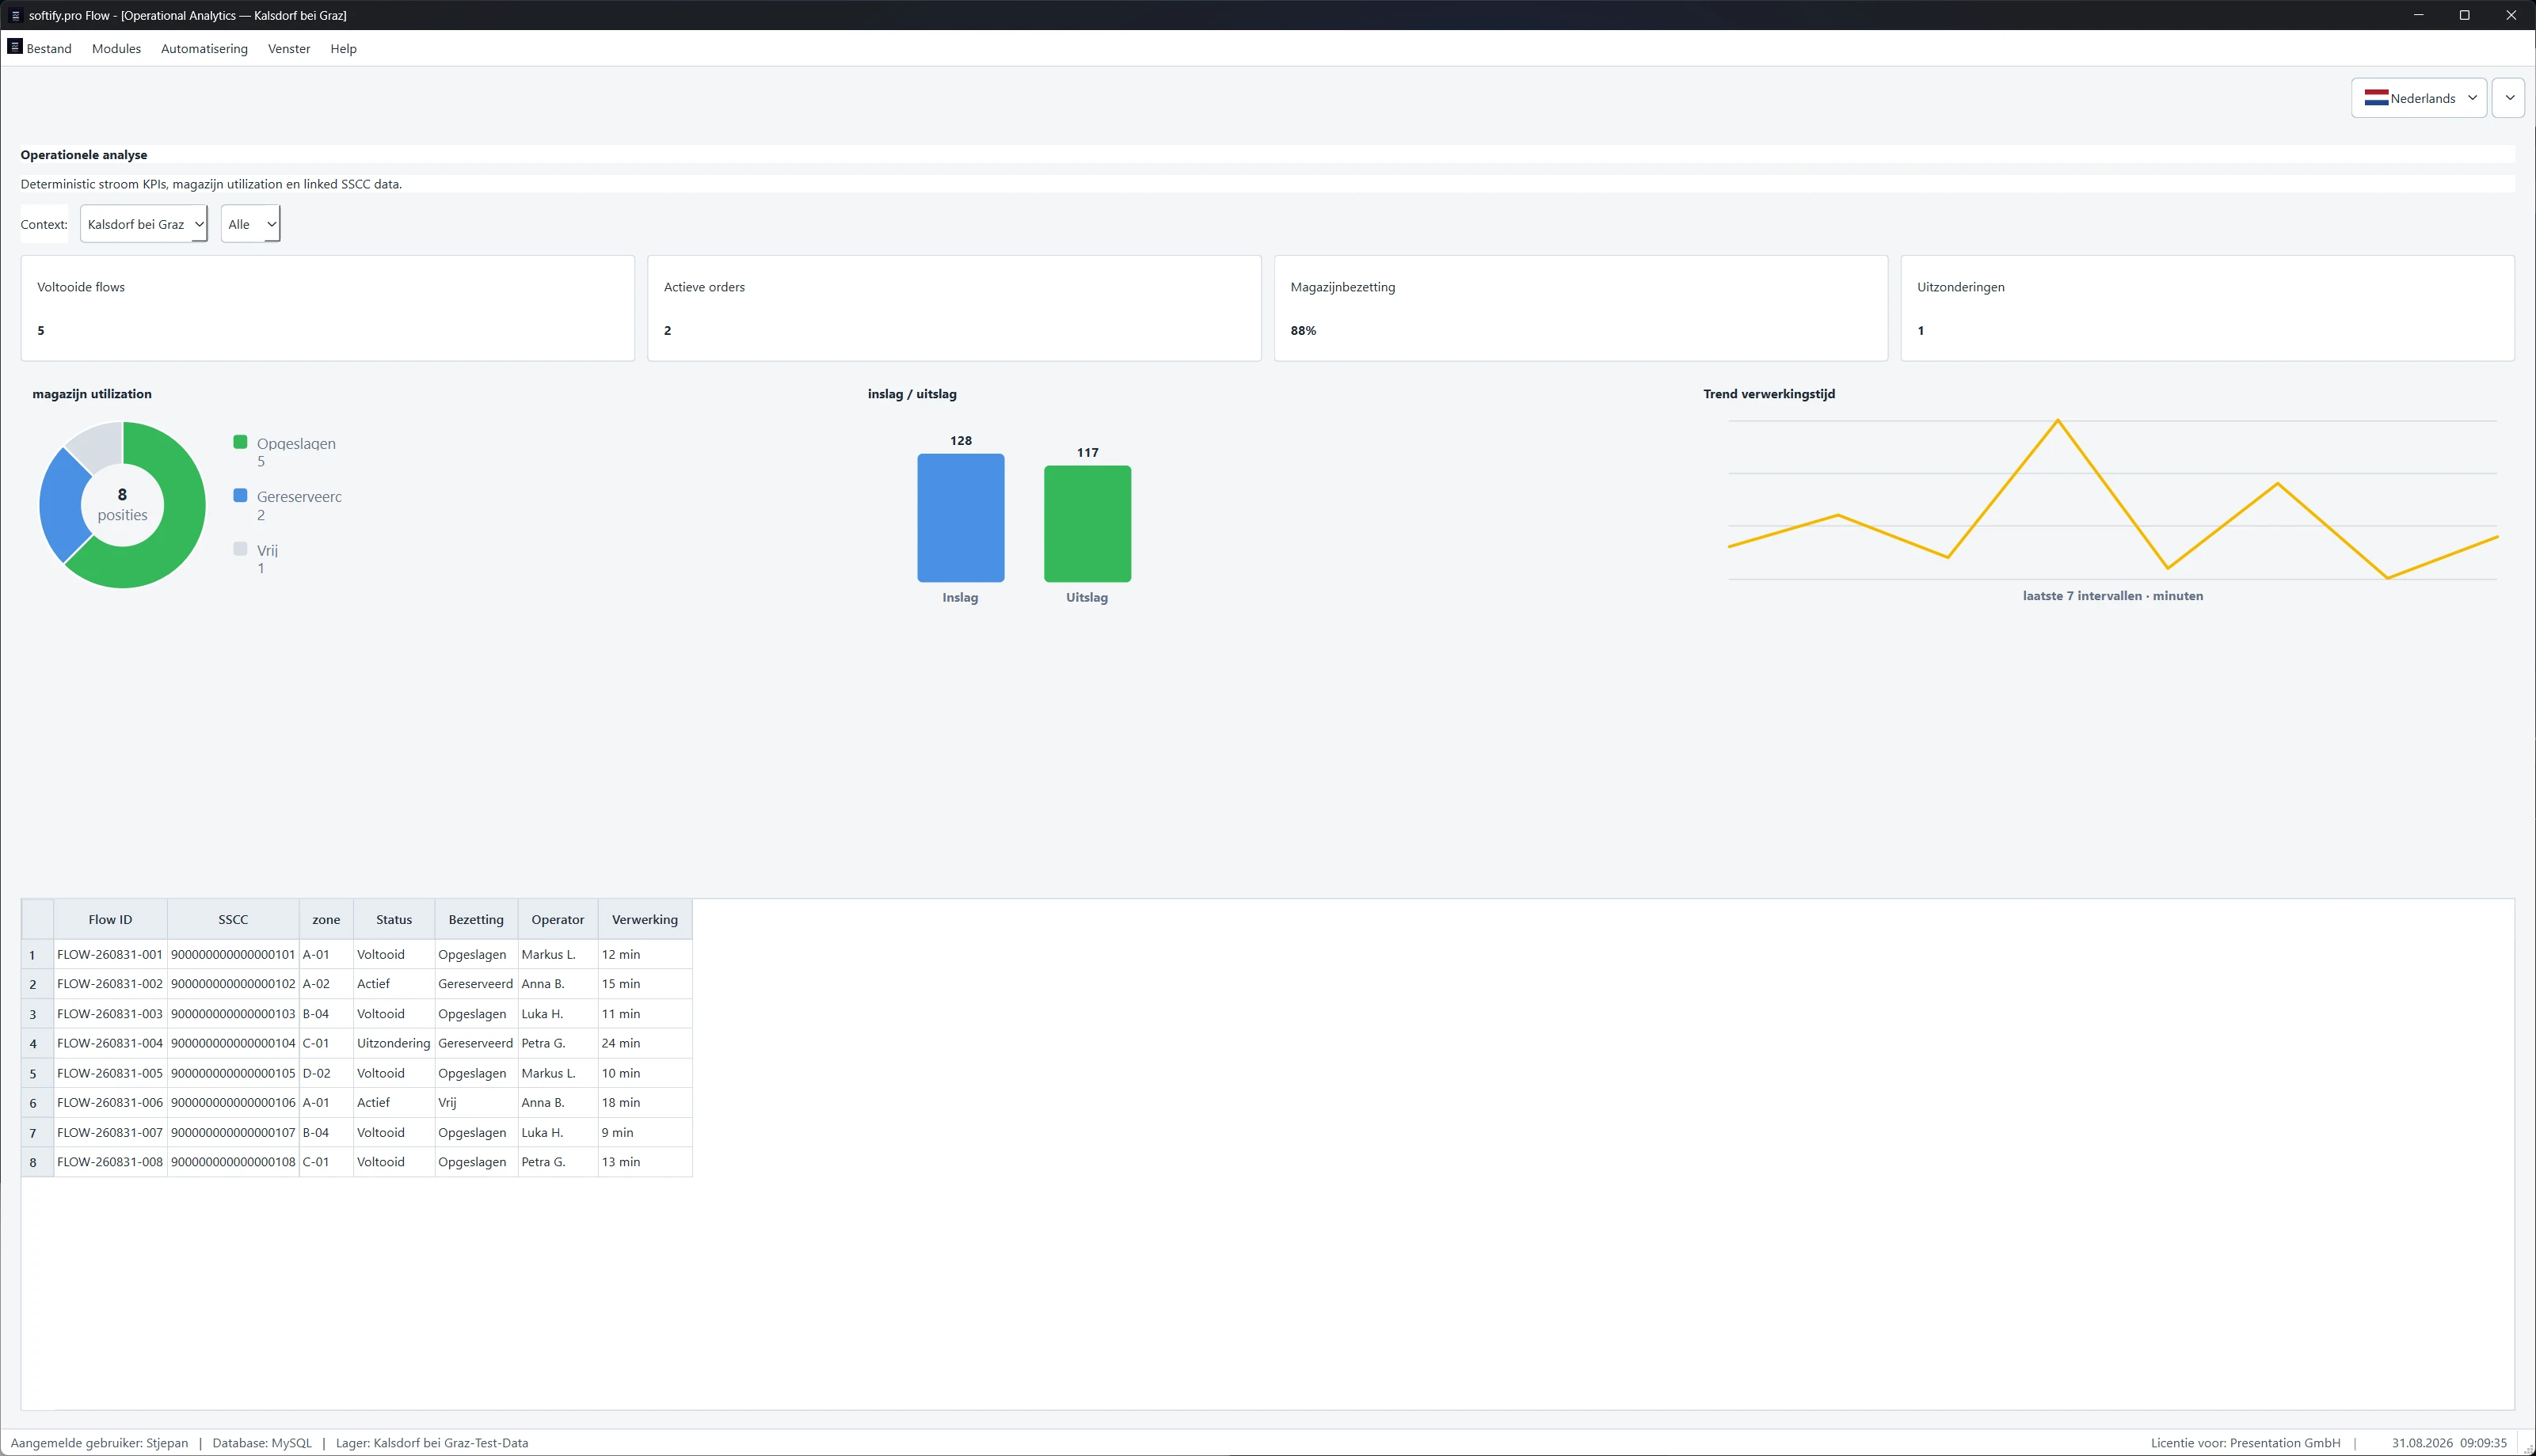
88% só é útil se o sistema o conseguir explicar.
Suponhamos que o painel diz:
Utilização do armazém: 88%.
Útil.
Mas incompleto.
Algumas posições estão ocupadas.
Algumas estão reservadas.
Algumas permanecem livres.
Esses estados não são intermutáveis.
O número só se torna fiável se o sistema ainda conseguir explicar de onde veio.
Cinco Flows concluídos?
Mostre-os.
Duas encomendas ativas?
Mostre-as.
Uma exceção?
Qual?
88% de utilização?
O que está ocupado?
O que está reservado?
O que permanece livre?
Um painel deve resumir a realidade.
Não deve substituí-la.
Depois mudámos o idioma.
Neerlandês.
O armazém permaneceu o mesmo.
Os IDs de Flow permaneceram os mesmos.
Os SSCCs permaneceram os mesmos.
Os operadores permaneceram associados aos seus registos.
Só o idioma mudou.
Mais tarde, o mesmo estado operacional apareceu em croata.
Depois em francês.
É aqui que o software multilingue se torna muito mais interessante do que botões traduzidos.
Uma má tradução é fácil de notar.
Uma mudança de estado causada por uma mudança de idioma é muito mais perigosa.
Imagine mudar de alemão para francês e perder silenciosamente o Flow selecionado.
Ou reconstruir um filtro contra o armazém errado.
Ou mostrar o SSCC correto dentro do contexto de processo errado.
A interface pode continuar a parecer perfeita.
O sistema não seria.
Por isso, o Flow segue uma regra simples:
O idioma pode mudar as palavras. Não pode mudar a verdade.
Depois o Flow adquiriu um histórico.
O Browse & Drill-down não se esforça particularmente por parecer impressionante.
Talvez seja precisamente por isso que é útil.
Selecione um Flow.
O seu contexto aparece.
Armazém.
Zona.
Estado.
Operador.
SSCC.
E depois a cadeia de documentos.
ASN.
Receção de mercadorias.
Movimento de armazém.
Ordem de picking.
Picking.
Expedição.
FLOW.
Sete passos.
O processo já não é apenas um estado atual.
Tem um passado.
E isso muda a pergunta.
Em vez de:
O que está a acontecer?
podemos perguntar:
Como chegámos aqui?
Essa é uma pergunta muito melhor quando algo acaba por correr mal.
Um Flow, um SSCC, uma cadeia de documentos — do ASN até à conclusão.
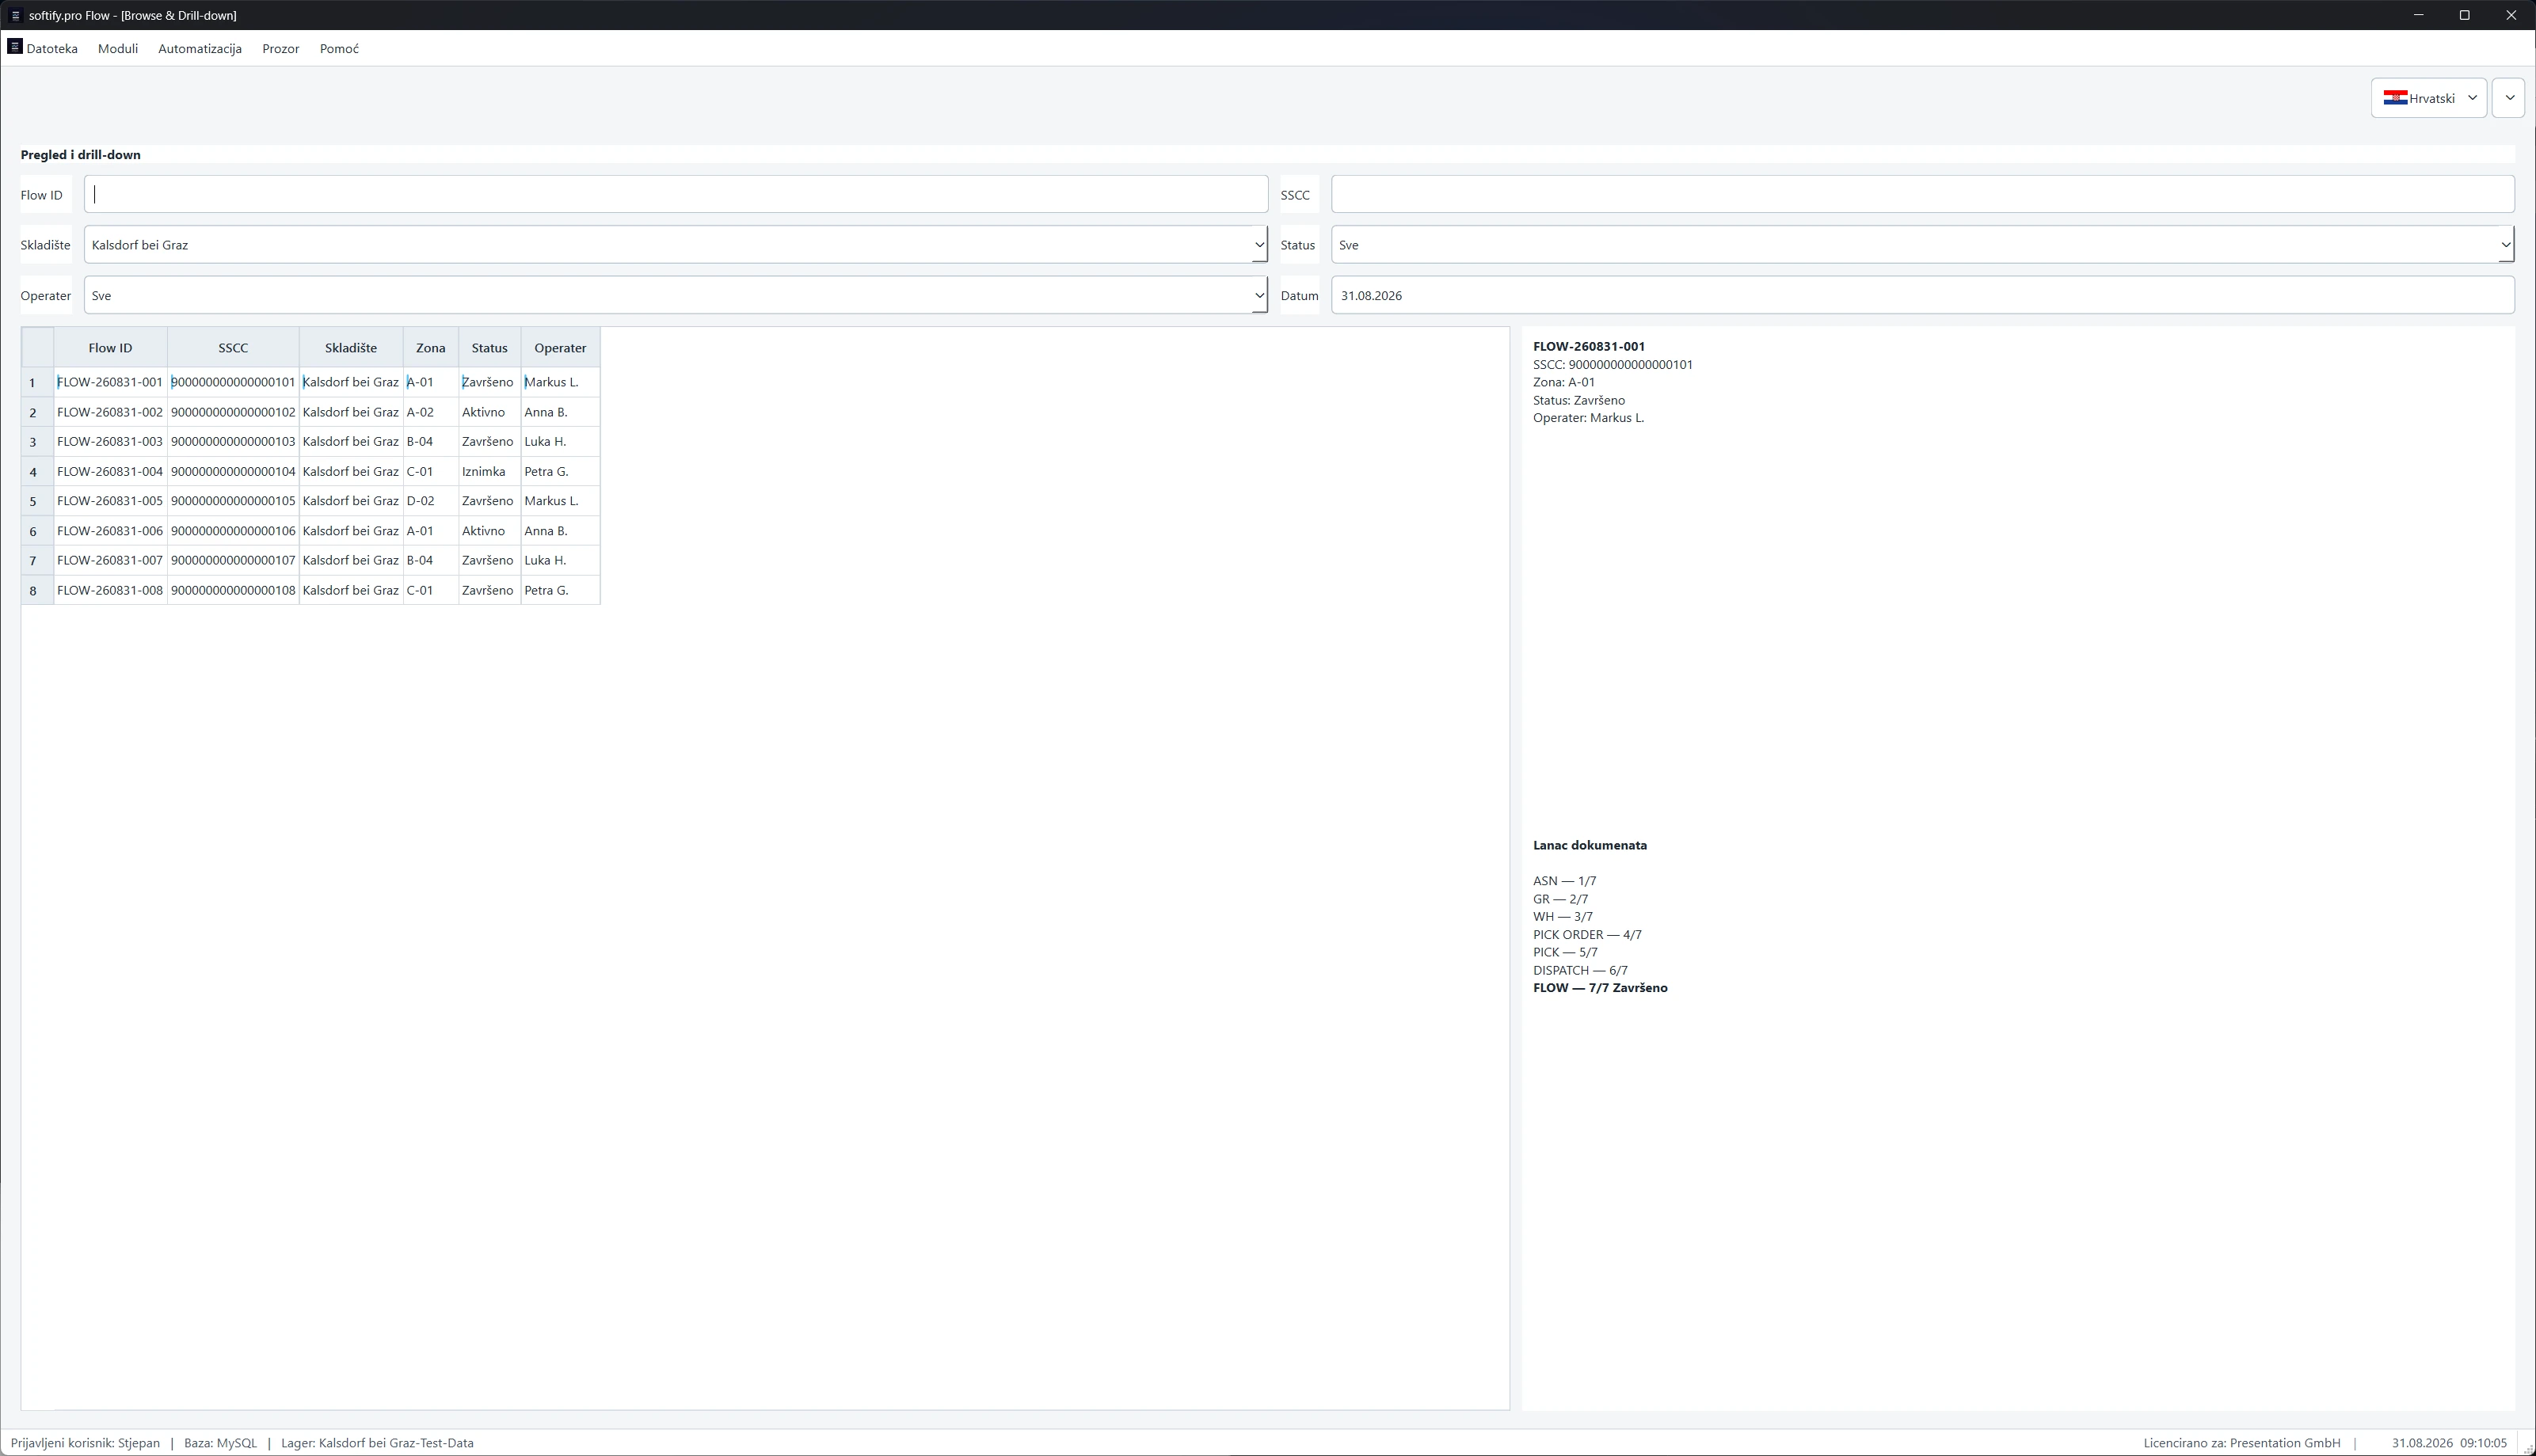
O SSCC torna-se o fio condutor.
À primeira vista, um SSCC parece aquilo que é.
Um identificador.
Um número longo numa tabela.
Mas ao longo do Flow torna-se algo mais útil.
Um fio condutor ao longo do processo.
Siga-o e outras coisas começam a ligar-se.
Um armazém.
Um Flow.
Uma zona.
Um estado.
Um operador.
Uma cadeia de documentos.
Eventualmente, um relatório.
O mesmo objeto logístico físico é agora visível a partir de várias partes diferentes da aplicação.
Útil.
Também perigoso.
Porque cada vista adicional cria mais uma oportunidade para o sistema contar uma história diferente.
E é aí que as coisas ficam interessantes.
Suponhamos que o Analytics diz que o Flow está ativo.
O Drill-down diz que o SSCC pertence a esse Flow.
A cadeia de documentos diz que a operação avançou mais.
O relatório diz outra coisa.
Qual está correto?
Isto não é um problema específico do Flow.
É um dos problemas mais antigos no software empresarial.
Diferentes partes do mesmo sistema desenvolvem gradualmente a sua própria versão da realidade.
Um ecrã lê o estado transacional.
Outro lê um agregado.
Outro depende de dados em cache.
Um relatório calcula algo de forma ligeiramente diferente.
Uma exceção é resolvida operacionalmente mas desaparece dos relatórios.
Cada componente funciona.
O sistema completo mente.
Normalmente de forma educada.
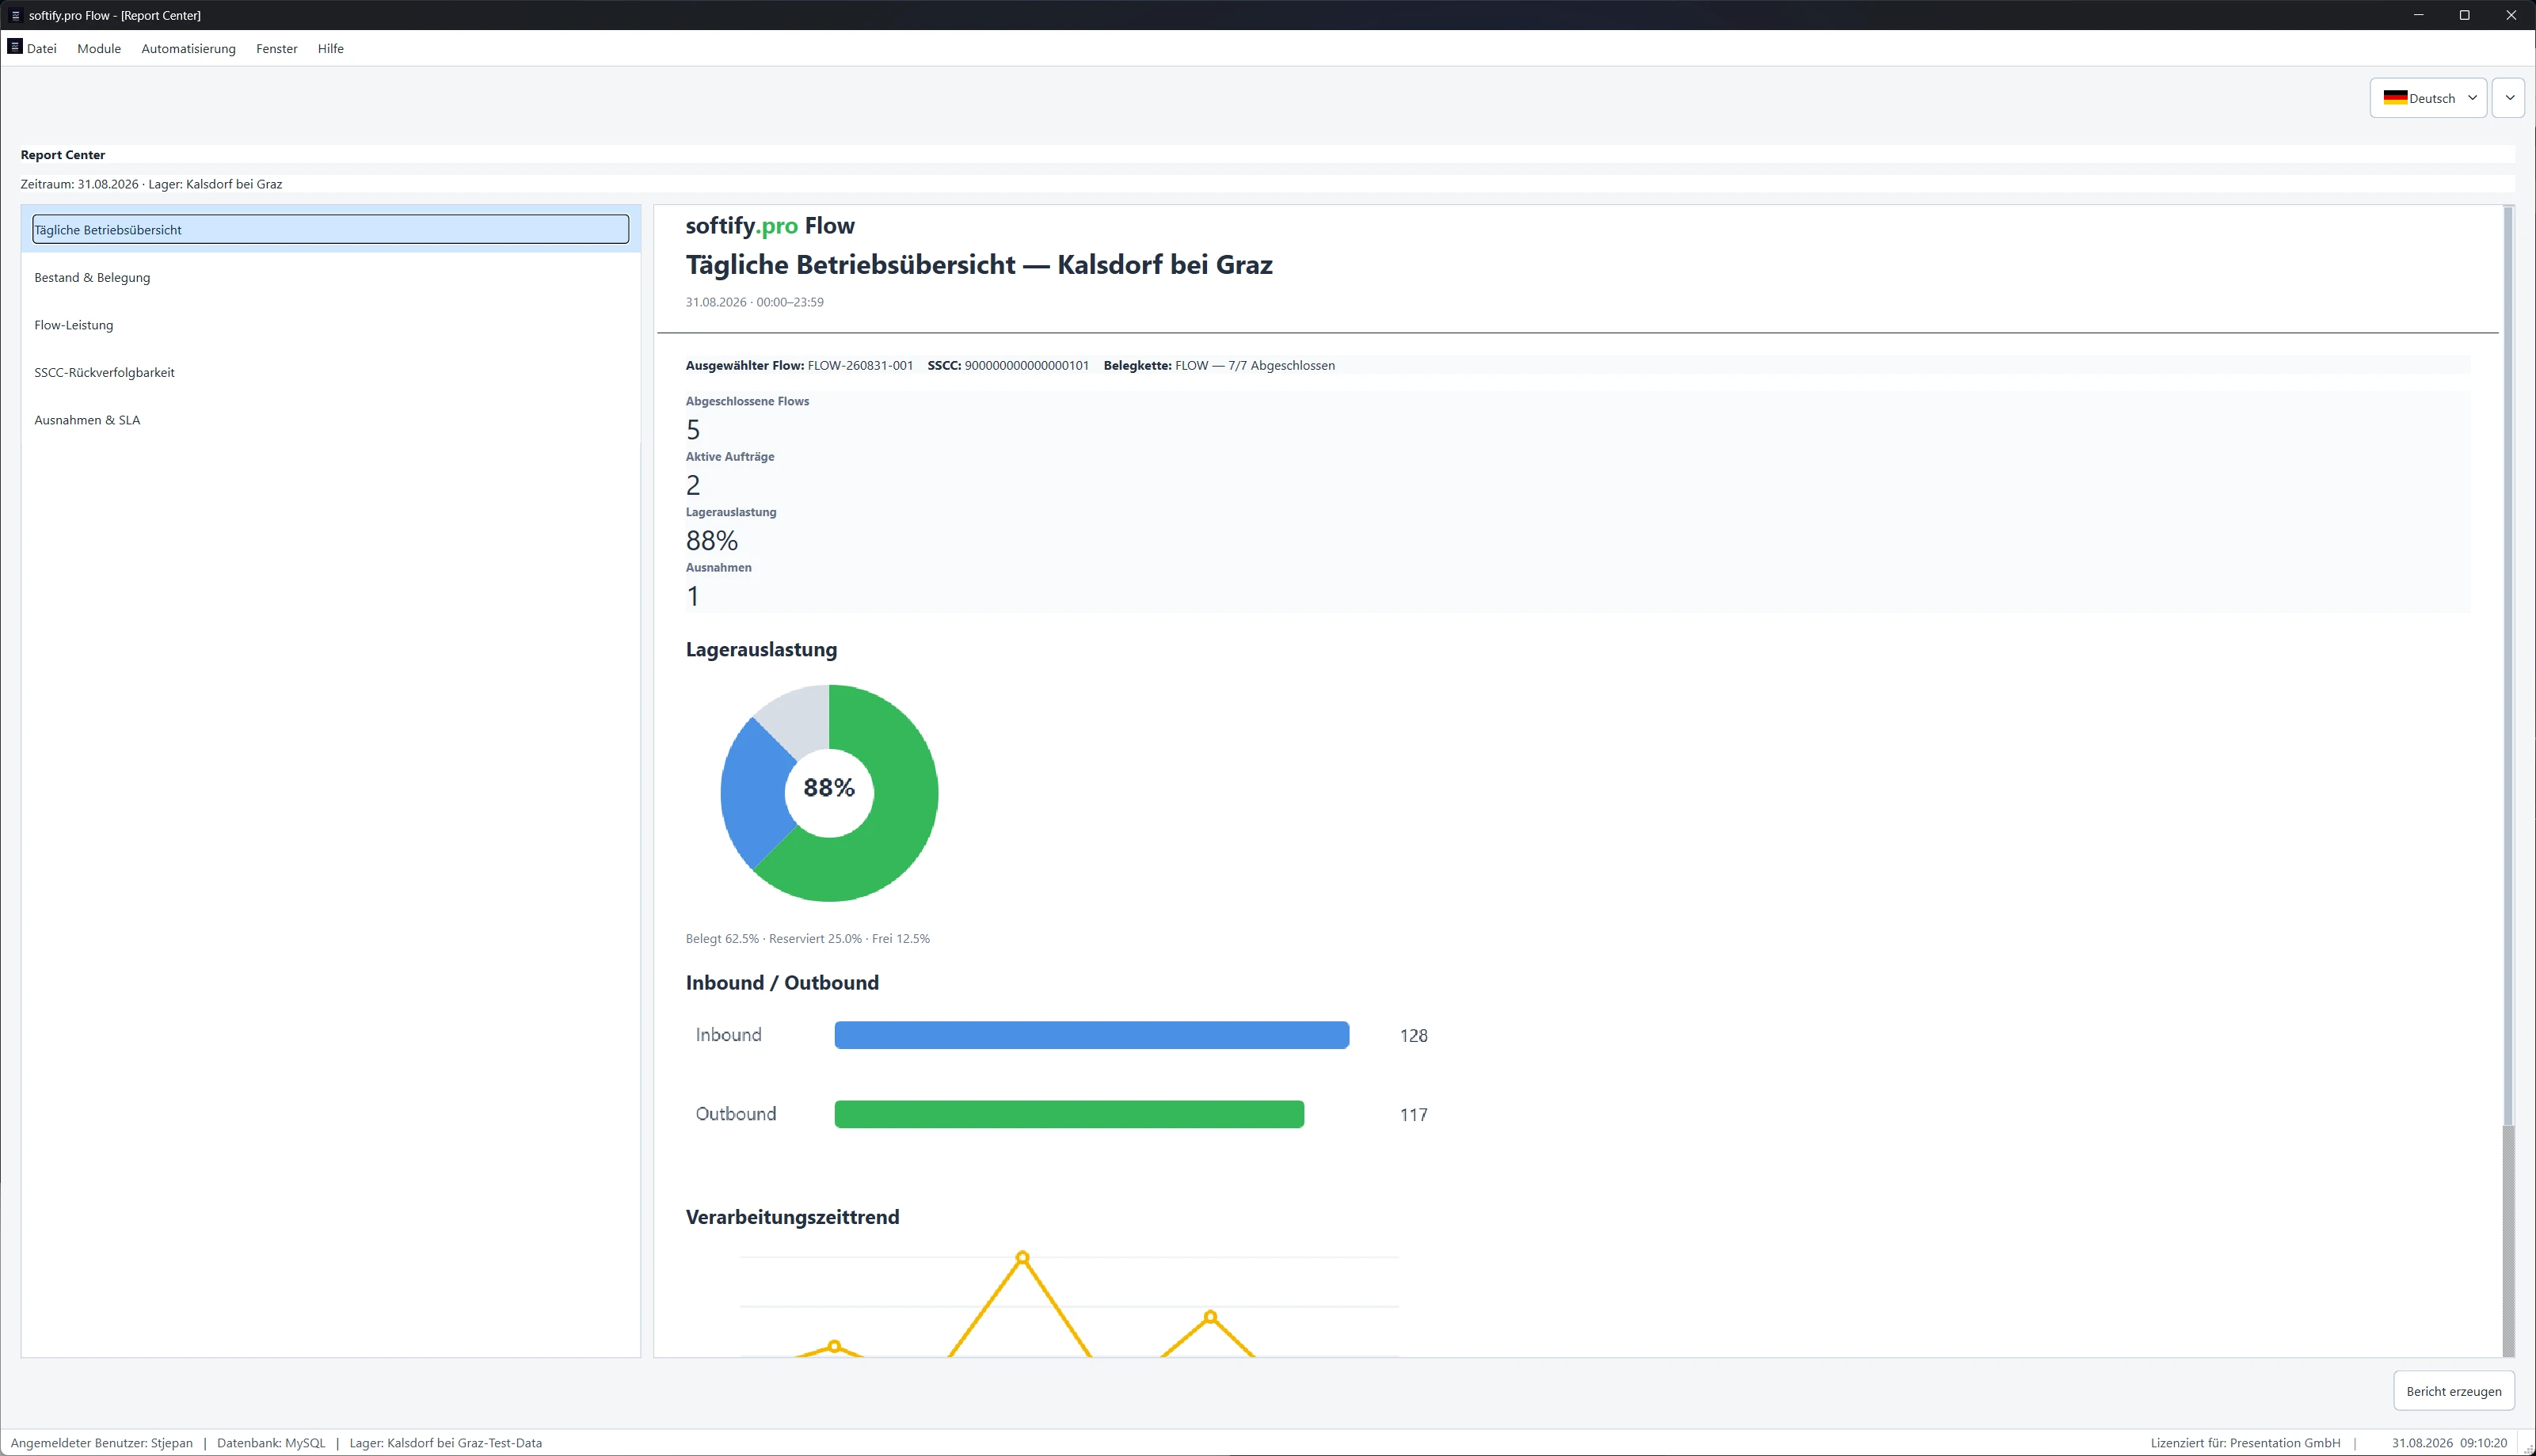
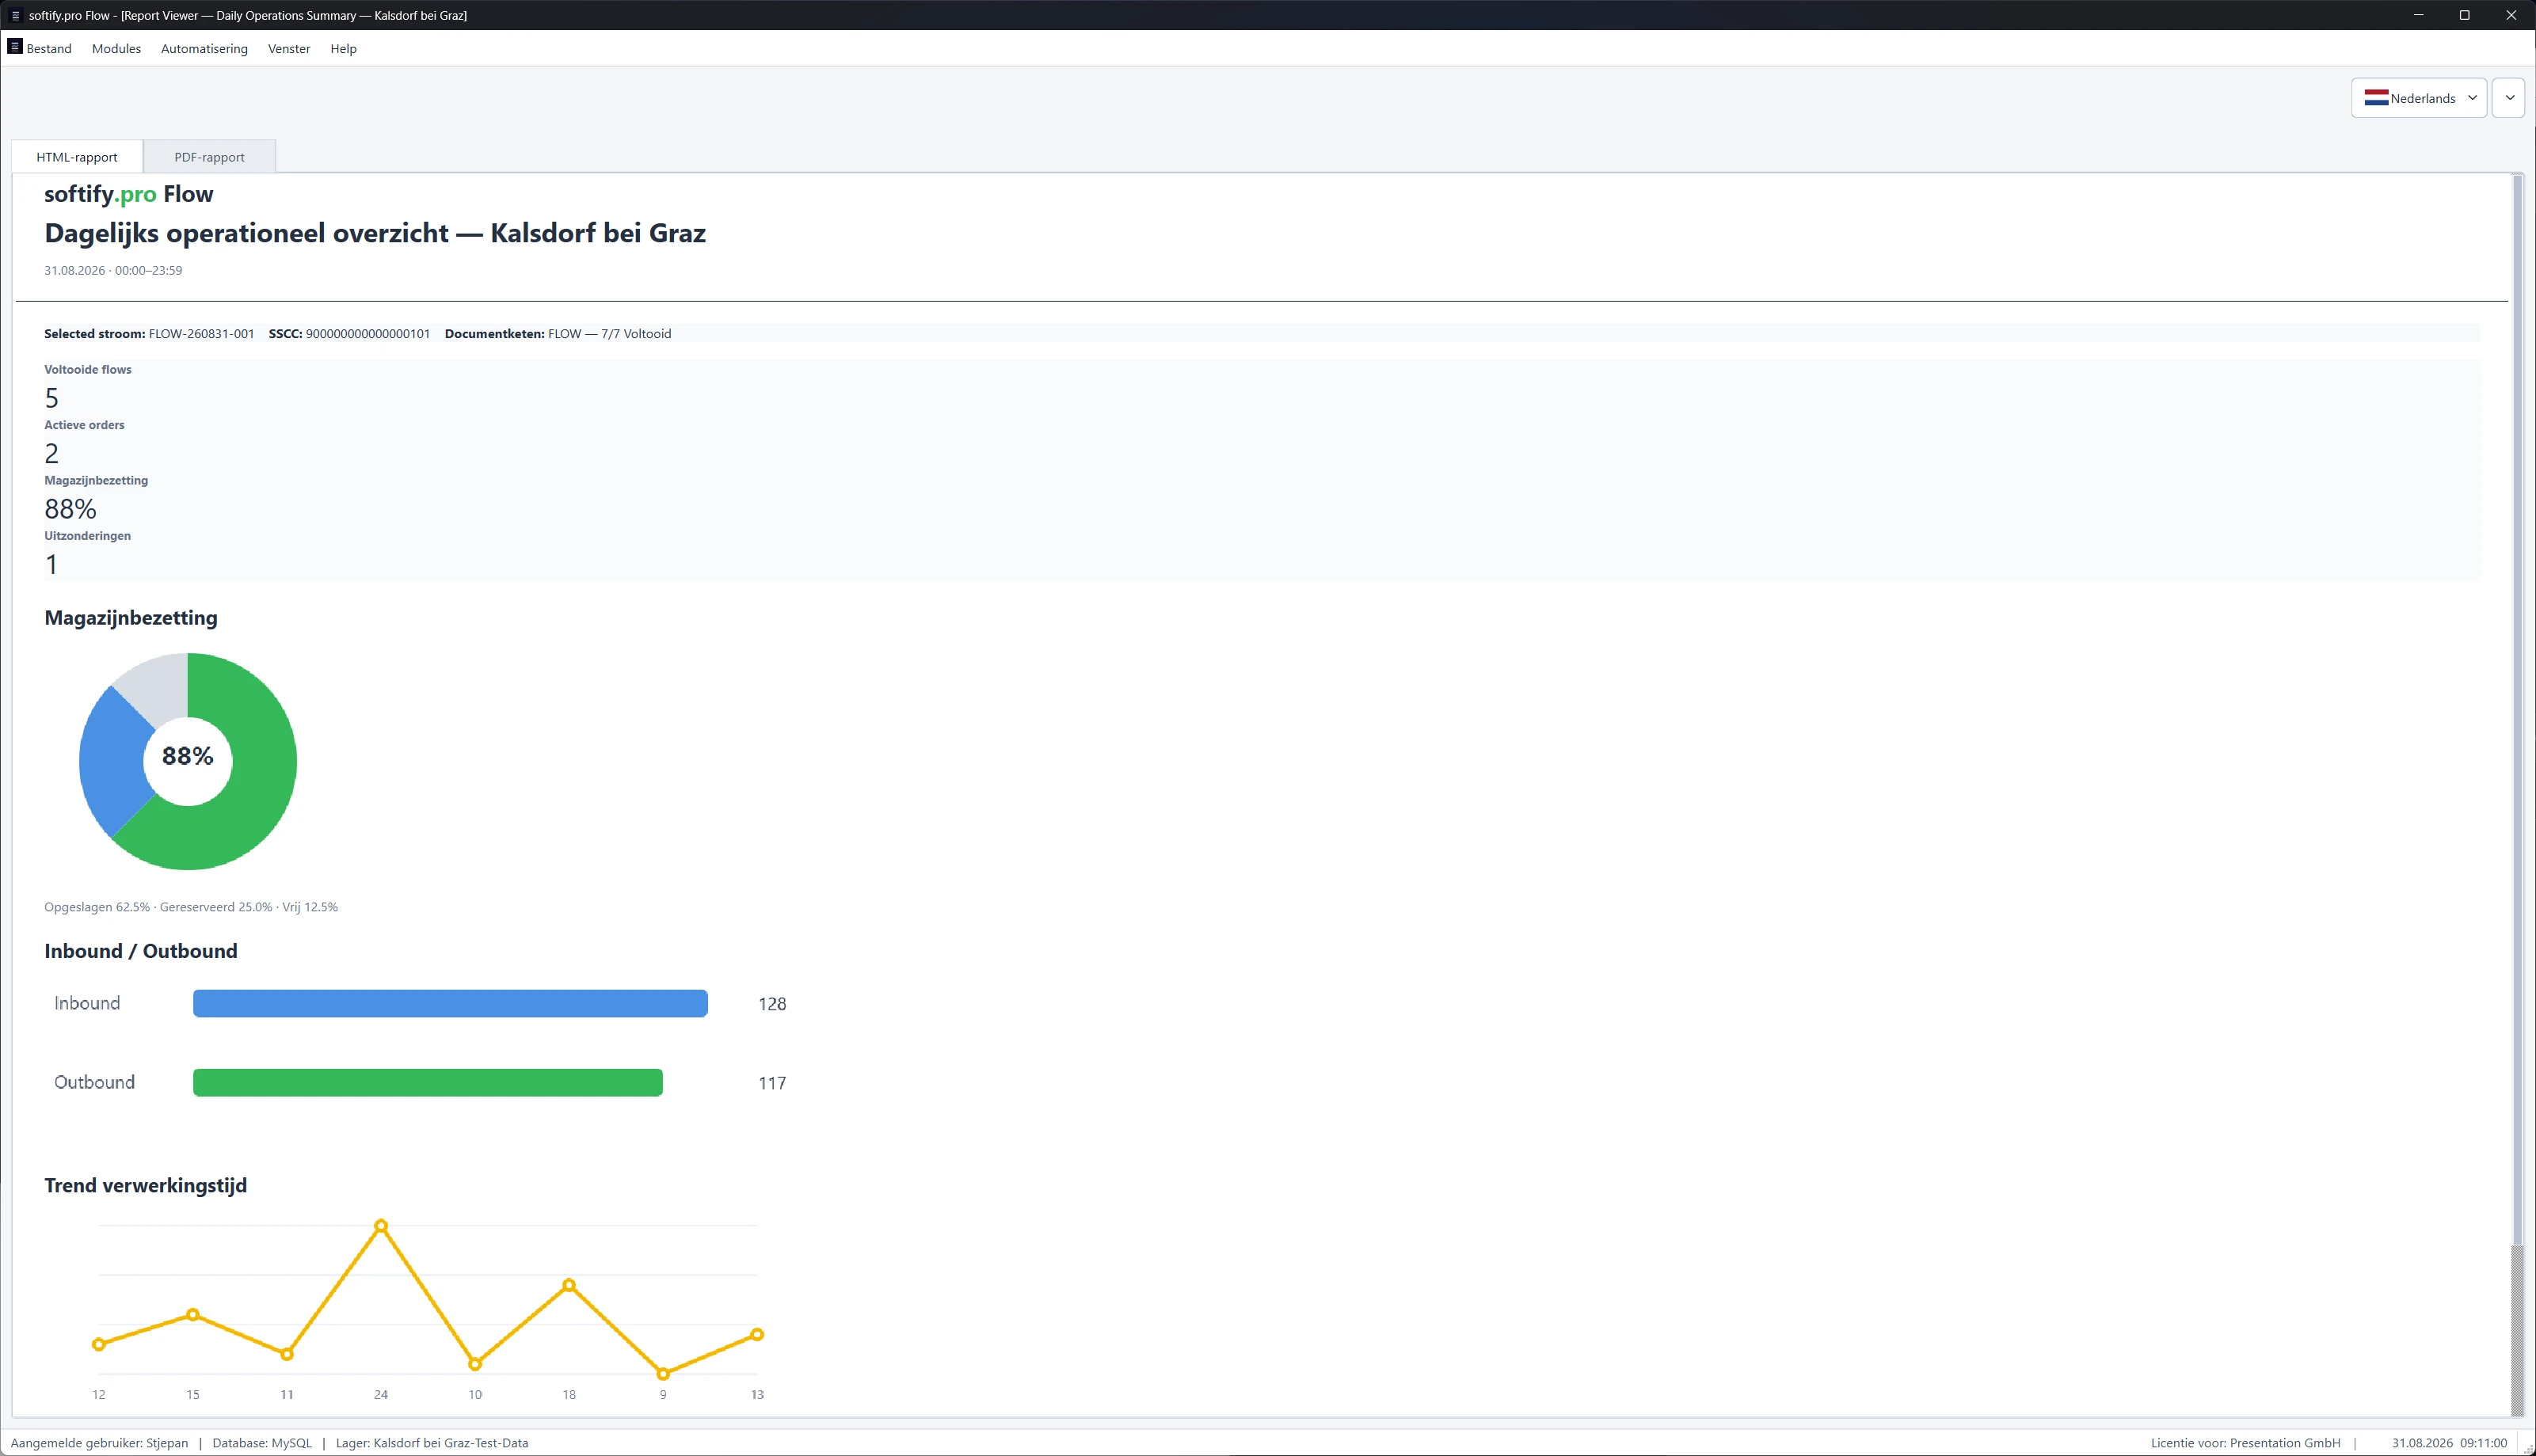
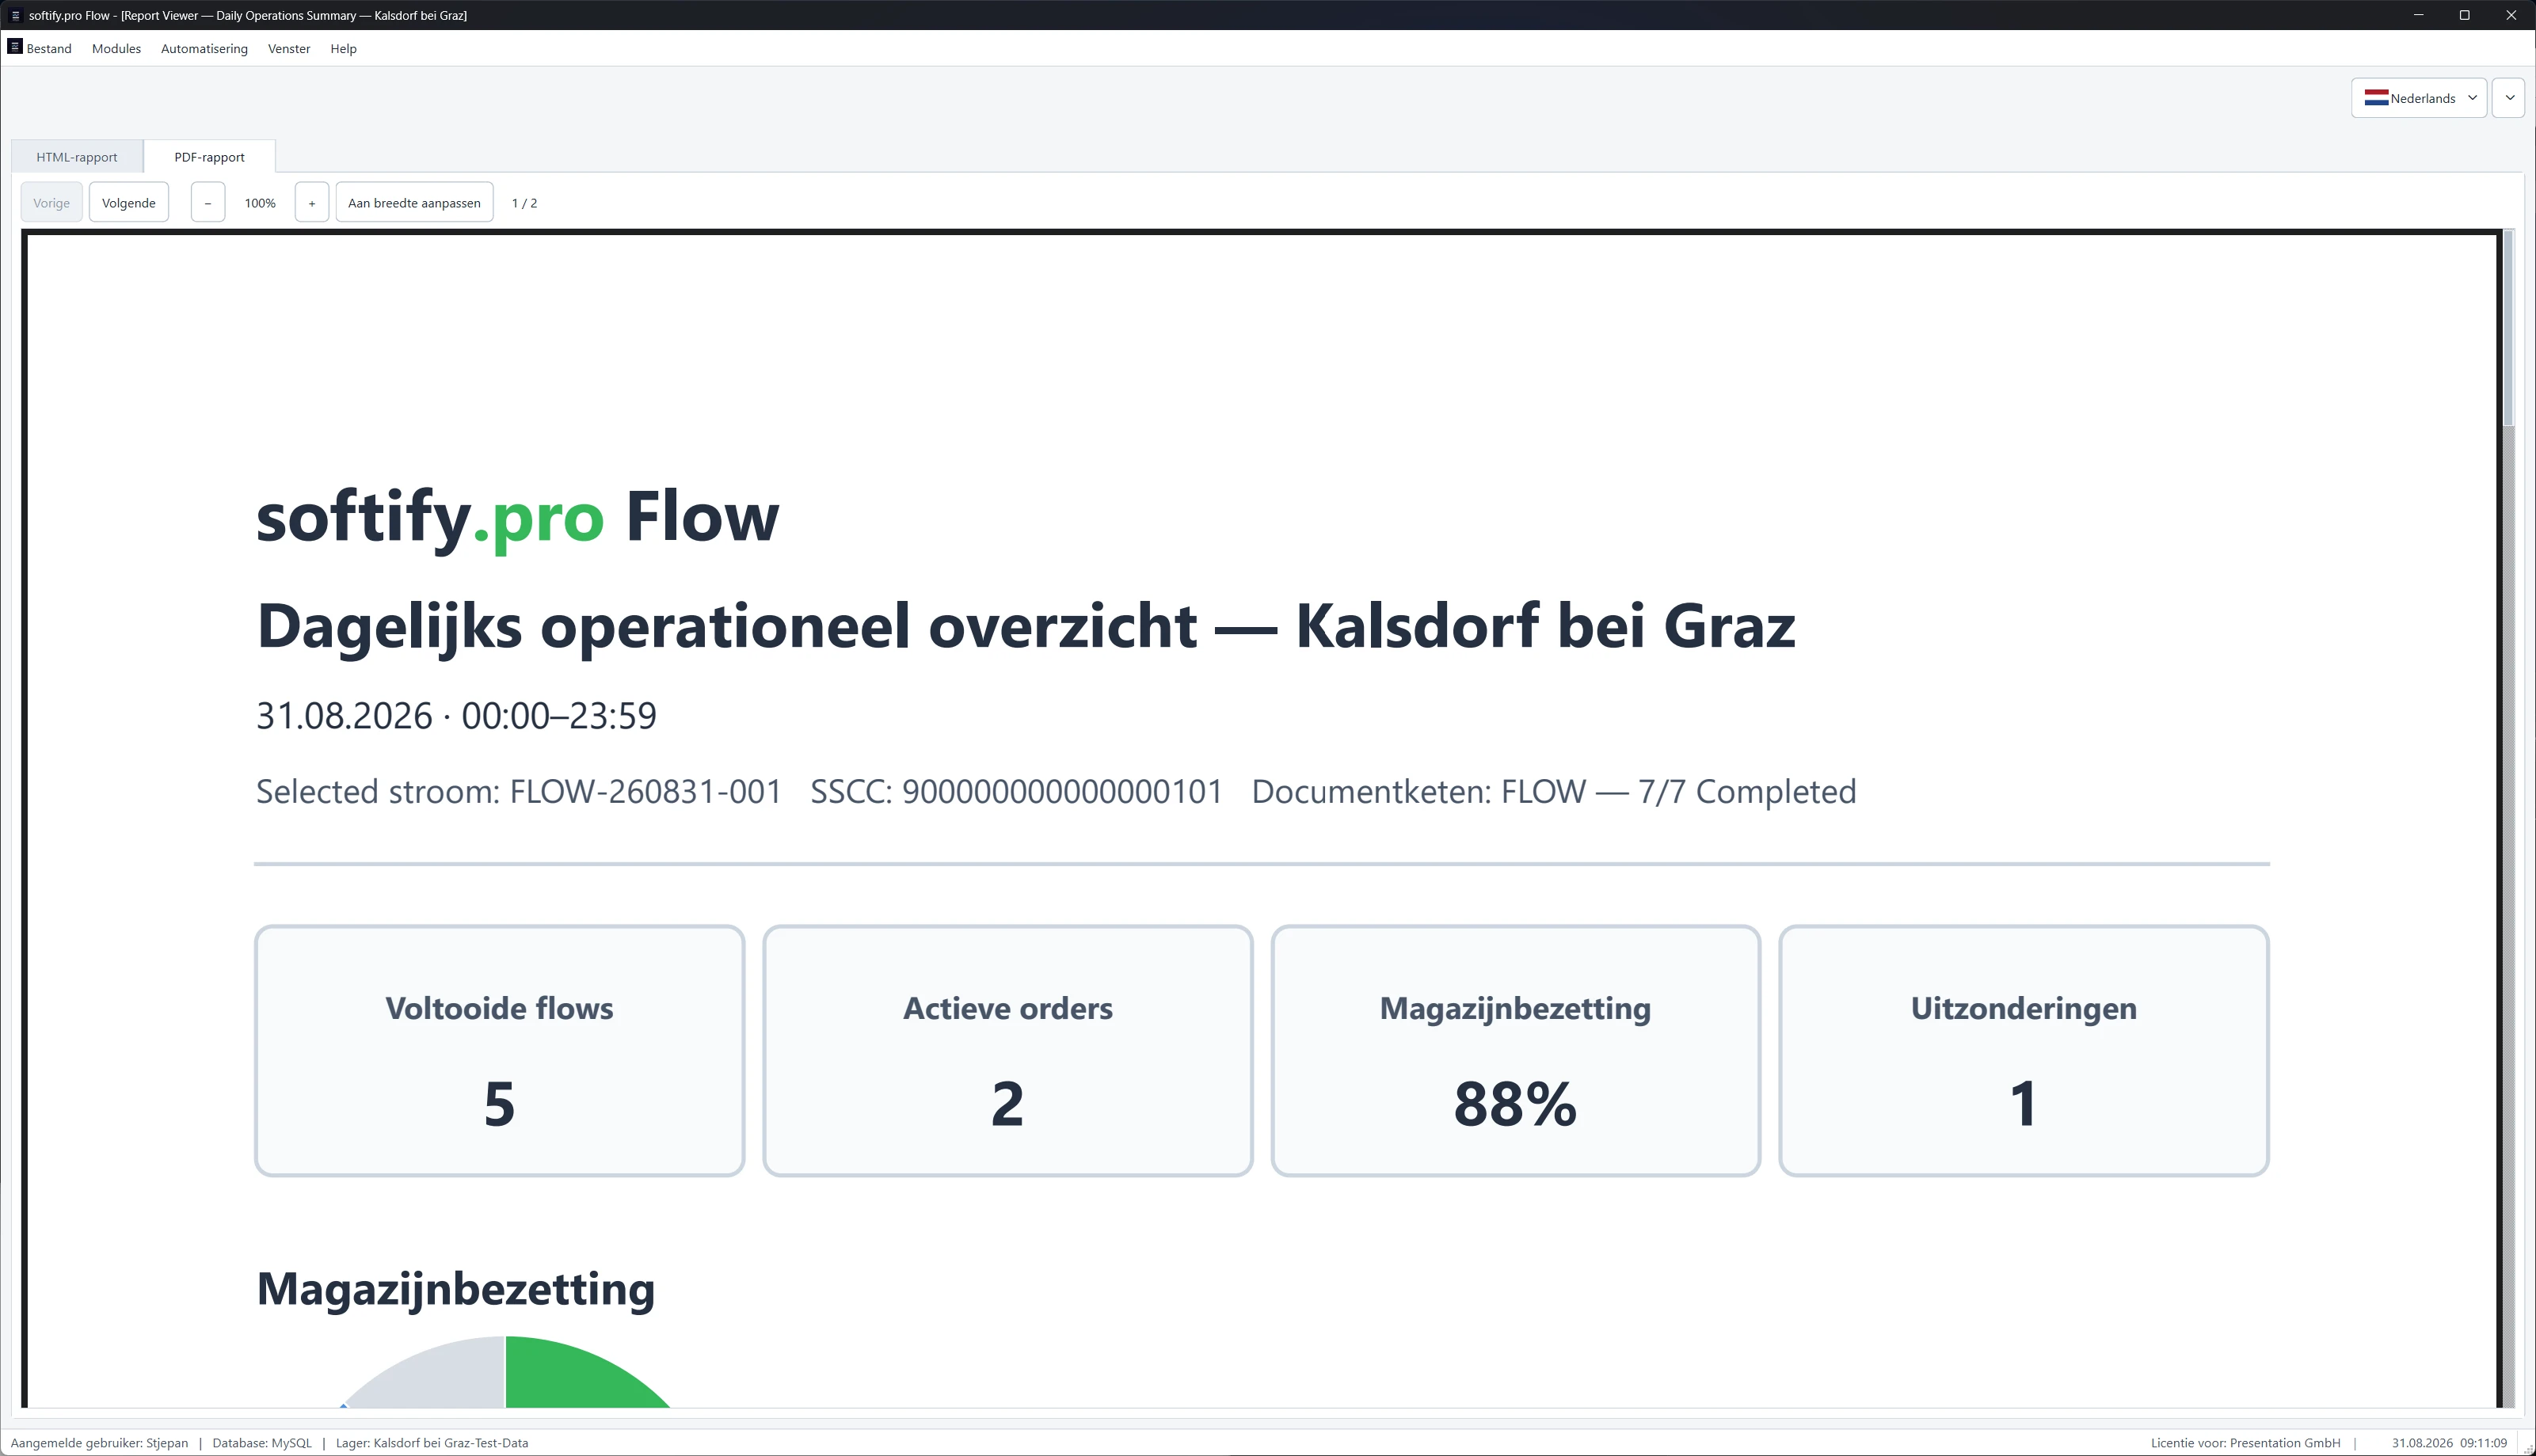
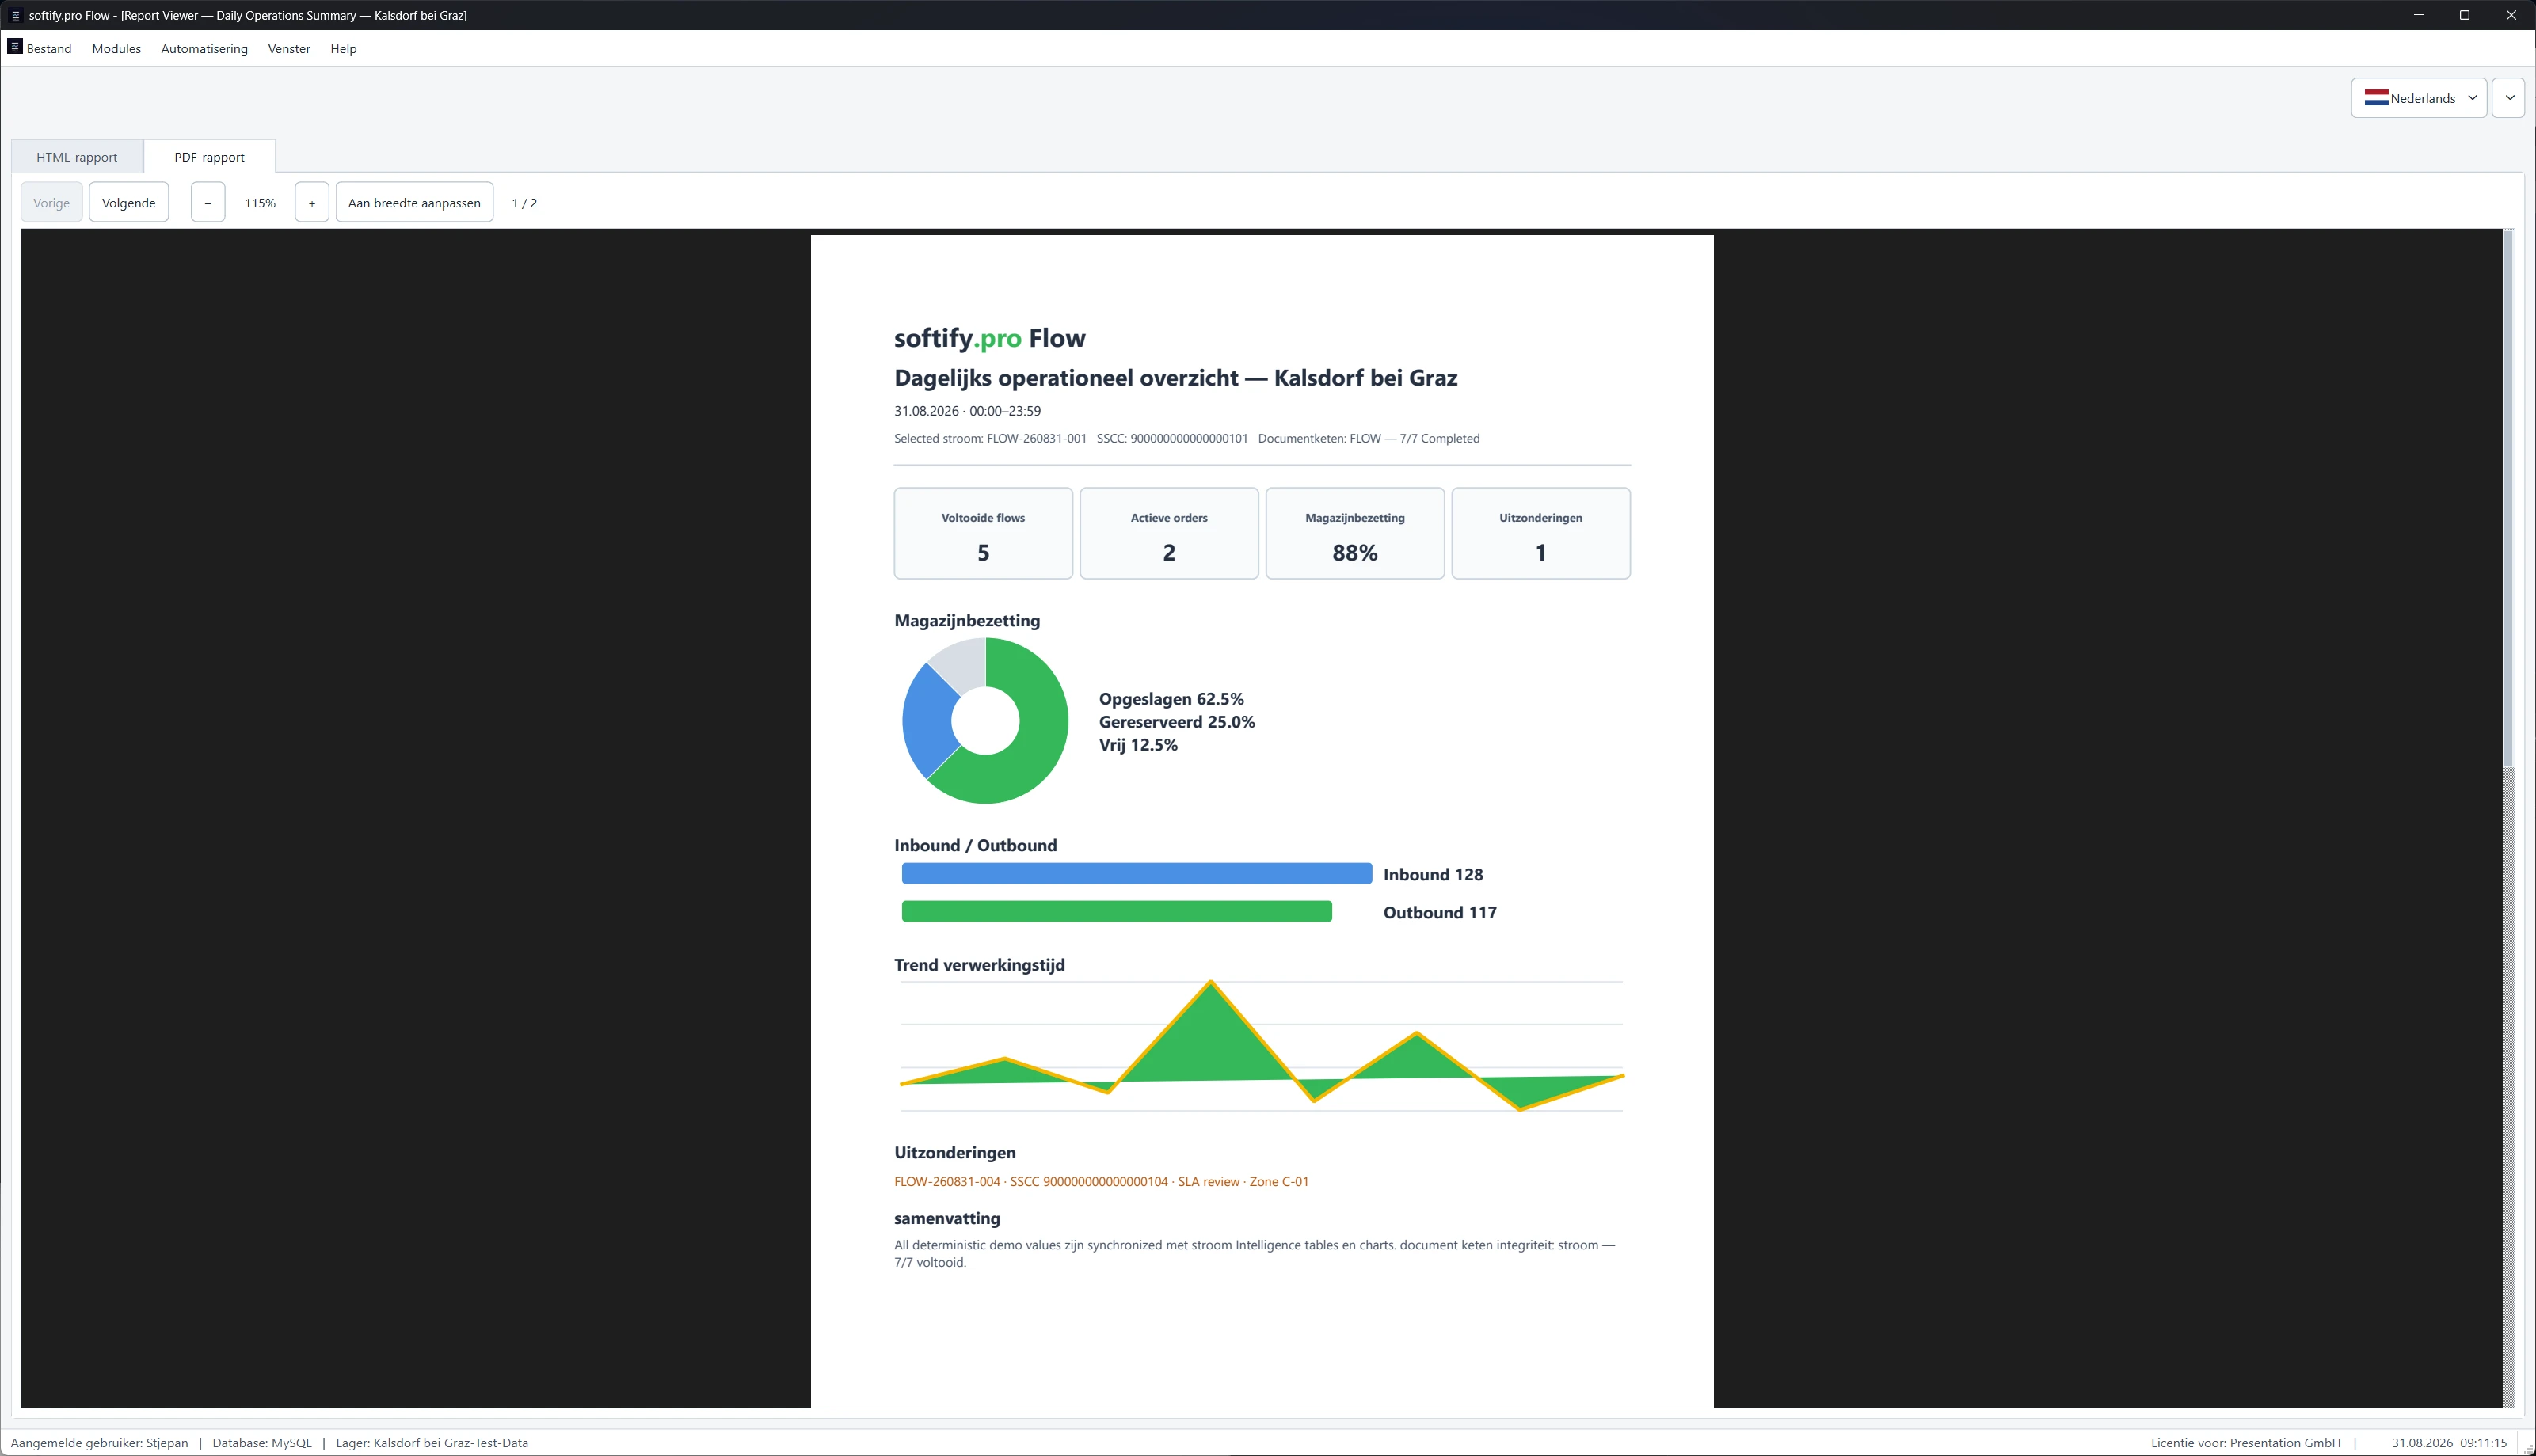
Por isso abrimos o Report Center.
Visão geral operacional diária.
Stock e ocupação.
Desempenho do Flow.
Rastreabilidade SSCC.
Exceções e SLA.
A mesma história operacional apareceu novamente.
Flows concluídos.
Encomendas ativas.
Utilização do armazém.
Exceções.
Entradas.
Saídas.
Tempo de processamento.
Mas desta vez a questão não era se o relatório parecia correto.
A questão era:
Consegue defender-se a si próprio?
Um bom relatório dá-lhe um número.
Um sistema melhor consegue explicar de onde vem esse número.
Relatórios a partir do mesmo estado operacional — não uma segunda versão da realidade.
A exceção continuava lá.
Um dos detalhes mais discretos revelou-se um dos mais importantes.
Os dados de demonstração contêm uma exceção.
Aparece no Analytics.
Aparece no Drill-down.
Aparece na rastreabilidade SSCC.
Aparece no Report Center.
E permanece visível em Exceptions & SLA.
É exatamente isso que deve acontecer.
Recuperar operacionalmente de uma exceção não significa que a exceção deva desaparecer do histórico.
"O processo continuou" e "nada aconteceu" não são a mesma afirmação.
Na logística, essa diferença importa.
Neste ponto, tínhamos um problema de testes.
Não um problema de software.
Um problema de testes.
Tínhamos agora o mesmo armazém representado como:
- analytics,
- Flows individuais,
- históricos SSCC,
- cadeias de documentos,
- relatórios,
- e vistas de exceções.
Cada um podia ser testado independentemente.
Abrir.
Clicar.
Filtrar.
Verificar.
Aprovar.
Seguinte.
Isso seria fácil.
Também perderia a parte interessante.
Porque seis marcas verdes não provam que seis vistas concordam entre si.
Entra o COCO.
Outra vez.
O COCO já tinha lidado com o Flow antes.
Autenticação.
Utilizadores.
Funções.
Ambientes de base de dados.
Idiomas.
Execução em desktop.
Depois veio a logística.
Armazéns.
Inventário.
Picking.
Movimentos.
Exceções.
Documentos.
Ubuntu.
Red Hat Enterprise Linux.
Desta vez demos ao COCO algo ligeiramente diferente.
Não um ecrã para verificar.
Uma história para seguir.
Pega neste armazém.
Pega neste Flow.
Pega neste SSCC.
Abre o Analytics.
Abre o Drill-down.
Muda o idioma.
Olha novamente.
Abre o relatório.
Encontra o mesmo Flow.
Encontra o mesmo SSCC.
Encontra a exceção.
Compara.
Depois compara novamente.
O COCO segue o mesmo contexto operacional através do softify.pro Flow — analytics, rastreabilidade, mudanças de idioma e relatórios.
Isso muda a natureza do teste.
A questão já não é:
- Cada módulo funciona?
Passa a ser:
- Todos os módulos acreditam que aconteceu a mesma coisa?
Uma pergunta muito melhor.
Muito menos confortável.
Um sistema de armazém deve ter uma memória.
Os operadores podem ver posições.
Os gestores de armazém podem ver KPIs.
O suporte pode usar o drill-down.
Os auditores podem usar relatórios.
O COCO pode ver todos eles.
Mas por baixo dessas perspetivas, deve existir um único histórico.
Um Flow não deve adquirir várias biografias consoante o módulo aberto.
Um SSCC não deve ter vários passados.
Uma exceção não deve existir apenas onde é conveniente.
Um armazém não deve tornar-se outro armazém porque o idioma da interface mudou.
É disso que a atual experiência Flow realmente trata.
Não de painéis.
Não de relatórios.
Nem sequer de ecrãs individuais.
De uma única verdade operacional, expressa de formas diferentes.
Controlo.
Conhecer o armazém.
Conhecer o estado.
Saber o que se está a mover.
Saber a que processo pertence.
Clareza.
Transformar KPIs de volta em registos.
Transformar registos em histórico.
Transformar exceções em evidência.
Transformar um SSCC em algo rastreável.
Flow.
Um armazém é selecionado.
O Analytics começa a descrevê-lo.
Um Flow avança.
O SSCC permanece associado.
Uma cadeia de documentos cresce.
Uma exceção aparece.
O processo continua.
O relatório lembra-se.
Depois o idioma muda.
O armazém continua o mesmo.
O Flow continua o mesmo.
O histórico continua o mesmo.
Essa era a parte esperada.
O que aconteceu a seguir foi mais interessante.
O COCO deixou de testar as vistas independentemente.
Começou a compará-las.
Durante algum tempo, nada de notável aconteceu.
Mesmo armazém.
Mesmo Flow.
Mesmo SSCC.
Mesma história.
Outra vez.
Outra vez.
Outra vez.
E depois o COCO parou.
Não porque a aplicação tenha falhado.
Não falhou.
Não porque um teste tenha falhado no sentido habitual.
Não falhou.
Parou porque duas respostas perfeitamente razoáveis produziram uma terceira pergunta.
Sabemos qual é a pergunta.
O Flow sabe porque existe.
O COCO sabe onde procurar a seguir.
O resto pode esperar.
Control. Clarity. Flow.