
Eén magazijn. Eén waarheid.
Er is een eenvoudige manier om magazijnsoftware overtuigend te laten lijken.
Open een dashboard.
Toon een paar groene cijfers.
Voeg een grafiek toe.
Zet wat voorraad op een magazijnkaart.
Sluit af met een rapport.
Alles ziet er goed uit.
En toch kan alles fout zijn.
Want een magazijn maakt het niet uit hoe mooi het dashboard eruitziet.
Het maakt uit of elk onderdeel van het systeem het erover eens is wat er werkelijk is gebeurd.
Dat werd het interessante deel van het nieuwste softify.pro Flow-experiment.
Geen extra scherm.
Geen extra KPI.
Geen extra rapport.
Iets veel minder zichtbaars.
Consistentie.
Het begon met een magazijn.
De huidige softify.pro Flow-demo werkt met meerdere synthetische magazijnomgevingen.
Verschillende magazijn-ID's.
Verschillende capaciteiten.
Verschillende zonestructuren.
Geen productievoorraad.
Geen klantgegevens.
Geen echte operationele informatie.
Maar de proceslogica gedraagt zich alsof dat allemaal ertoe deed.
Want in de echte logistiek doet het dat.
Zodra een magazijn is geselecteerd, wordt die context onderdeel van alles wat volgt.
Flows.
SSCC's.
Bewegingen.
Operators.
Analytics.
Rapporten.
Dat klinkt vanzelfsprekend.
Het wordt aanzienlijk minder vanzelfsprekend zodra hetzelfde proces in meerdere verschillende delen van de applicatie begint te verschijnen.
Toen openden we een andere weergave.
Operational Analytics.
Plotseling zag het magazijn er compleet anders uit.
Geen opslaglocaties.
Geen bewegingspijlen.
In plaats daarvan:
- voltooide Flows,
- actieve orders,
- magazijnbezetting,
- uitzonderingen,
- inbound,
- outbound,
- verwerkingstijd.
De visuele weergave was veranderd.
Het magazijn niet.
Dat onderscheid werd belangrijk.
Want onder de KPI's zaten nog steeds individuele records.
Flow-ID's.
SSCC's.
Zones.
Statussen.
Operators.
Verwerkingstijden.
Andere weergave.
Dezelfde operationele realiteit.
Tot zover ging het goed.
Operational Analytics — geaggregeerde magazijnstatus, met de onderliggende Flow-records nog steeds zichtbaar.
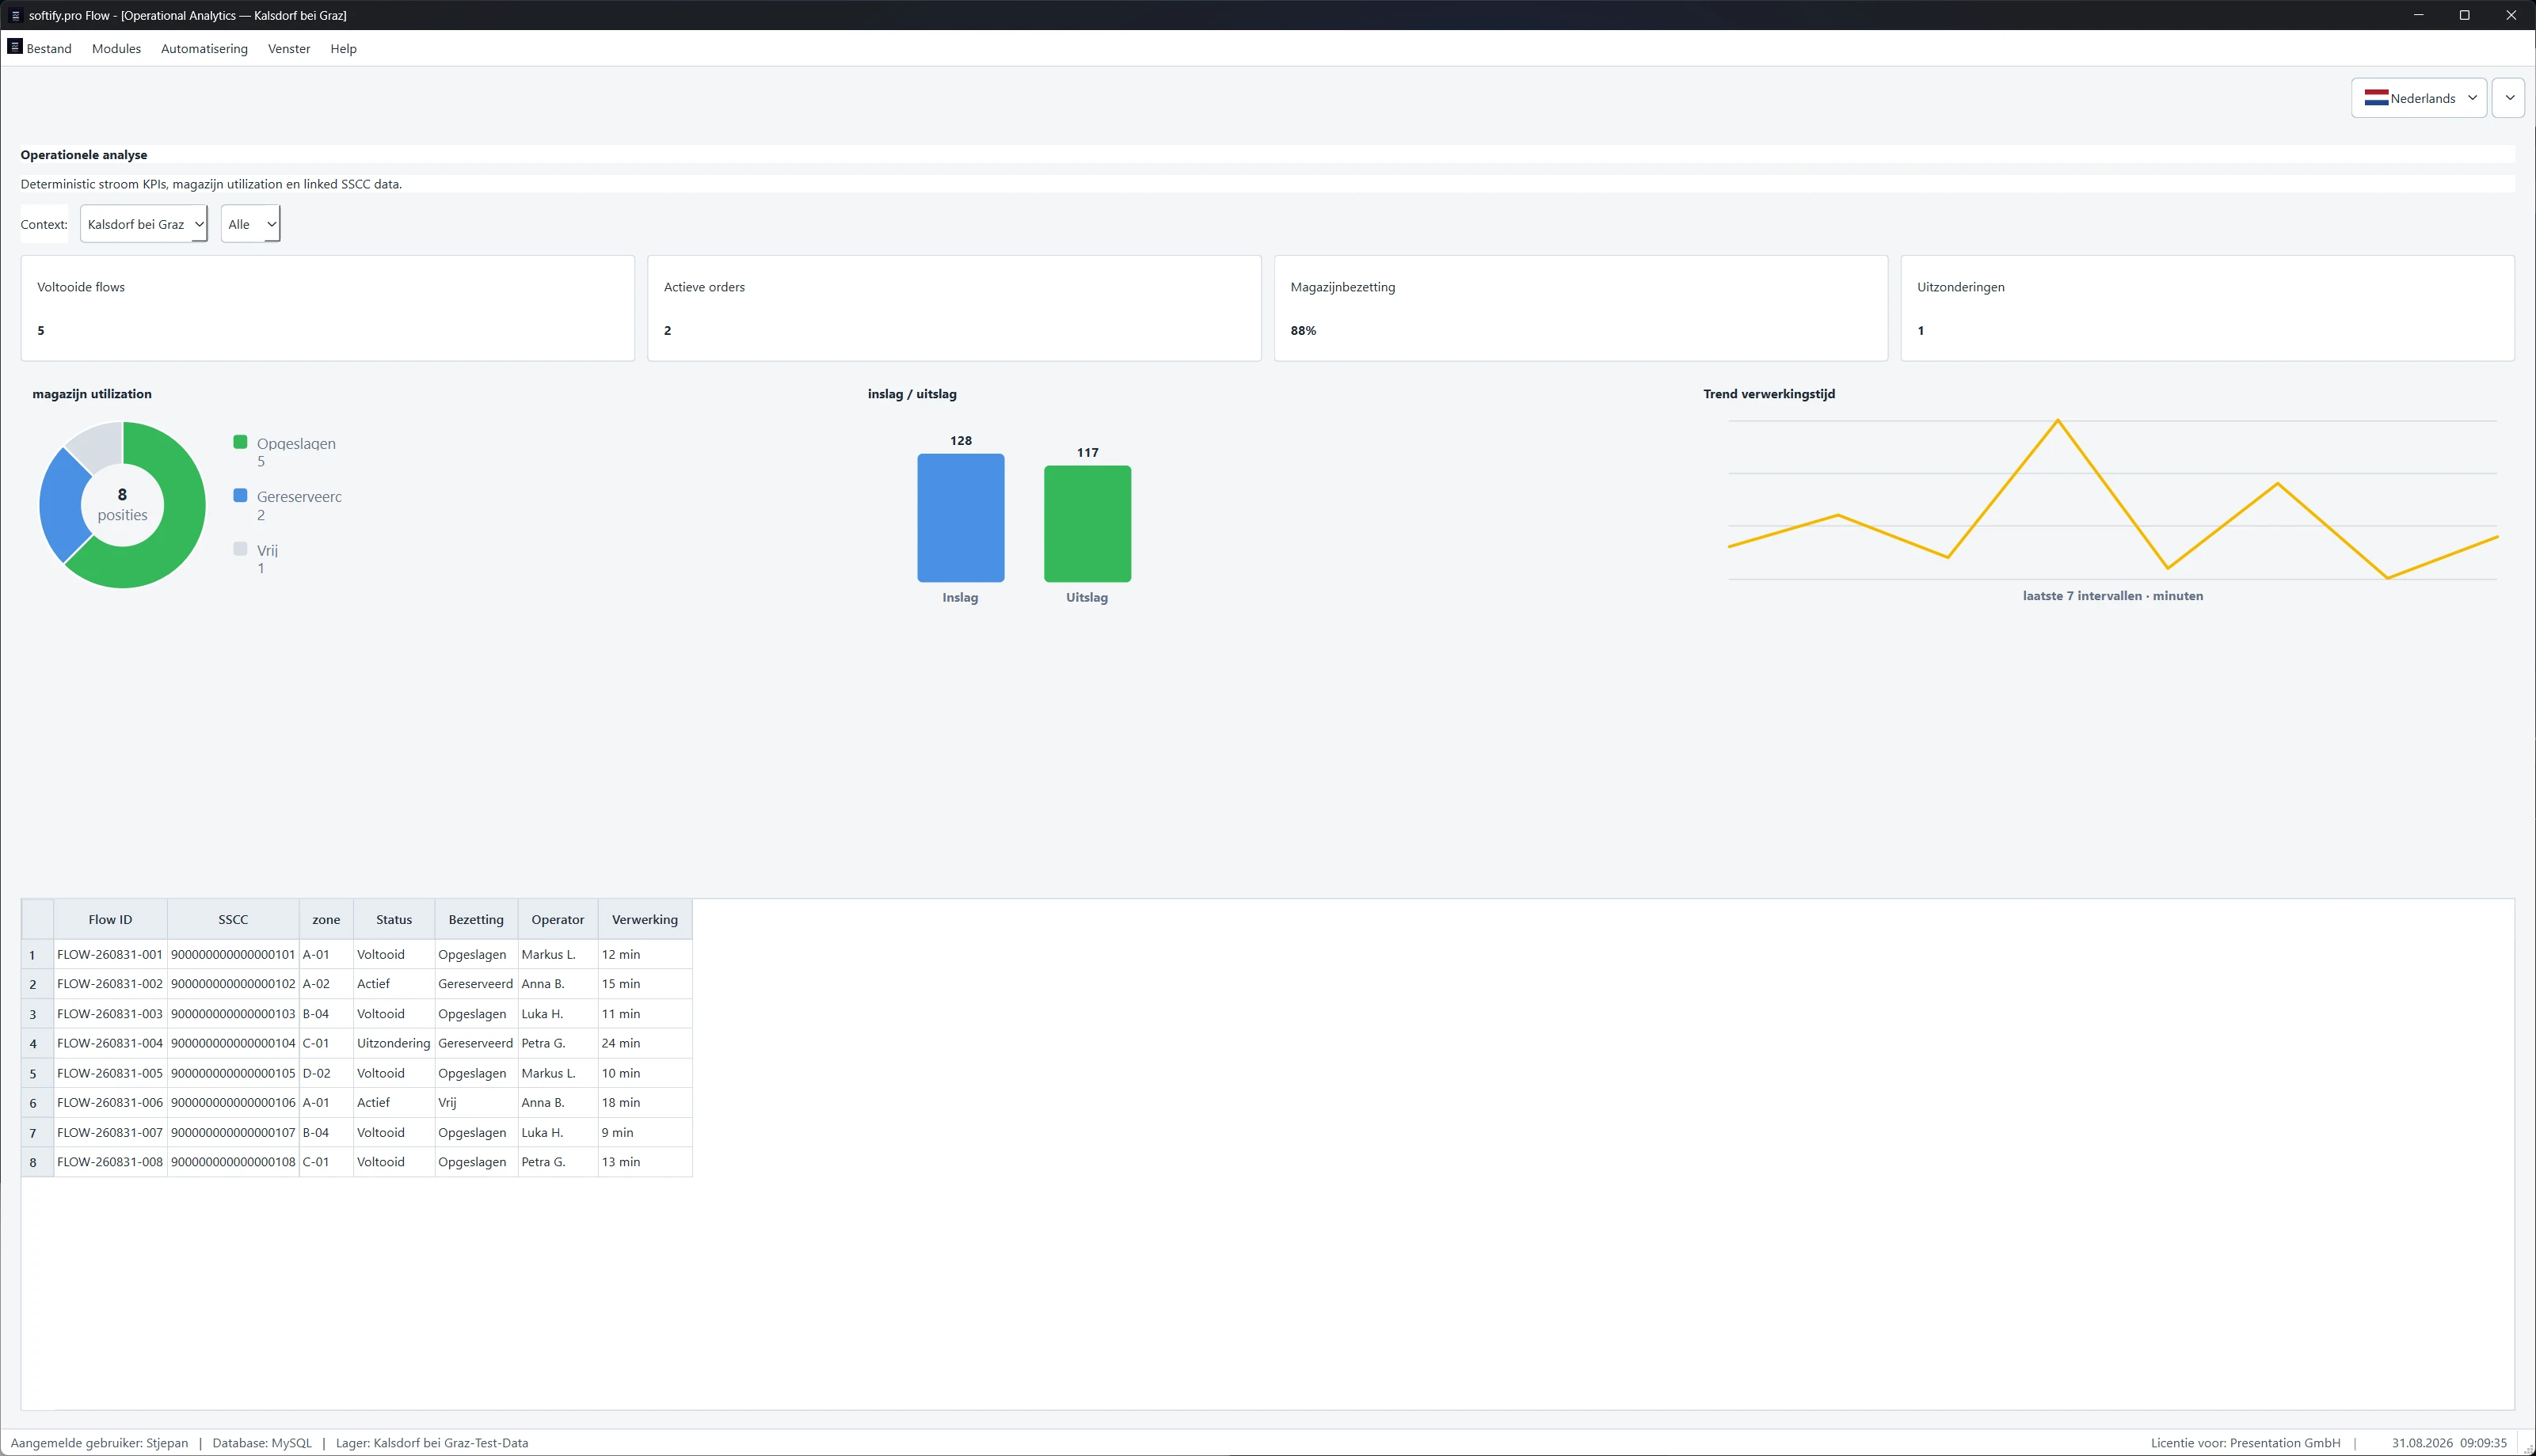
88% is alleen nuttig als het systeem het kan verklaren.
Stel dat het dashboard zegt:
Magazijnbezetting: 88%.
Nuttig.
Maar onvolledig.
Sommige posities zijn bezet.
Sommige zijn gereserveerd.
Sommige blijven vrij.
Die statussen zijn niet inwisselbaar.
Het getal wordt pas betrouwbaar als het systeem nog kan uitleggen waar het vandaan komt.
Vijf voltooide Flows?
Laat ze zien.
Twee actieve orders?
Laat ze zien.
Eén uitzondering?
Welke?
88% bezetting?
Wat is bezet?
Wat is gereserveerd?
Wat blijft vrij?
Een dashboard zou de realiteit moeten samenvatten.
Het zou haar niet moeten vervangen.
Toen veranderden we de taal.
Nederlands.
Het magazijn bleef hetzelfde.
De Flow-ID's bleven hetzelfde.
De SSCC's bleven hetzelfde.
De operators bleven aan hun records gekoppeld.
Alleen de taal veranderde.
Later verscheen dezelfde operationele status in het Kroatisch.
Toen in het Frans.
Hier wordt meertalige software veel interessanter dan vertaalde knoppen.
Een slechte vertaling valt gemakkelijk op.
Een statuswijziging veroorzaakt door een taalwissel is veel gevaarlijker.
Stel je voor dat je van Duits naar Frans wisselt en stilletjes de geselecteerde Flow verliest.
Of een filter opnieuw opbouwt tegen het verkeerde magazijn.
Of de juiste SSCC toont binnen de verkeerde procescontext.
De interface kan er nog steeds perfect uitzien.
Het systeem zou dat niet zijn.
Flow volgt daarom een eenvoudige regel:
Taal mag de woorden veranderen. Ze mag niet de waarheid veranderen.
Toen kreeg de Flow een geschiedenis.
Browse & Drill-down doet niet bijzonder zijn best om indrukwekkend te lijken.
Misschien is dat precies waarom het nuttig is.
Selecteer een Flow.
De context ervan verschijnt.
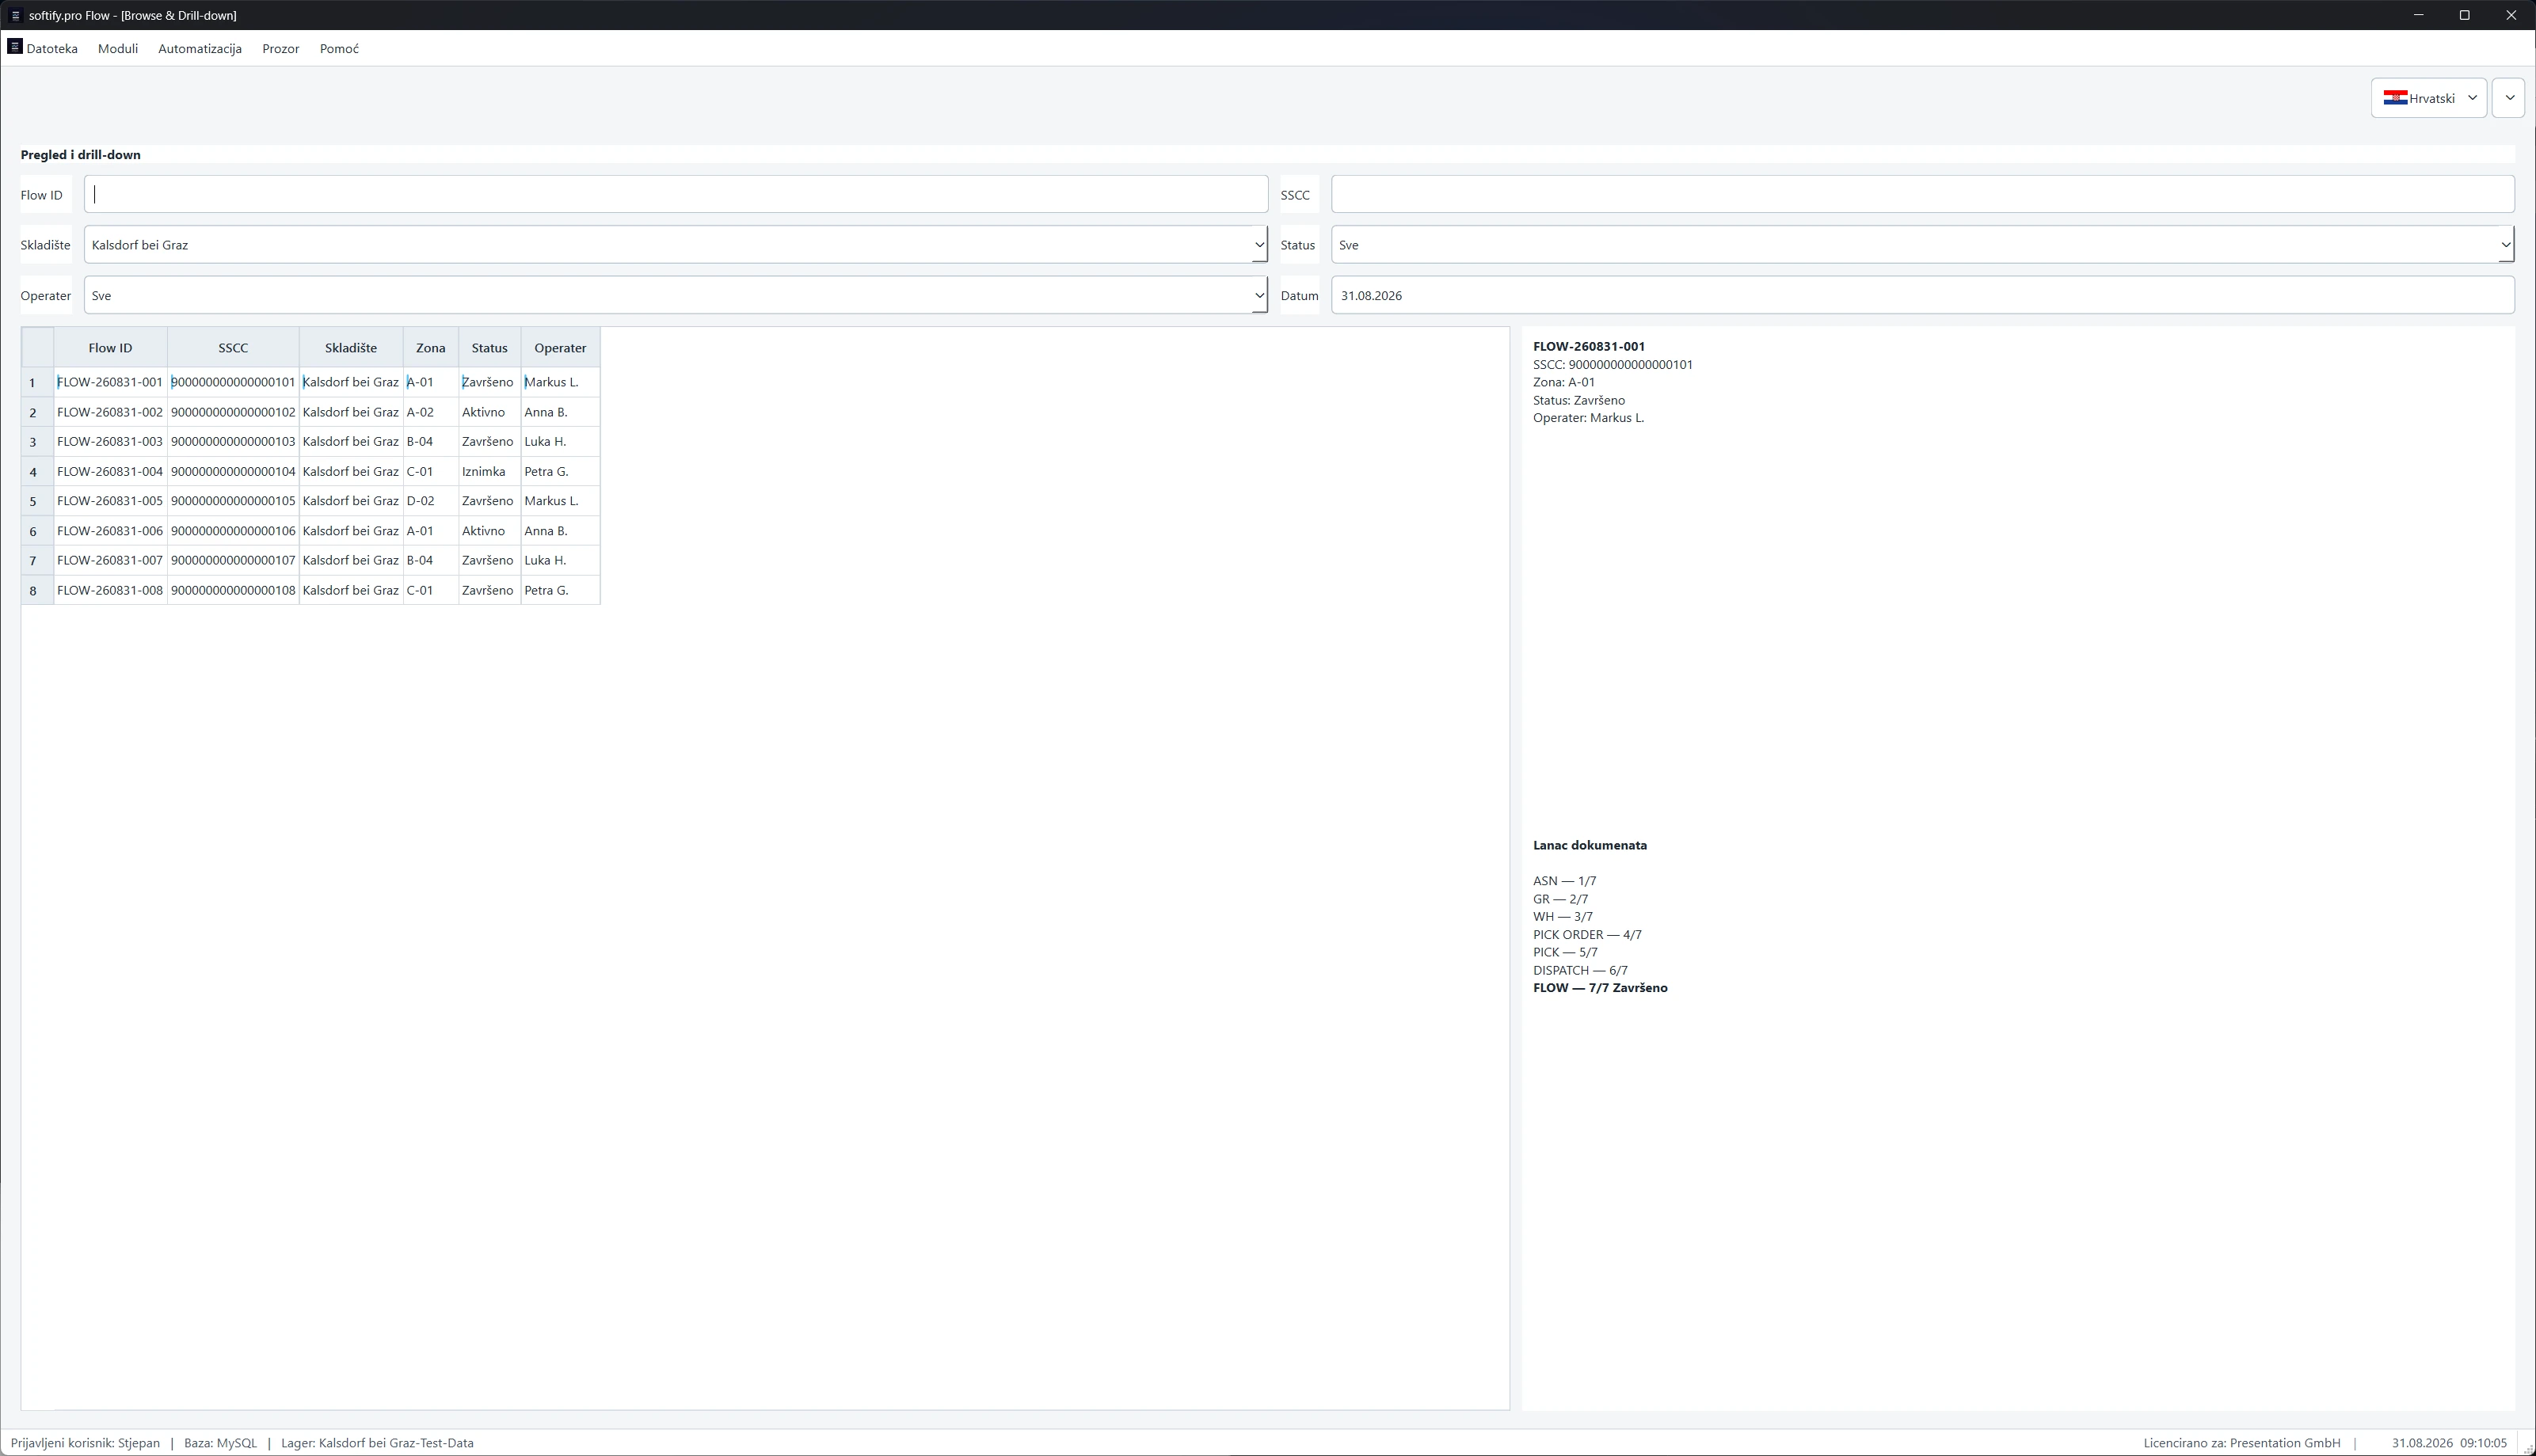
Magazijn.
Zone.
Status.
Operator.
SSCC.
En dan de documentketen.
ASN.
Goederenontvangst.
Magazijnbeweging.
Pickorder.
Picken.
Verzending.
FLOW.
Zeven stappen.
Het proces is niet langer slechts een huidige status.
Het heeft een verleden.
En dat verandert de vraag.
In plaats van:
Wat gebeurt er?
kunnen we vragen:
Hoe zijn we hier gekomen?
Dat is een veel betere vraag wanneer er uiteindelijk iets misgaat.
Eén Flow, één SSCC, één documentketen — van ASN tot afronding.
SSCC wordt de rode draad.
Op het eerste gezicht ziet een SSCC eruit zoals het is.
Een identificatiecode.
Een lang nummer in een tabel.
Maar over Flow heen wordt het iets nuttigers.
Een rode draad door het proces.
Volg hem en andere dingen beginnen zich te verbinden.
Een magazijn.
Een Flow.
Een zone.
Een status.
Een operator.
Een documentketen.
Uiteindelijk een rapport.
Hetzelfde fysieke logistieke object is nu zichtbaar vanuit meerdere verschillende delen van de applicatie.
Nuttig.
Ook gevaarlijk.
Want elke extra weergave creëert weer een kans voor het systeem om een ander verhaal te vertellen.
En daar wordt het interessant.
Stel dat Analytics zegt dat de Flow actief is.
Drill-down zegt dat de SSCC bij die Flow hoort.
De documentketen zegt dat de operatie verder gevorderd is.
Het rapport zegt iets anders.
Wat klopt er?
Dit is geen Flow-specifiek probleem.
Het is een van de oudste problemen in bedrijfssoftware.
Verschillende delen van hetzelfde systeem ontwikkelen geleidelijk hun eigen versie van de werkelijkheid.
Het ene scherm leest de transactionele status.
Een ander leest een aggregaat.
Weer een ander vertrouwt op gecachte gegevens.
Een rapport berekent iets net iets anders.
Een uitzondering wordt operationeel opgelost maar verdwijnt uit de rapportage.
Elk onderdeel werkt.
Het complete systeem liegt.
Meestal beleefd.
Dus openden we het Report Center.
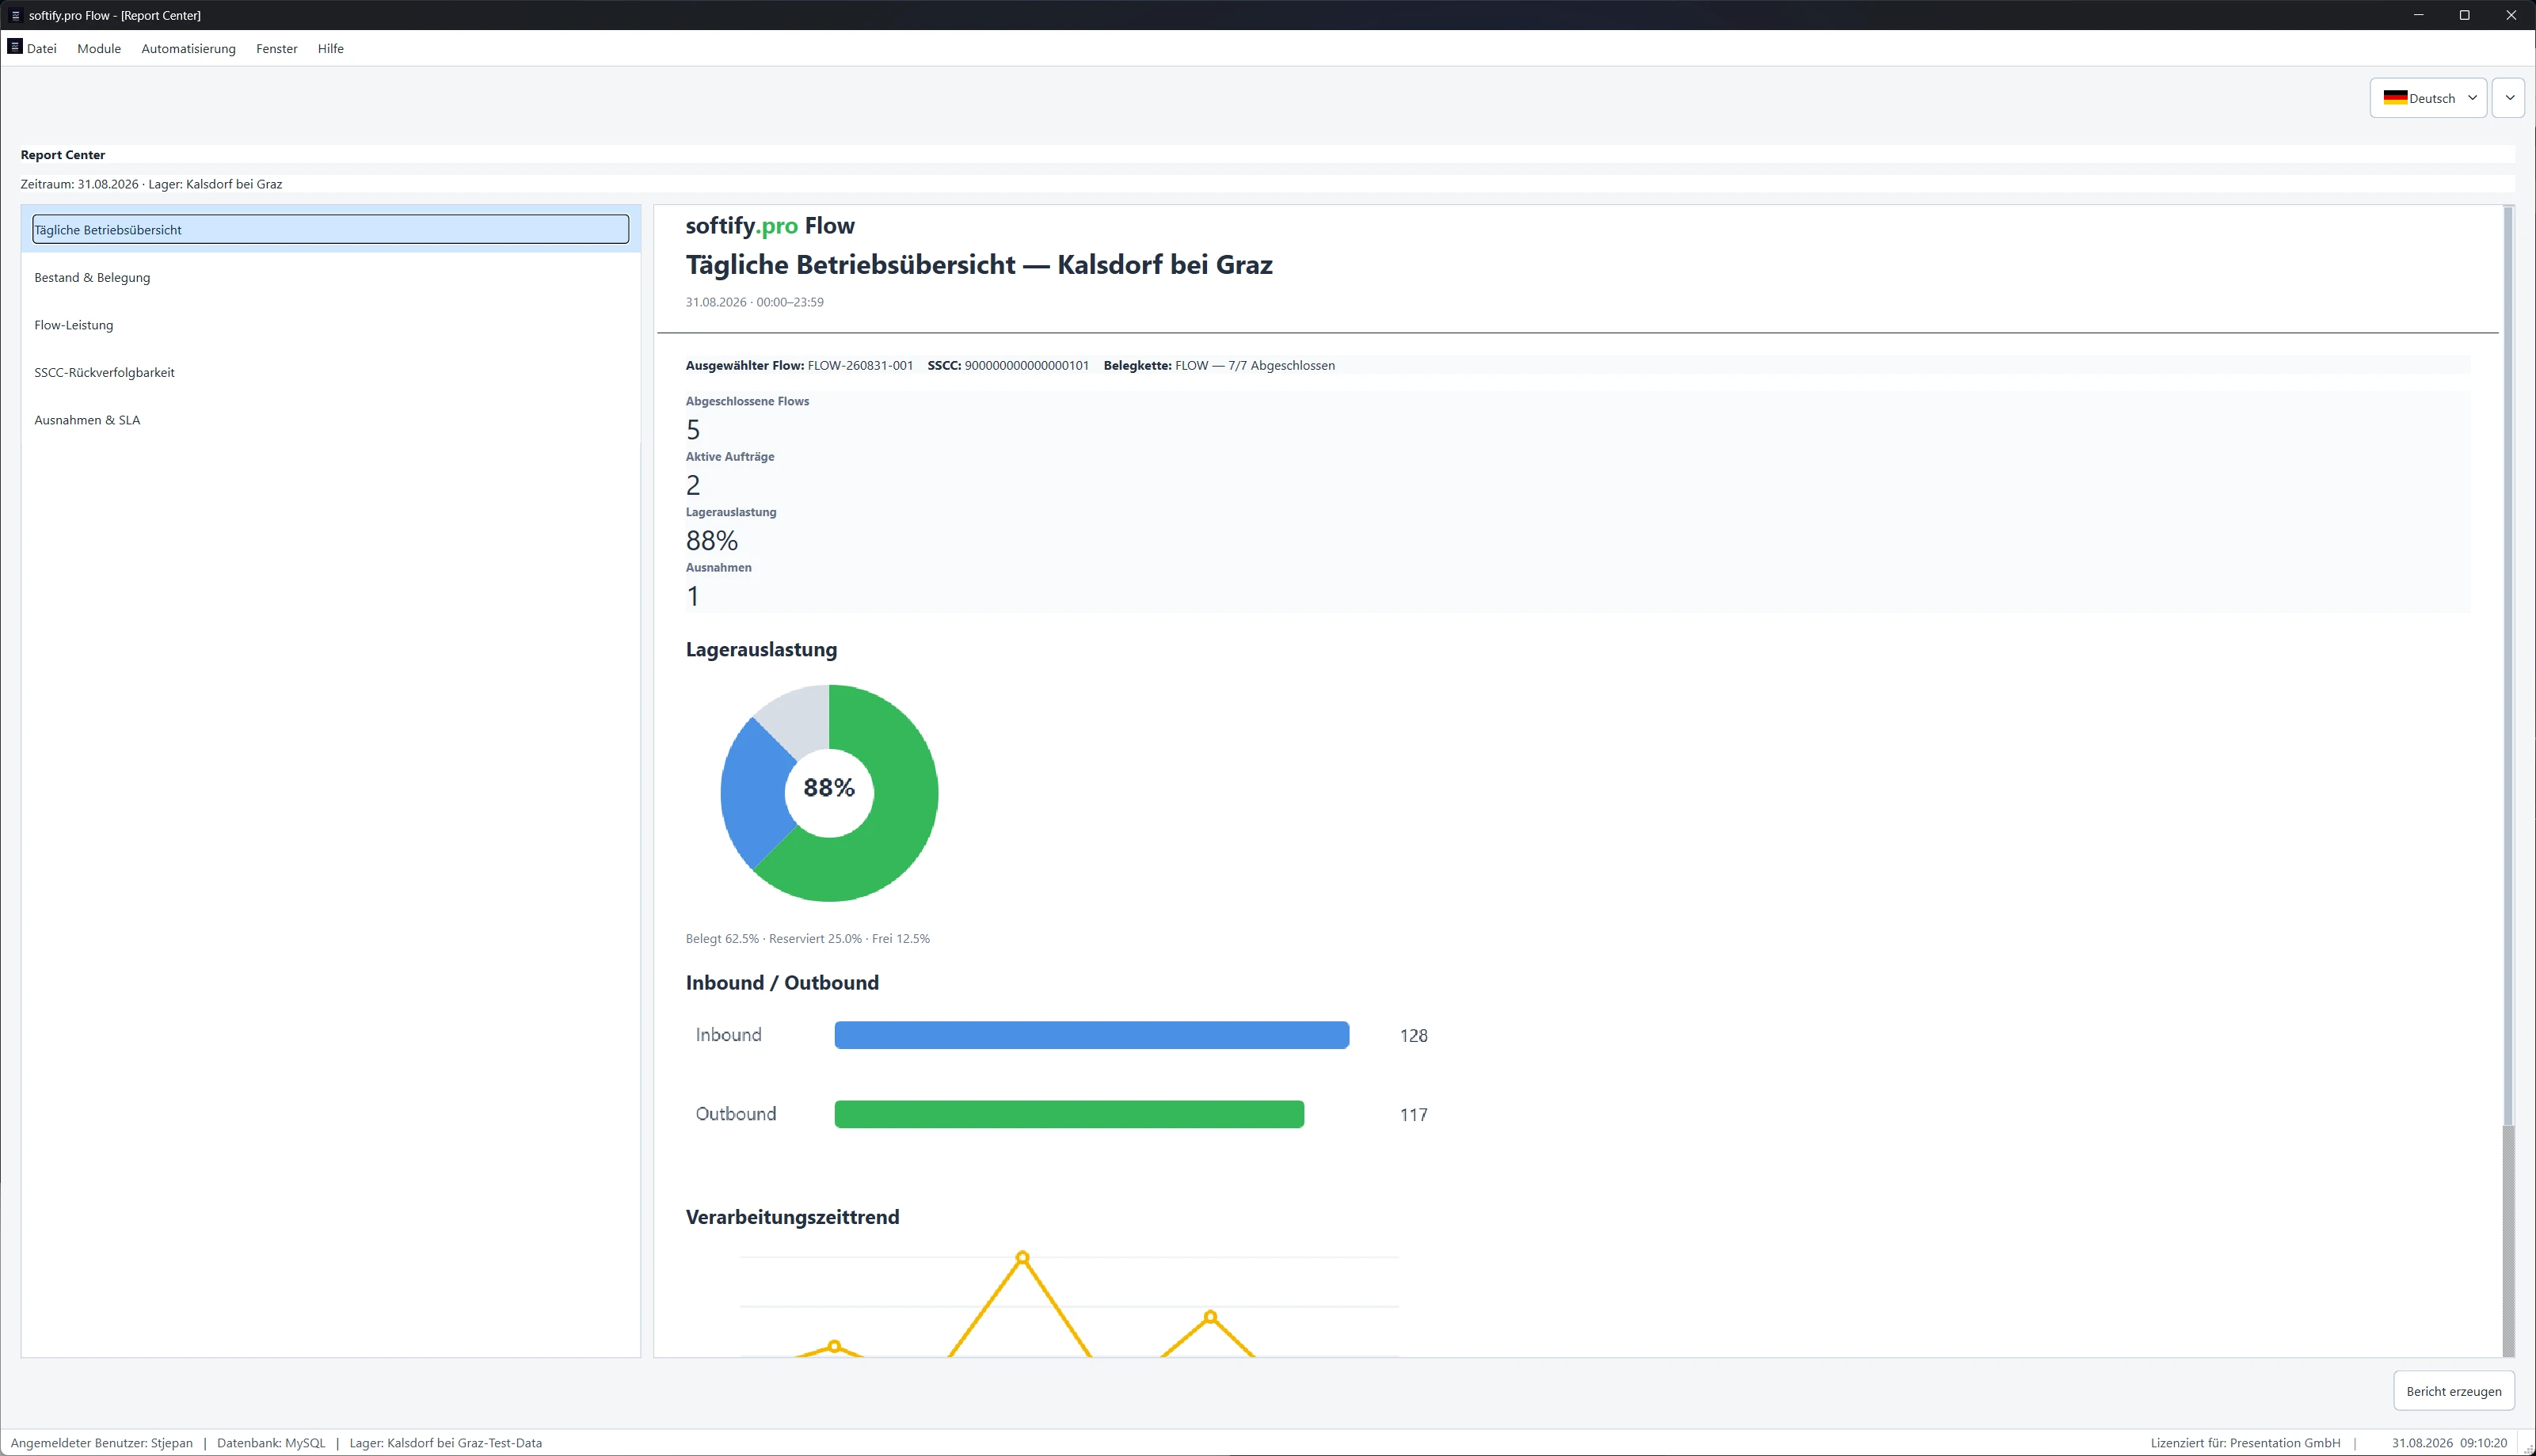
Dagelijks operationeel overzicht.
Voorraad en bezetting.
Flow-prestaties.
SSCC-traceerbaarheid.
Uitzonderingen en SLA.
Hetzelfde operationele verhaal verscheen opnieuw.
Voltooide Flows.
Actieve orders.
Magazijnbezetting.
Uitzonderingen.
Inbound.
Outbound.
Verwerkingstijd.
Maar deze keer was de vraag niet of het rapport er correct uitzag.
De vraag was:
Kan het zichzelf verdedigen?
Een goed rapport geeft je een getal.
Een beter systeem kan uitleggen waar dat getal vandaan komt.
Rapportage vanuit dezelfde operationele status — geen tweede versie van de werkelijkheid.
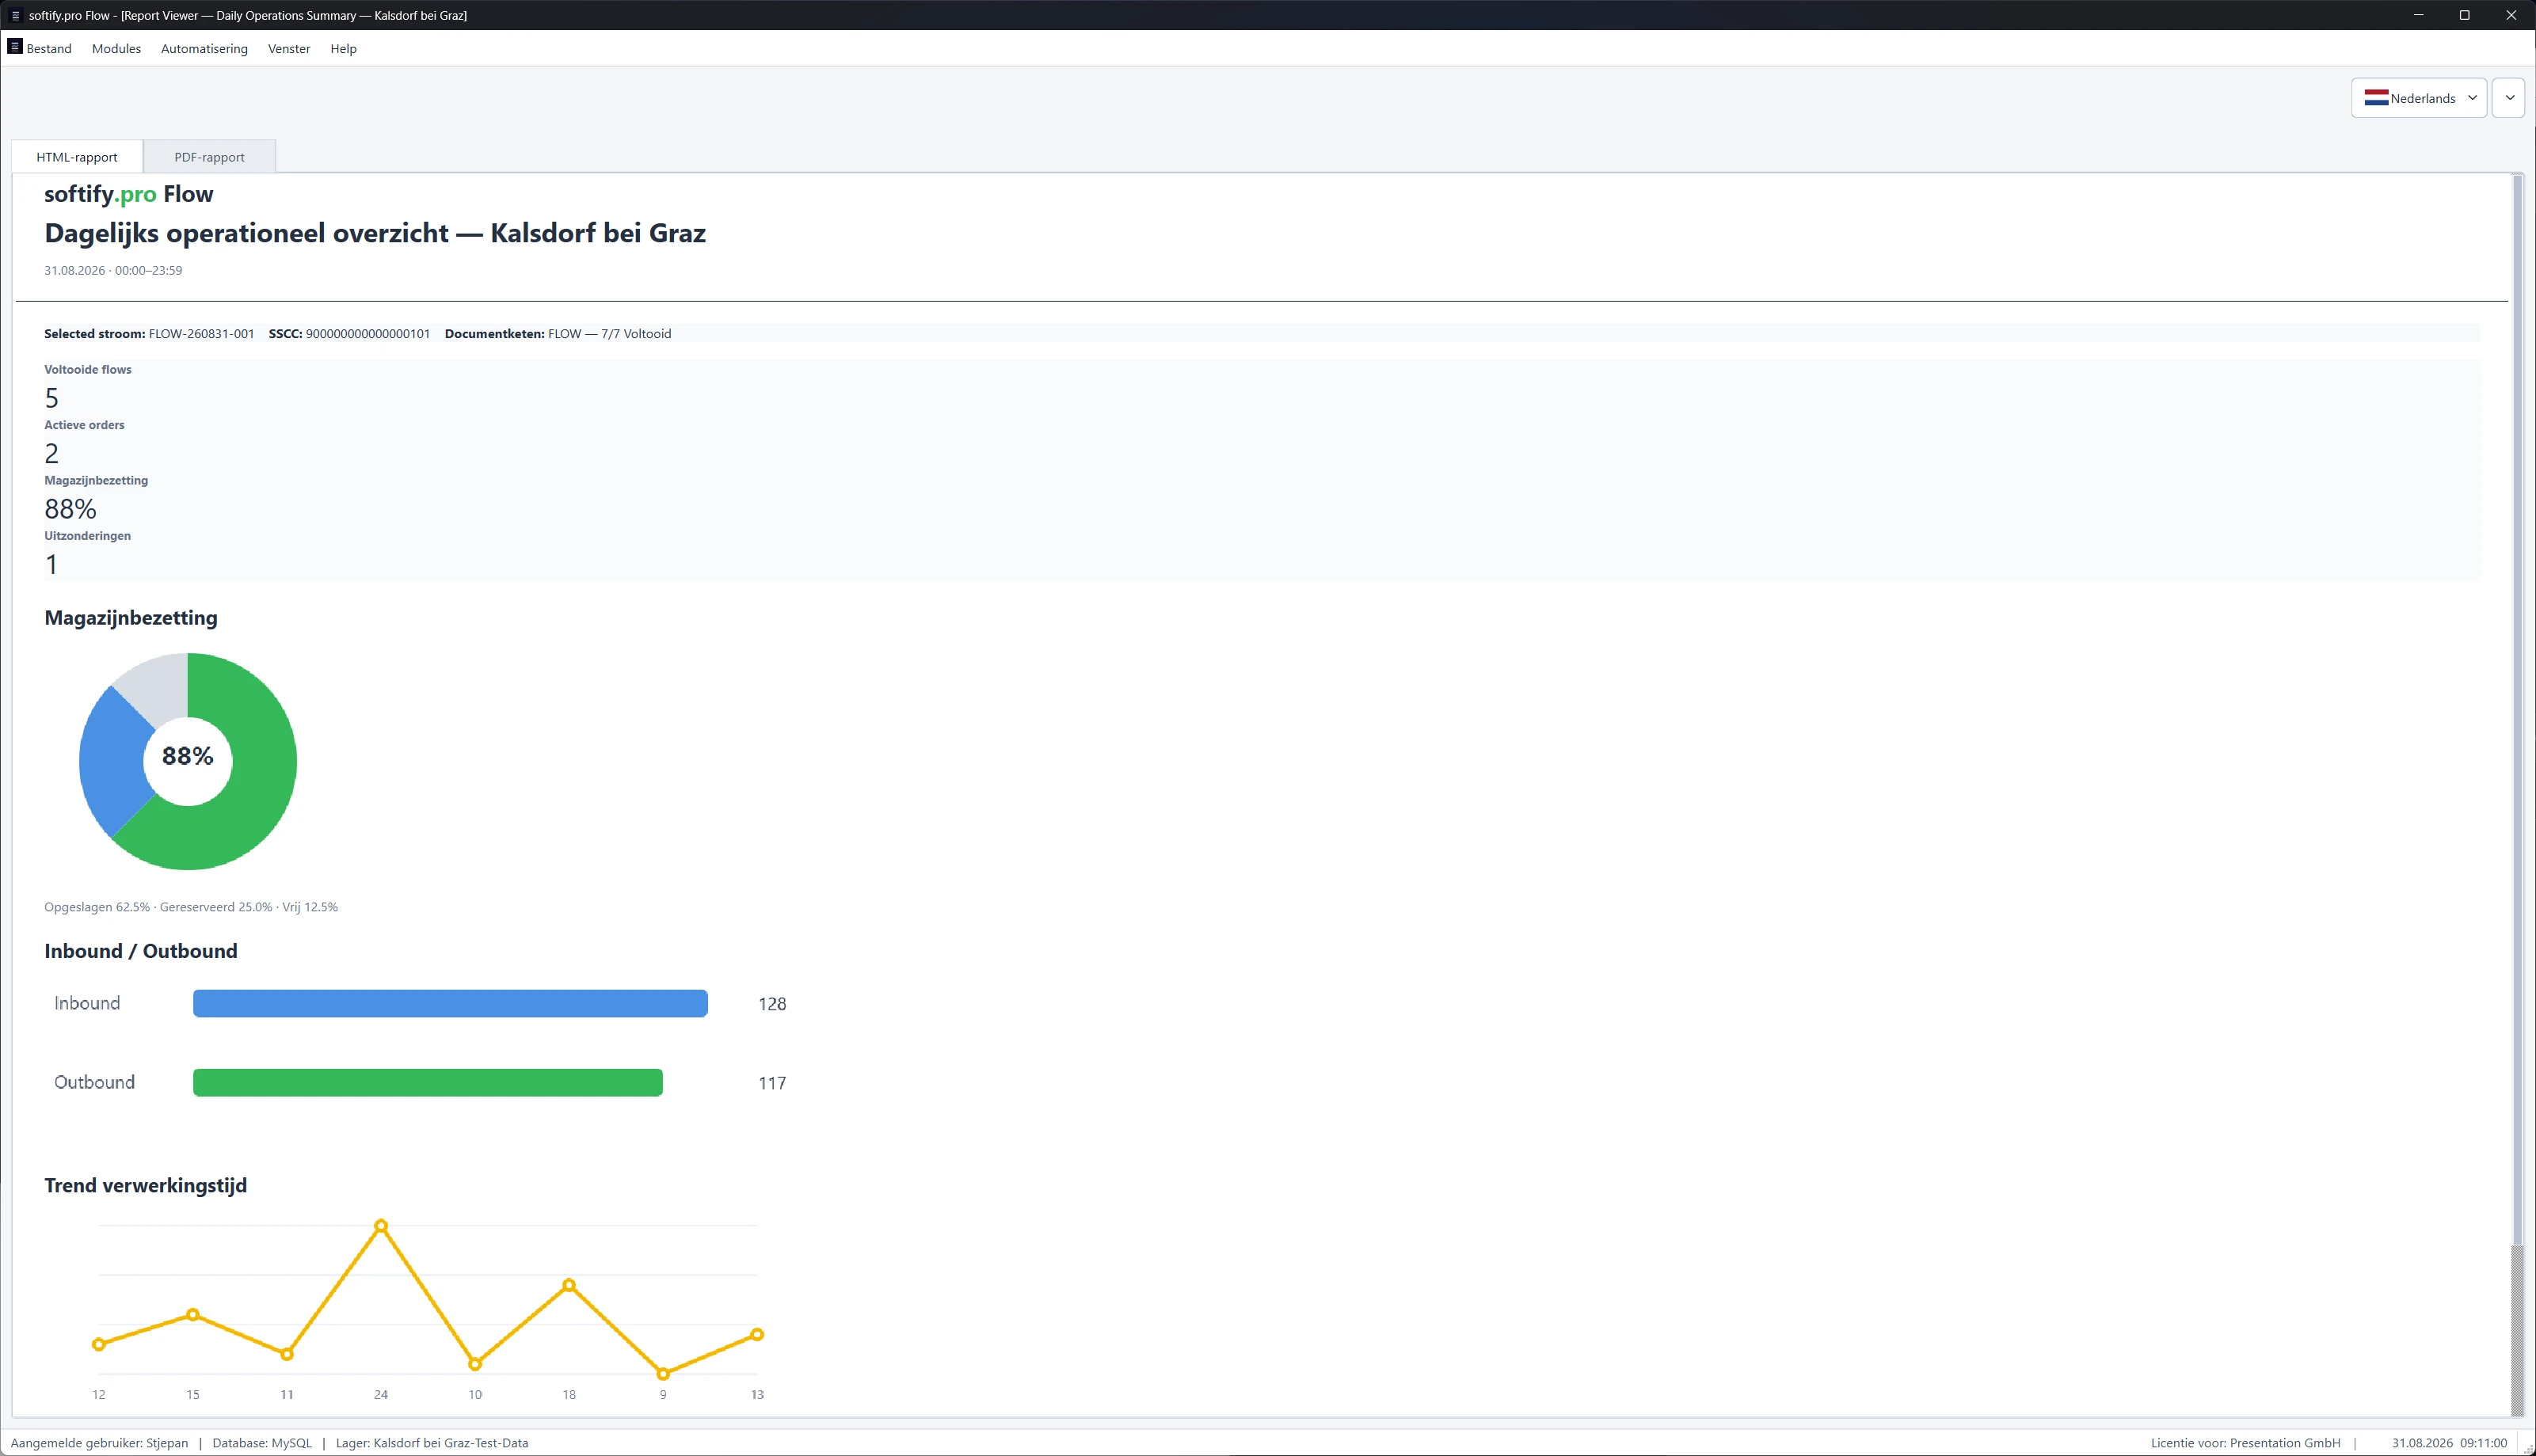
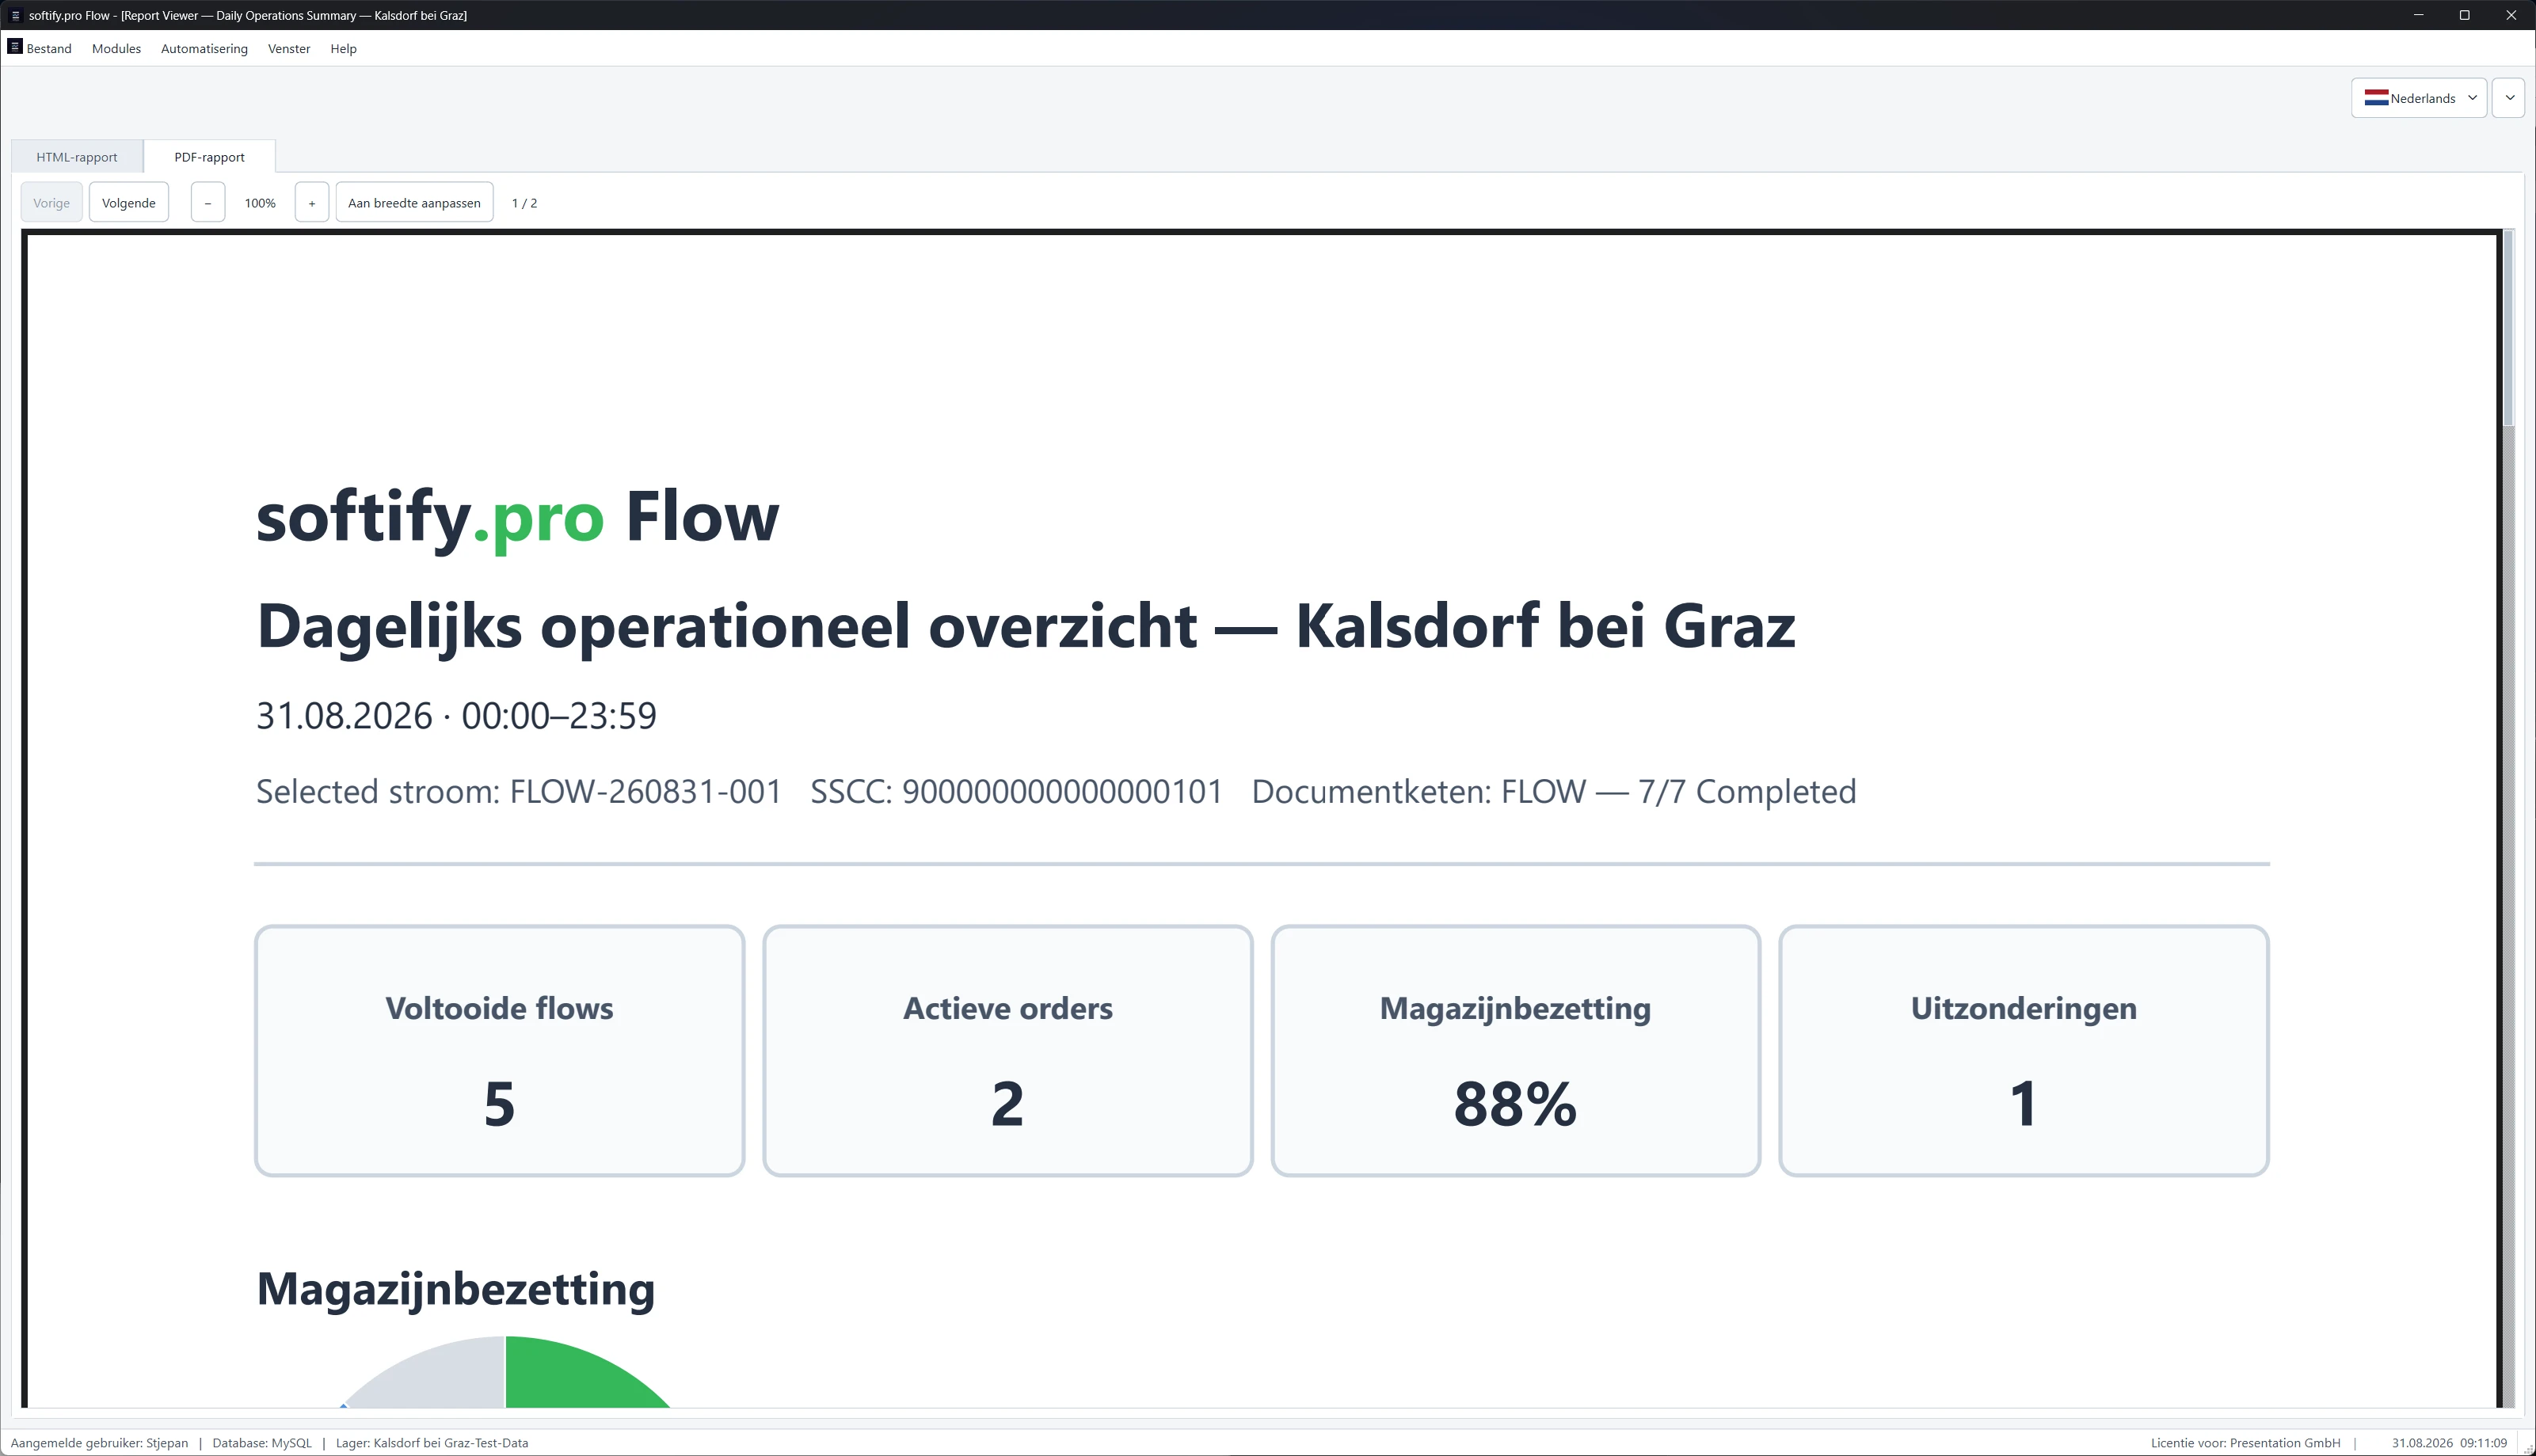
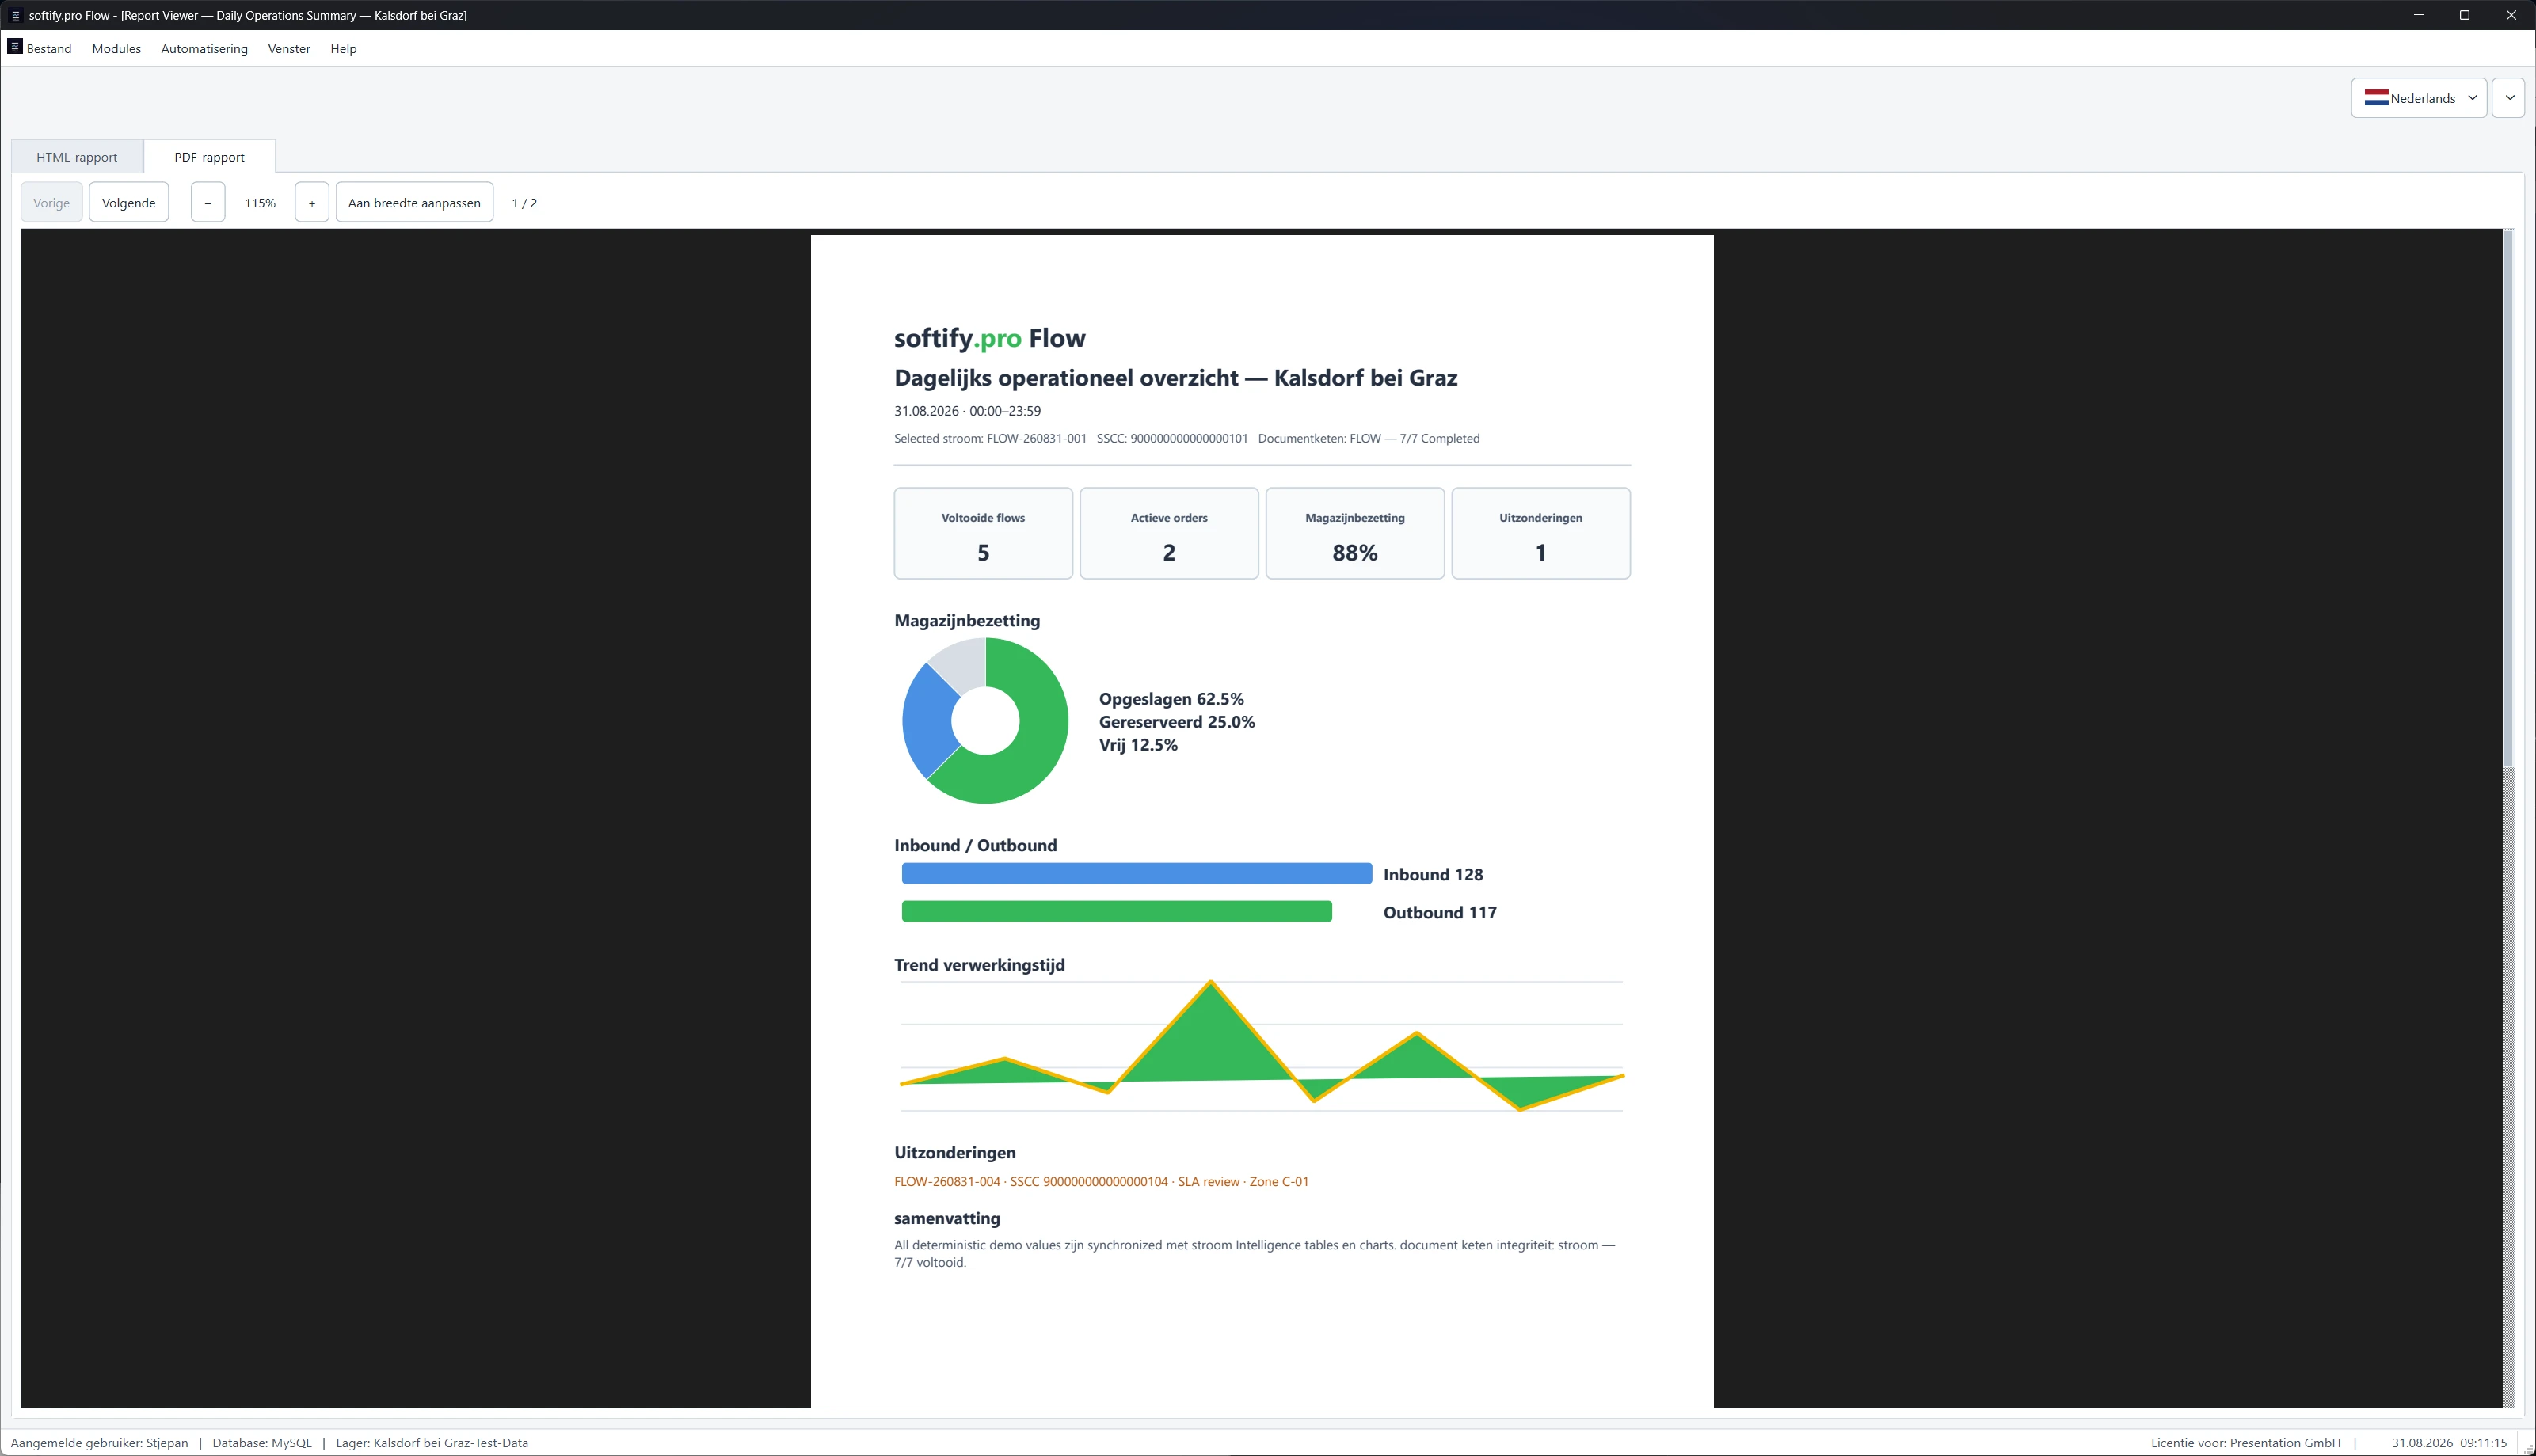
De uitzondering was er nog steeds.
Een van de stillere details bleek een van de belangrijkere te zijn.
De demogegevens bevatten een uitzondering.
Ze verschijnt in Analytics.
Ze verschijnt in Drill-down.
Ze verschijnt in de SSCC-traceerbaarheid.
Ze verschijnt in het Report Center.
En ze blijft zichtbaar in Exceptions & SLA.
Precies dat zou moeten gebeuren.
Operationeel herstellen van een uitzondering betekent niet dat de uitzondering uit de geschiedenis moet verdwijnen.
"Het proces ging door" en "er is niets gebeurd" zijn niet dezelfde bewering.
In de logistiek maakt dat verschil uit.
Op dit punt hadden we een testprobleem.
Geen softwareprobleem.
Een testprobleem.
We hadden nu hetzelfde magazijn weergegeven als:
- analytics,
- afzonderlijke Flows,
- SSCC-geschiedenissen,
- documentketens,
- rapporten,
- en uitzonderingsweergaven.
Elk kon onafhankelijk worden getest.
Openen.
Klikken.
Filteren.
Verifiëren.
Slagen.
Volgende.
Dat zou eenvoudig zijn.
Het zou ook het interessante deel missen.
Want zes groene vinkjes bewijzen niet dat zes weergaven met elkaar overeenkomen.
Daar komt COCO.
Opnieuw.
COCO had al eerder met Flow te maken gehad.
Authenticatie.
Gebruikers.
Rollen.
Database-omgevingen.
Talen.
Desktop-uitvoering.
Toen kwam de logistiek.
Magazijnen.
Voorraad.
Picken.
Bewegingen.
Uitzonderingen.
Documenten.
Ubuntu.
Red Hat Enterprise Linux.
Deze keer gaven we COCO iets net iets anders.
Geen scherm om te verifiëren.
Een verhaal om te volgen.
Neem dit magazijn.
Neem deze Flow.
Neem deze SSCC.
Open Analytics.
Open Drill-down.
Verander de taal.
Kijk opnieuw.
Open het rapport.
Vind dezelfde Flow.
Vind dezelfde SSCC.
Vind de uitzondering.
Vergelijk.
Vergelijk dan opnieuw.
COCO volgt dezelfde operationele context door softify.pro Flow heen — analytics, traceerbaarheid, taalwissels en rapportage.
Dat verandert de aard van de test.
De vraag is niet langer:
- Werkt elke module?
Ze wordt:
- Geloven alle modules dat hetzelfde is gebeurd?
Een veel betere vraag.
Veel minder comfortabel.
Een magazijnsysteem zou één geheugen moeten hebben.
Operators zien misschien posities.
Magazijnmanagers zien misschien KPI's.
Support gebruikt misschien drill-down.
Auditors gebruiken misschien rapporten.
COCO ziet ze misschien allemaal.
Maar onder die perspectieven zou er één geschiedenis moeten zijn.
Eén Flow zou niet meerdere biografieën moeten krijgen, afhankelijk van welke module open staat.
Eén SSCC zou niet meerdere verledens moeten hebben.
Eén uitzondering zou niet alleen moeten bestaan waar het uitkomt.
Eén magazijn zou niet een ander magazijn moeten worden omdat de interfacetaal veranderde.
Daar gaat het huidige Flow-experiment in feite over.
Niet over dashboards.
Niet over rapporten.
Zelfs niet over afzonderlijke schermen.
Eén operationele waarheid, op verschillende manieren uitgedrukt.
Controle.
Het magazijn kennen.
De status kennen.
Weten wat er beweegt.
Weten welk proces het bezit.
Duidelijkheid.
KPI's terug omzetten in records.
Records omzetten in geschiedenis.
Uitzonderingen omzetten in bewijs.
Een SSCC omzetten in iets traceerbaars.
Flow.
Een magazijn wordt geselecteerd.
Analytics begint het te beschrijven.
Een Flow gaat vooruit.
De SSCC blijft eraan gekoppeld.
Een documentketen groeit.
Een uitzondering verschijnt.
Het proces gaat door.
Het rapport onthoudt het.
Dan verandert de taal.
Het magazijn is nog steeds hetzelfde.
De Flow is nog steeds dezelfde.
De geschiedenis is nog steeds dezelfde.
Dat was het verwachte deel.
Wat daarna gebeurde was interessanter.
COCO stopte met het onafhankelijk testen van de weergaven.
Het begon ze te vergelijken.
Een tijdlang gebeurde er niets bijzonders.
Zelfde magazijn.
Zelfde Flow.
Zelfde SSCC.
Zelfde verhaal.
Opnieuw.
Opnieuw.
Opnieuw.
En toen stopte COCO.
Niet omdat de applicatie was vastgelopen.
Dat was niet zo.
Niet omdat een test in de gebruikelijke zin was mislukt.
Dat was niet zo.
Het stopte omdat twee volkomen redelijke antwoorden een derde vraag opleverden.
Wij weten wat de vraag is.
Flow weet waarom het bestaat.
COCO weet waar het vervolgens moet kijken.
De rest kan wachten.
Control. Clarity. Flow.