
Un magazzino. Una verità.
C'è un modo semplice per far sembrare convincente un software di magazzino.
Aprire una dashboard.
Mostrare qualche numero verde.
Aggiungere un grafico.
Mettere delle scorte su una mappa del magazzino.
Concludere con un report.
Tutto sembra a posto.
E tutto può comunque essere sbagliato.
Perché a un magazzino non interessa quanto sia bella la dashboard.
Gli interessa se ogni parte del sistema concorda su ciò che è realmente accaduto.
Questa è diventata la parte interessante dell'ultimo esperimento softify.pro Flow.
Non un'altra schermata.
Non un altro KPI.
Non un altro report.
Qualcosa di molto meno visibile.
Coerenza.
È iniziato con un magazzino.
L'attuale demo di softify.pro Flow lavora con diversi ambienti di magazzino sintetici.
ID di magazzino diversi.
Capacità diverse.
Strutture di zona diverse.
Nessun inventario di produzione.
Nessun dato cliente.
Nessuna informazione operativa reale.
Ma la logica di processo si comporta come se tutto ciò contasse.
Perché nella logistica reale, conta.
Una volta selezionato un magazzino, quel contesto diventa parte di tutto ciò che segue.
Flow.
SSCC.
Movimentazioni.
Operatori.
Analytics.
Report.
Sembra ovvio.
Diventa notevolmente meno ovvio quando lo stesso processo inizia a comparire in diverse parti dell'applicazione.
Poi abbiamo aperto un'altra vista.
Operational Analytics.
Improvvisamente il magazzino sembrava completamente diverso.
Nessuna posizione di stoccaggio.
Nessuna freccia di movimento.
Invece:
- Flow completati,
- ordini attivi,
- utilizzo del magazzino,
- eccezioni,
- ricevimento merci,
- spedizioni,
- tempo di elaborazione.
La rappresentazione visiva era cambiata.
Il magazzino no.
Quella distinzione è diventata importante.
Perché sotto i KPI c'erano ancora record individuali.
ID Flow.
SSCC.
Zone.
Stati.
Operatori.
Tempi di elaborazione.
Vista diversa.
Stessa realtà operativa.
Fin qui tutto bene.
Operational Analytics — stato aggregato del magazzino, con i record Flow sottostanti ancora visibili.
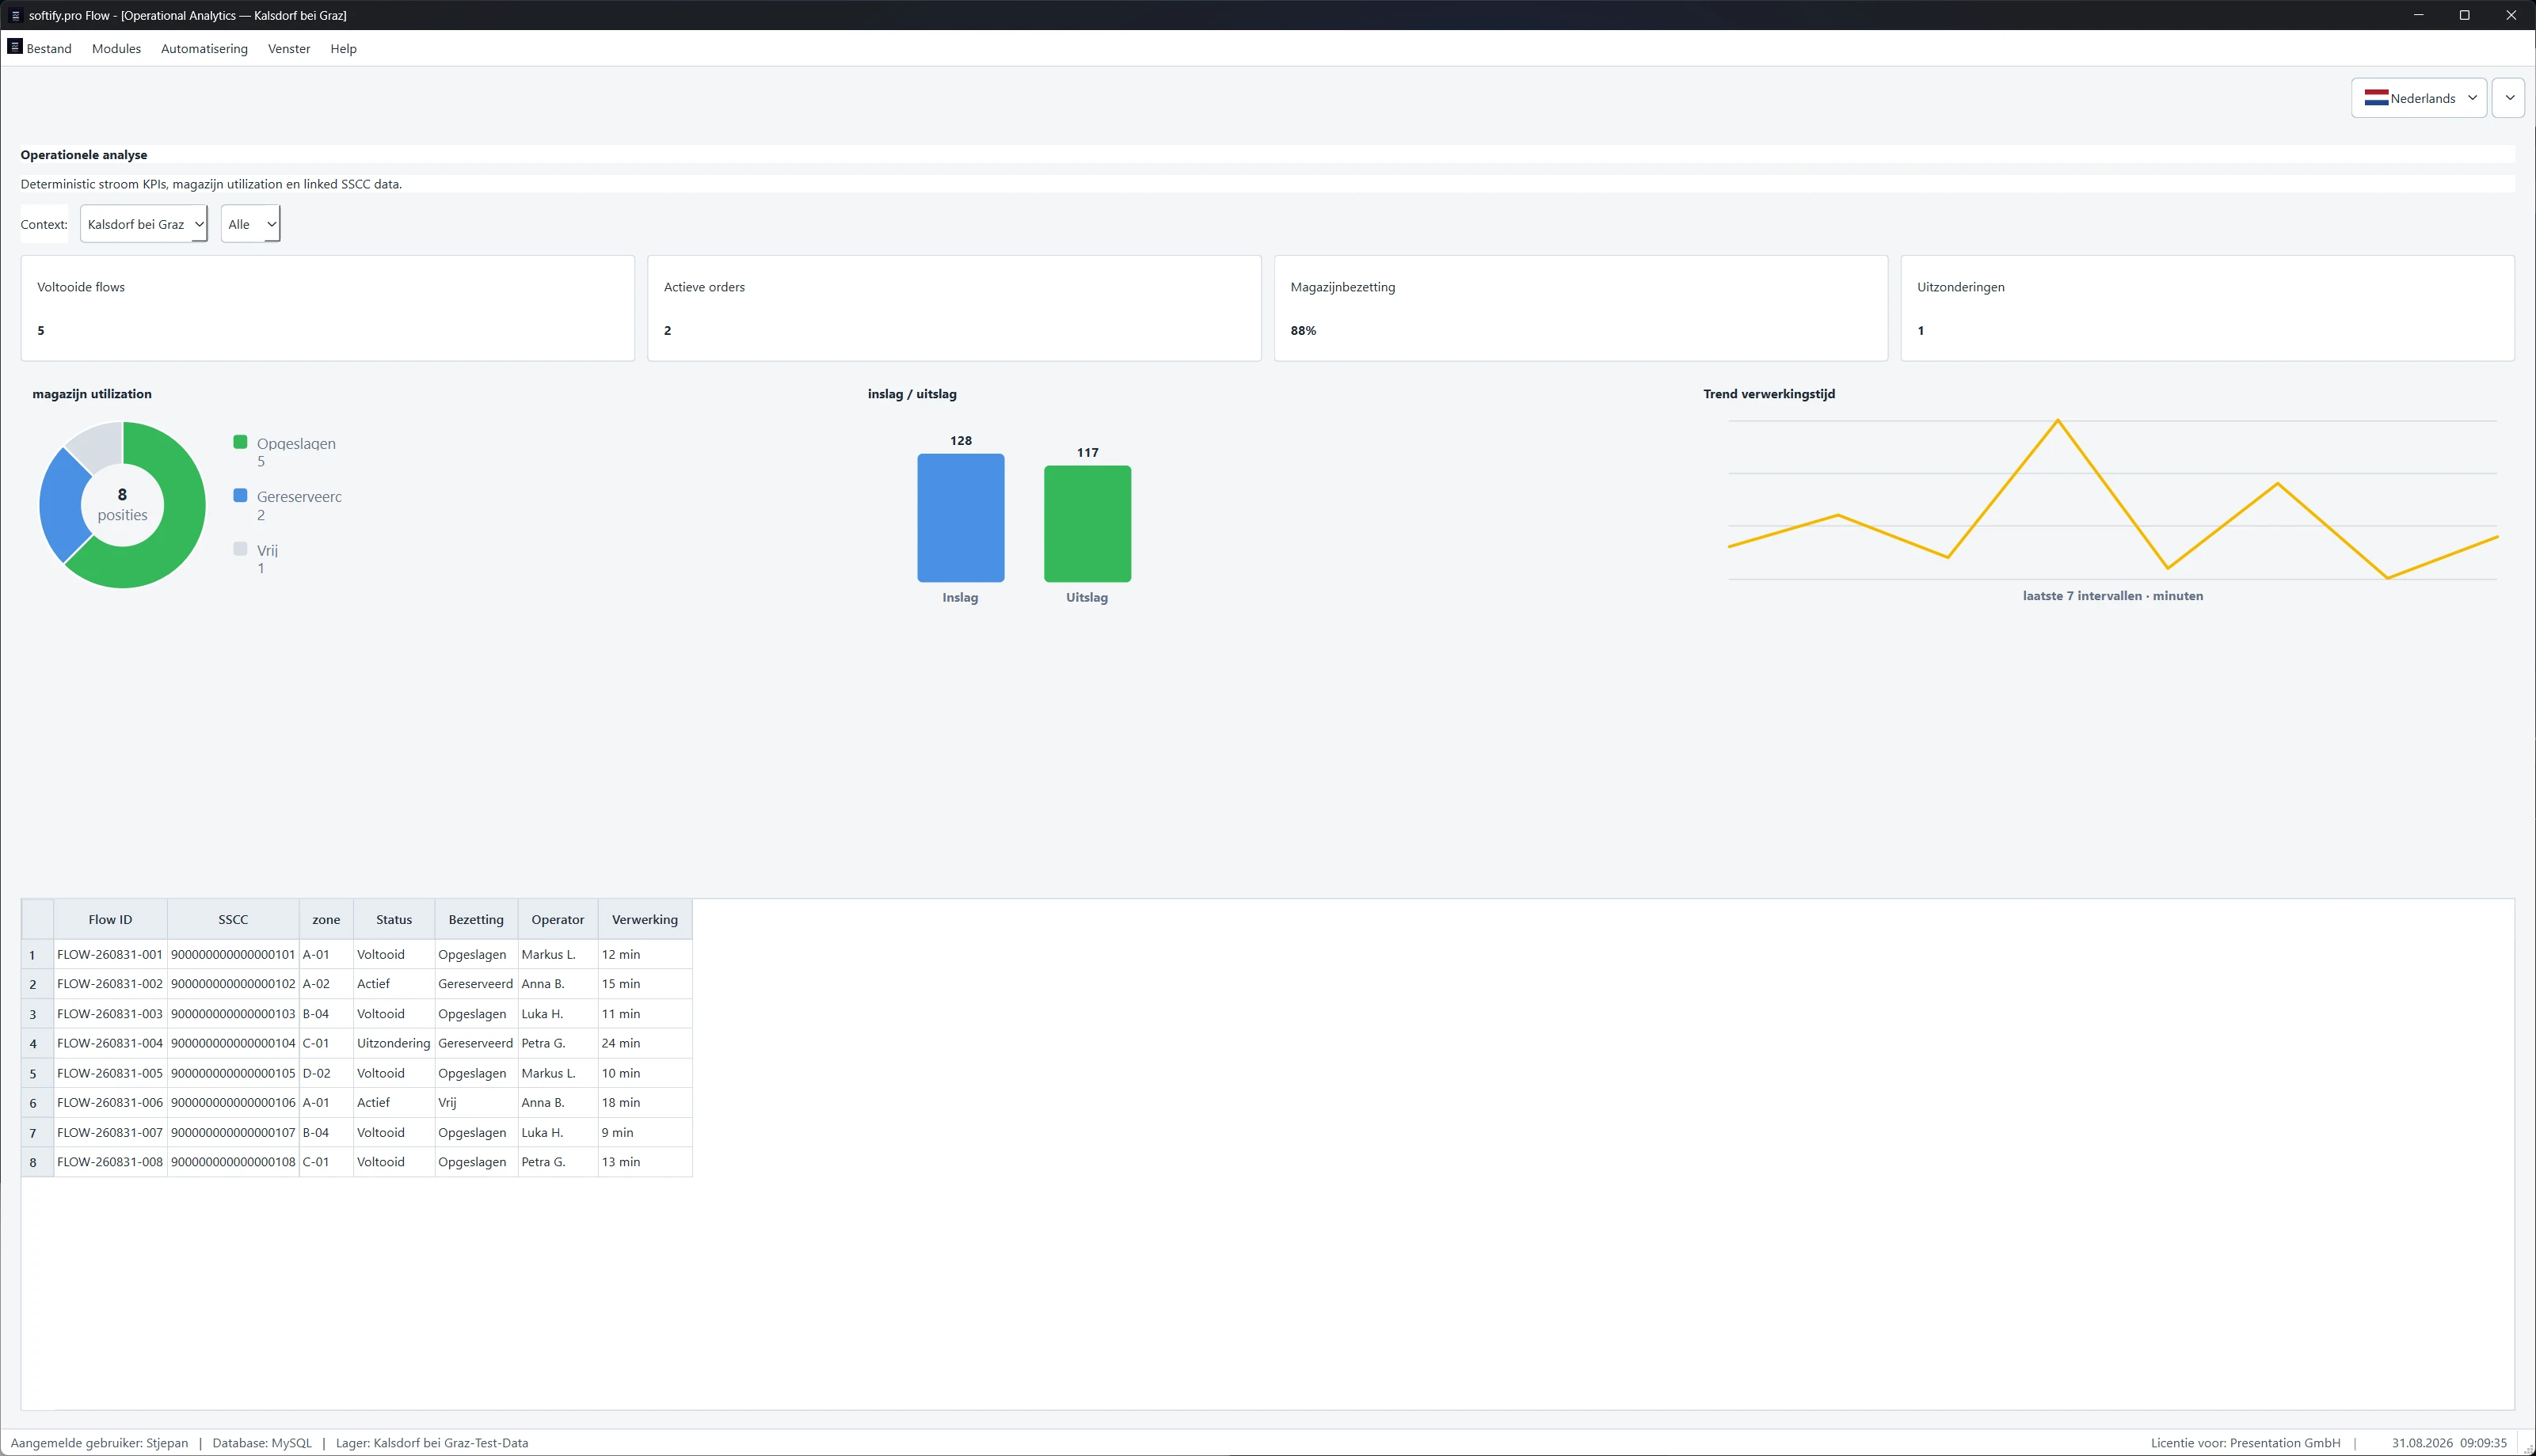
L'88% è utile solo se il sistema riesce a spiegarlo.
Supponiamo che la dashboard dica:
Utilizzo del magazzino: 88%.
Utile.
Ma incompleto.
Alcune posizioni sono occupate.
Alcune sono riservate.
Alcune rimangono libere.
Questi stati non sono intercambiabili.
Il numero diventa affidabile solo se il sistema riesce ancora a spiegare da dove viene.
Cinque Flow completati?
Mostrali.
Due ordini attivi?
Mostrali.
Un'eccezione?
Quale?
88% di utilizzo?
Cosa è occupato?
Cosa è riservato?
Cosa rimane libero?
Una dashboard dovrebbe riassumere la realtà.
Non dovrebbe sostituirla.
Poi abbiamo cambiato la lingua.
Olandese.
Il magazzino è rimasto lo stesso.
Gli ID Flow sono rimasti gli stessi.
Gli SSCC sono rimasti gli stessi.
Gli operatori sono rimasti collegati ai loro record.
È cambiata solo la lingua.
In seguito lo stesso stato operativo è apparso in croato.
Poi in francese.
È qui che il software multilingue diventa molto più interessante dei pulsanti tradotti.
Una cattiva traduzione si nota facilmente.
Un cambio di stato causato dal cambio di lingua è molto più pericoloso.
Immaginate di passare dal tedesco al francese e perdere silenziosamente il Flow selezionato.
O di ricostruire un filtro sul magazzino sbagliato.
O di mostrare l'SSCC corretto nel contesto di processo sbagliato.
L'interfaccia potrebbe comunque sembrare perfetta.
Il sistema non lo sarebbe.
Flow segue quindi una regola semplice:
La lingua può cambiare le parole. Non può cambiare la verità.
Poi il Flow ha acquisito una storia.
Browse & Drill-down non si sforza particolarmente di sembrare impressionante.
Forse è proprio per questo che è utile.
Seleziona un Flow.
Compare il suo contesto.
Magazzino.
Zona.
Stato.
Operatore.
SSCC.
E poi la catena documentale.
ASN.
Ricevimento merci.
Movimentazione di magazzino.
Ordine di prelievo.
Prelievo.
Spedizione.
FLOW.
Sette passaggi.
Il processo non è più solo uno stato attuale.
Ha un passato.
E questo cambia la domanda.
Invece di:
Cosa sta succedendo?
possiamo chiedere:
Come siamo arrivati qui?
È una domanda molto migliore quando qualcosa alla fine va storto.
Un Flow, un SSCC, una catena documentale — dall'ASN al completamento.
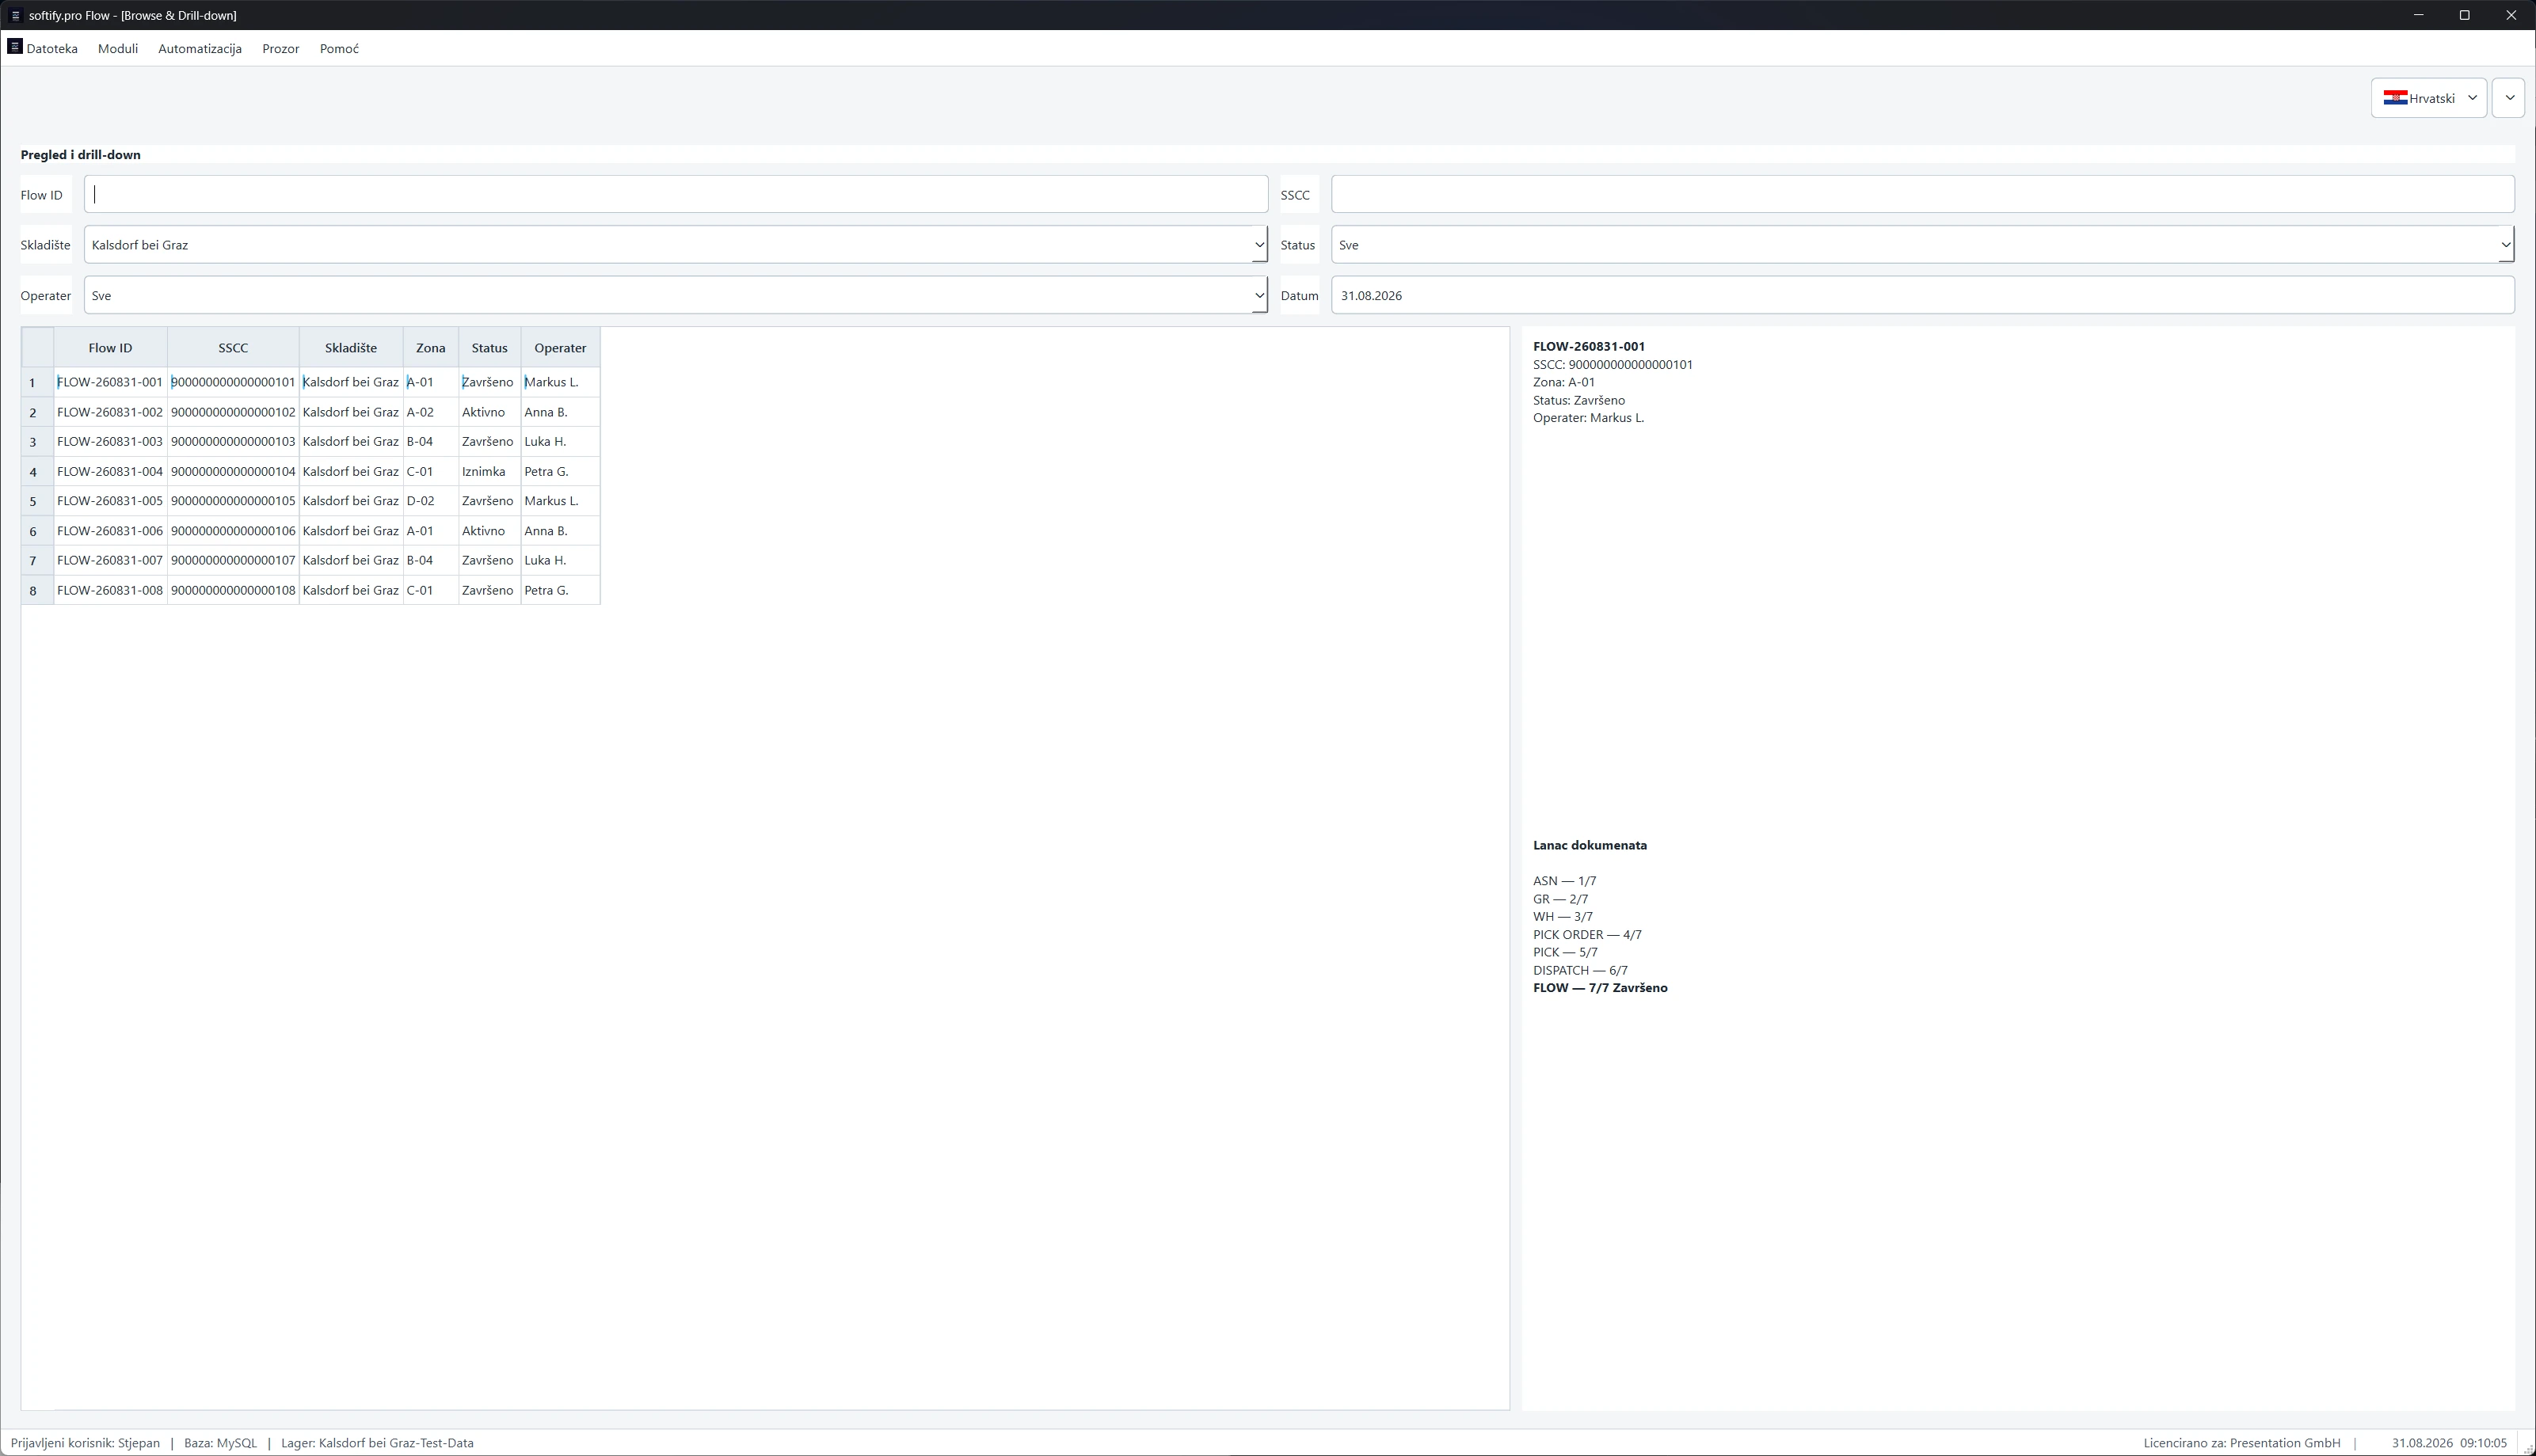
L'SSCC diventa il filo conduttore.
Inizialmente, un SSCC sembra quello che è.
Un identificativo.
Un numero lungo in una tabella.
Ma attraverso Flow diventa qualcosa di più utile.
Un filo conduttore attraverso il processo.
Seguendolo, altre cose iniziano a collegarsi.
Un magazzino.
Un Flow.
Una zona.
Uno stato.
Un operatore.
Una catena documentale.
Infine un report.
Lo stesso oggetto logistico fisico è ora visibile da diverse parti dell'applicazione.
Utile.
Anche pericoloso.
Perché ogni vista aggiuntiva crea un'altra opportunità per il sistema di raccontare una storia diversa.
Ed è qui che le cose diventano interessanti.
Supponiamo che Analytics dica che il Flow è attivo.
Il Drill-down dice che l'SSCC appartiene a quel Flow.
La catena documentale dice che l'operazione è progredita ulteriormente.
Il report dice qualcos'altro.
Quale è corretto?
Non è un problema specifico di Flow.
È uno dei problemi più antichi del software aziendale.
Parti diverse dello stesso sistema sviluppano gradualmente la propria versione della realtà.
Una schermata legge lo stato transazionale.
Un'altra legge un aggregato.
Un'altra si affida a dati in cache.
Un report calcola qualcosa in modo leggermente diverso.
Un'eccezione viene risolta operativamente ma scompare dal reporting.
Ogni componente funziona.
L'intero sistema mente.
Di solito educatamente.
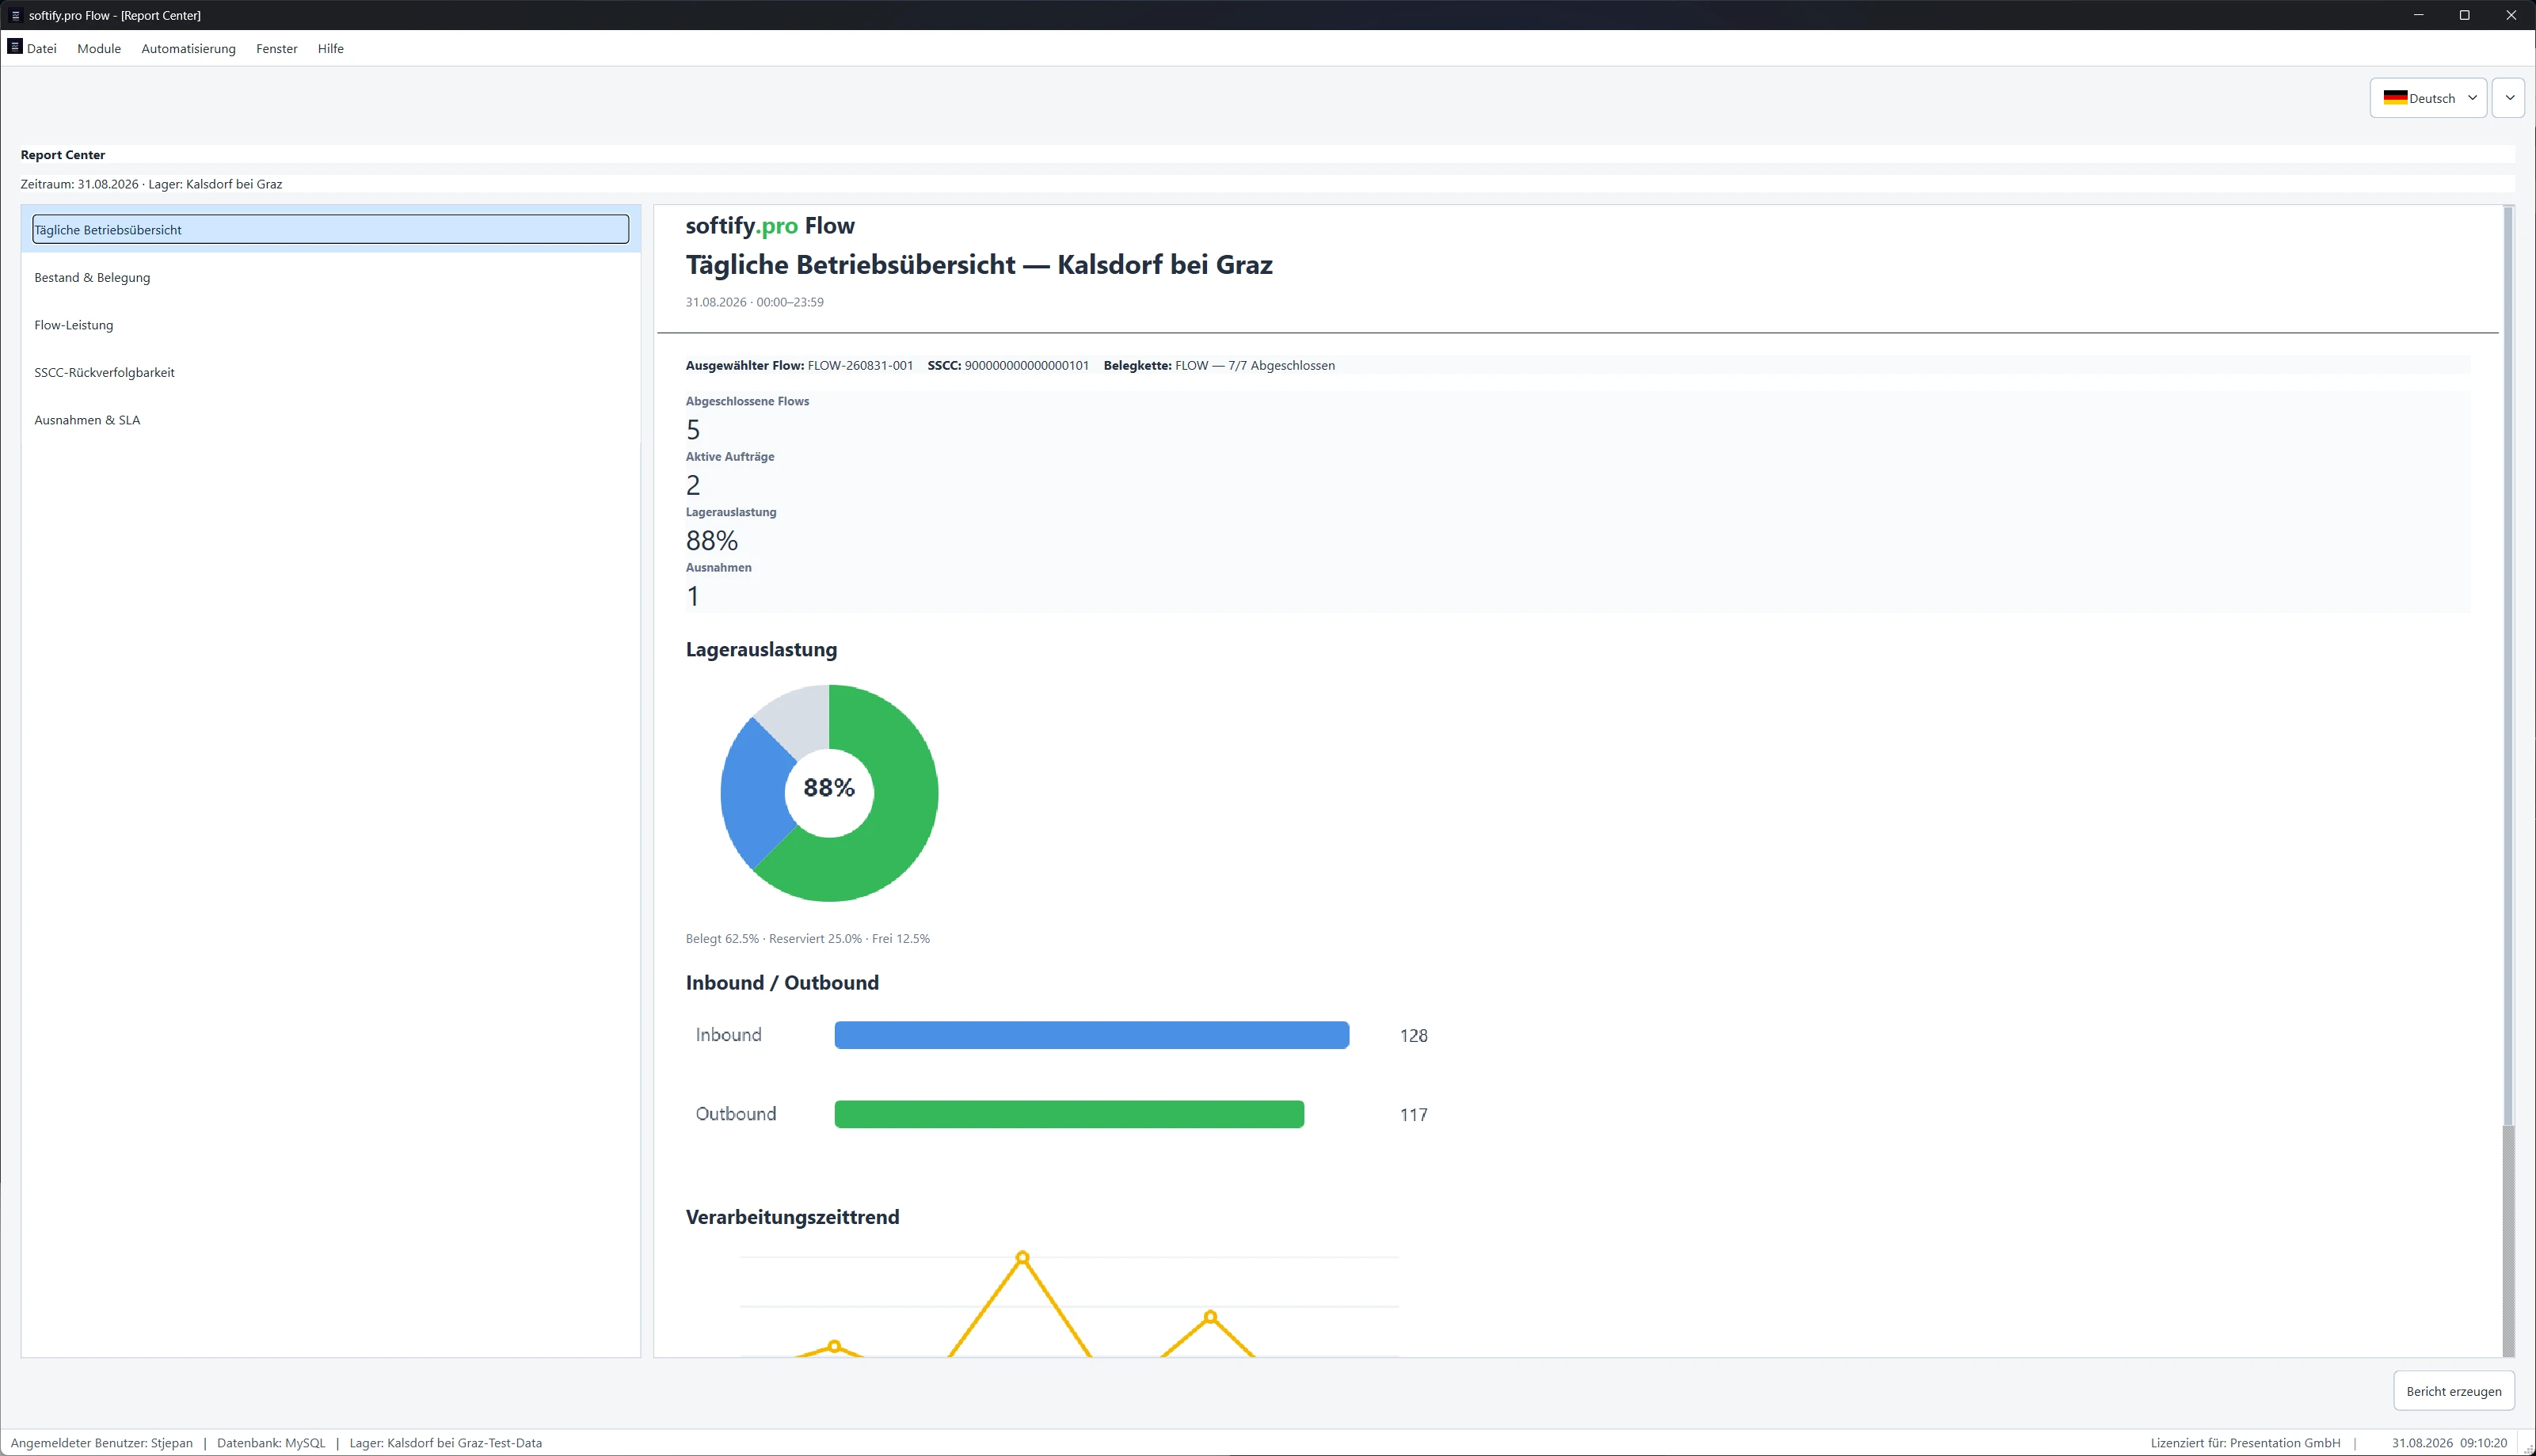
Così abbiamo aperto il Report Center.
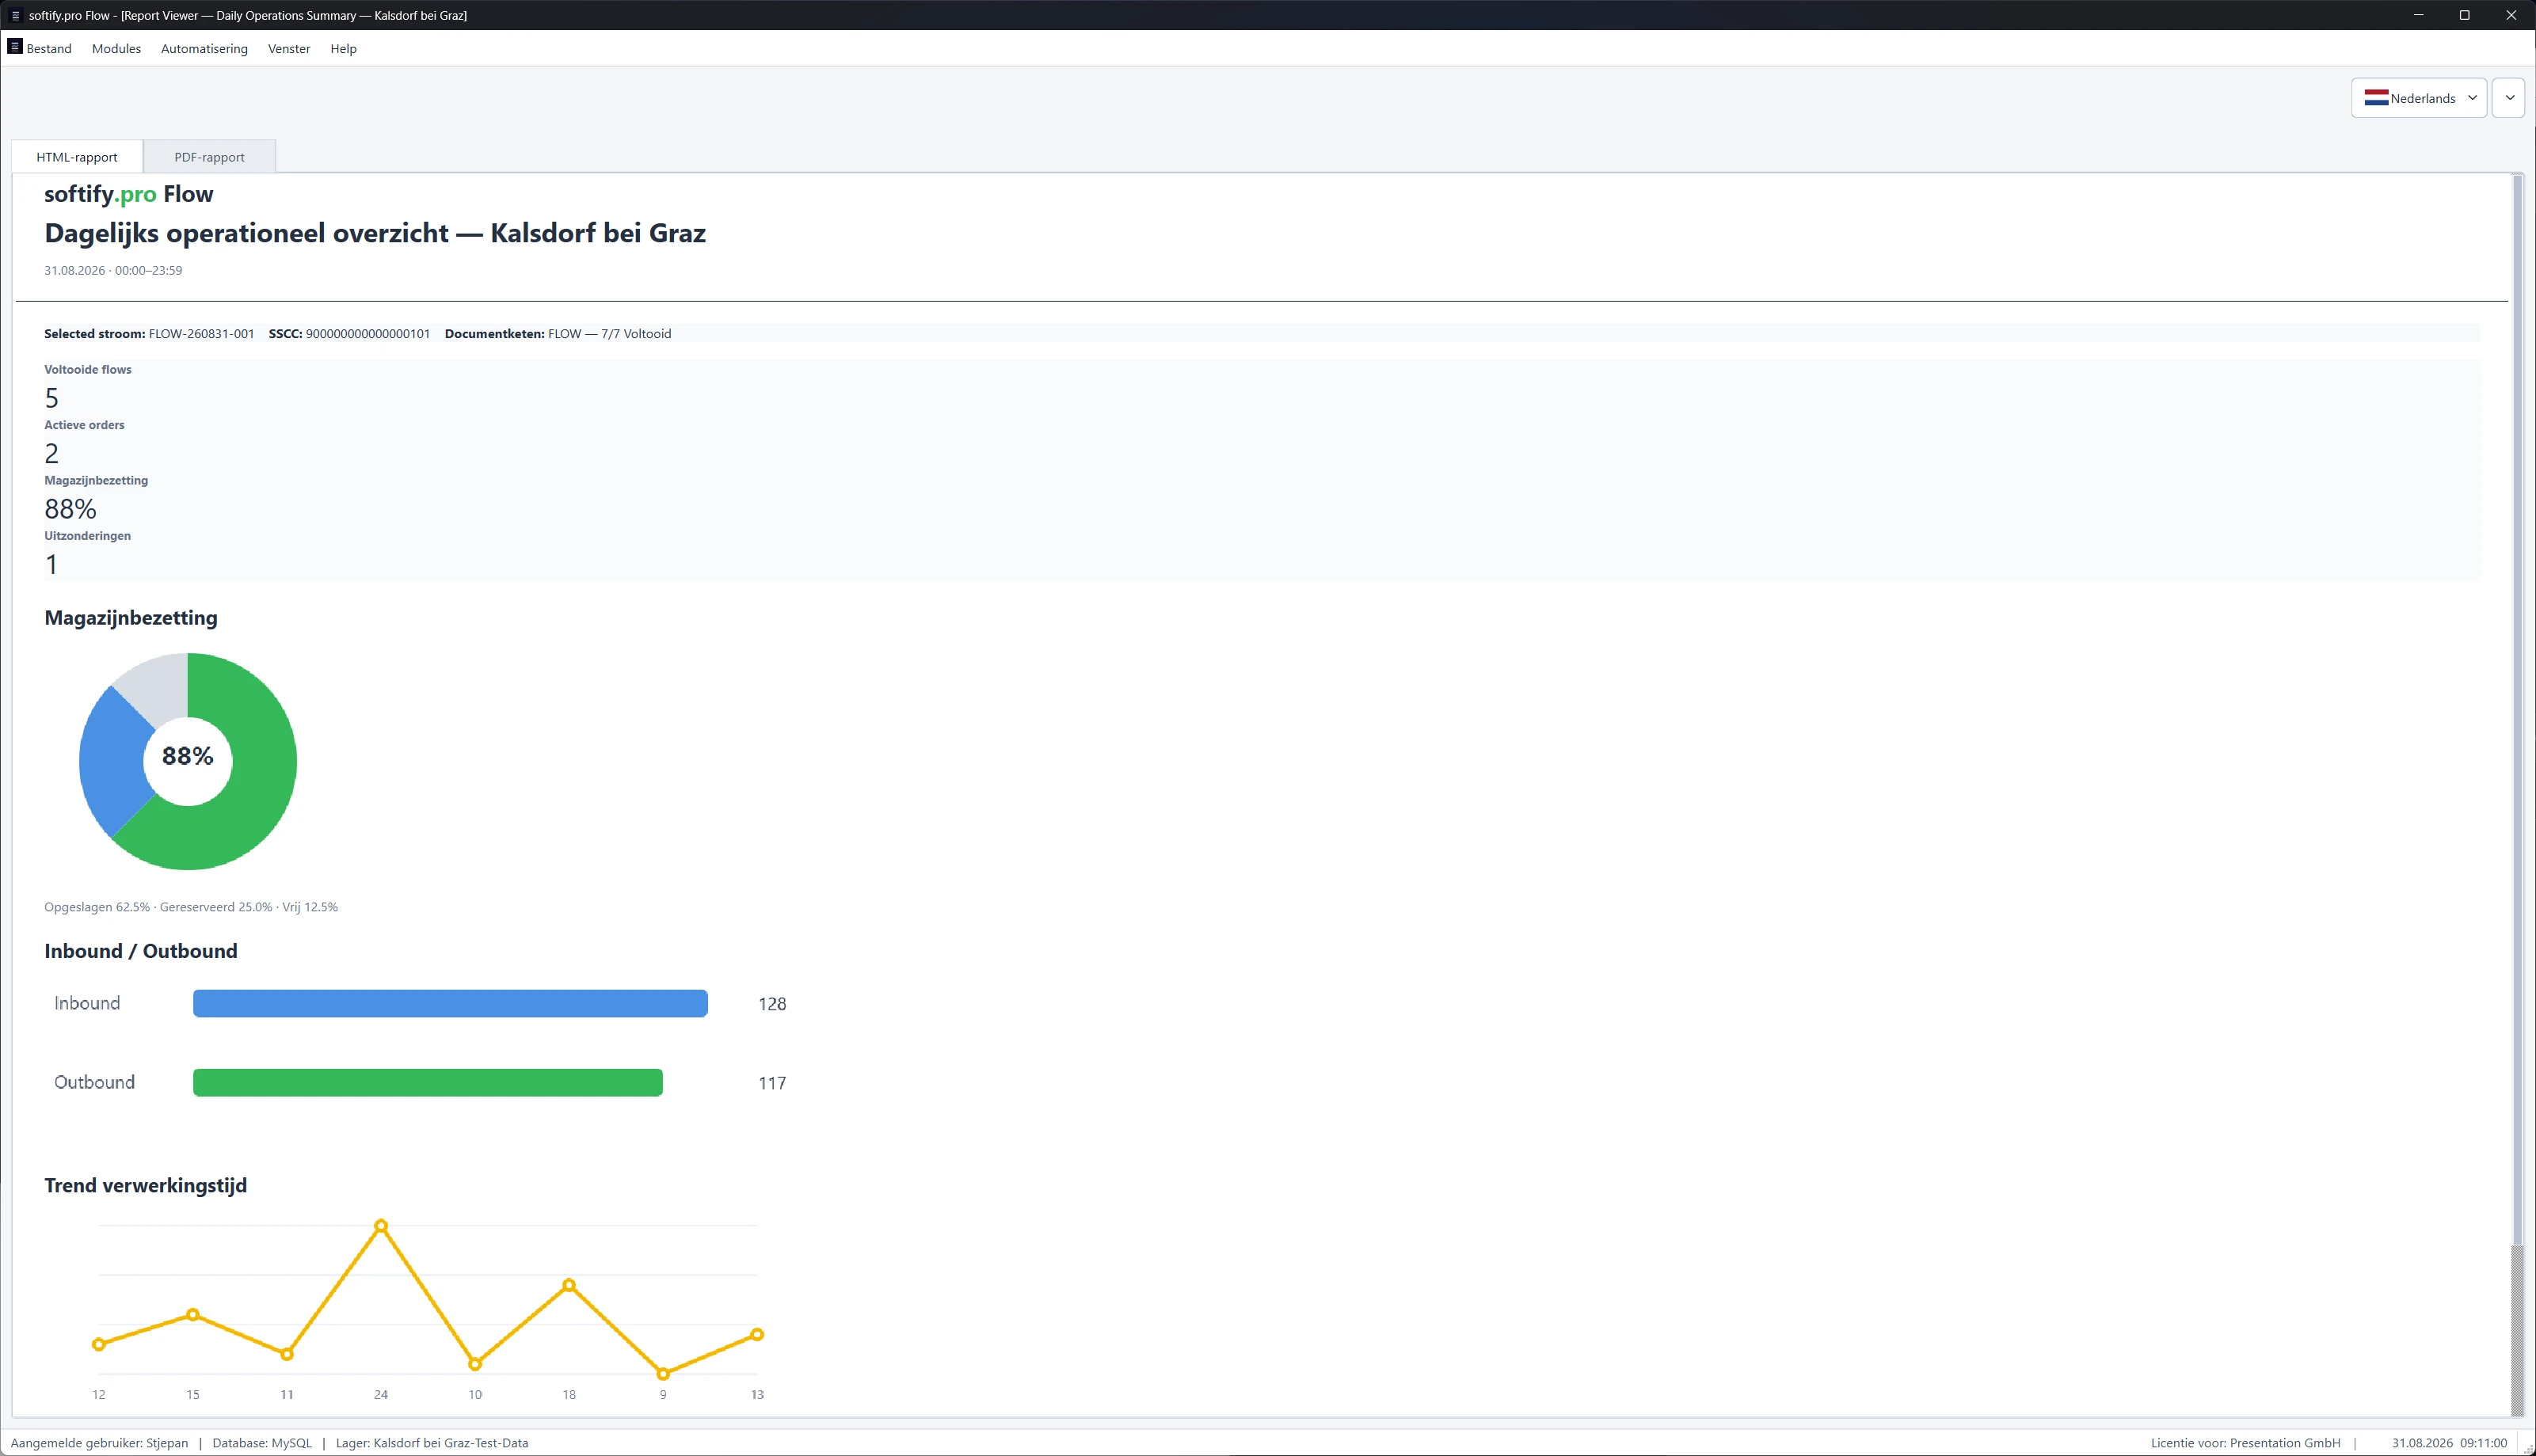
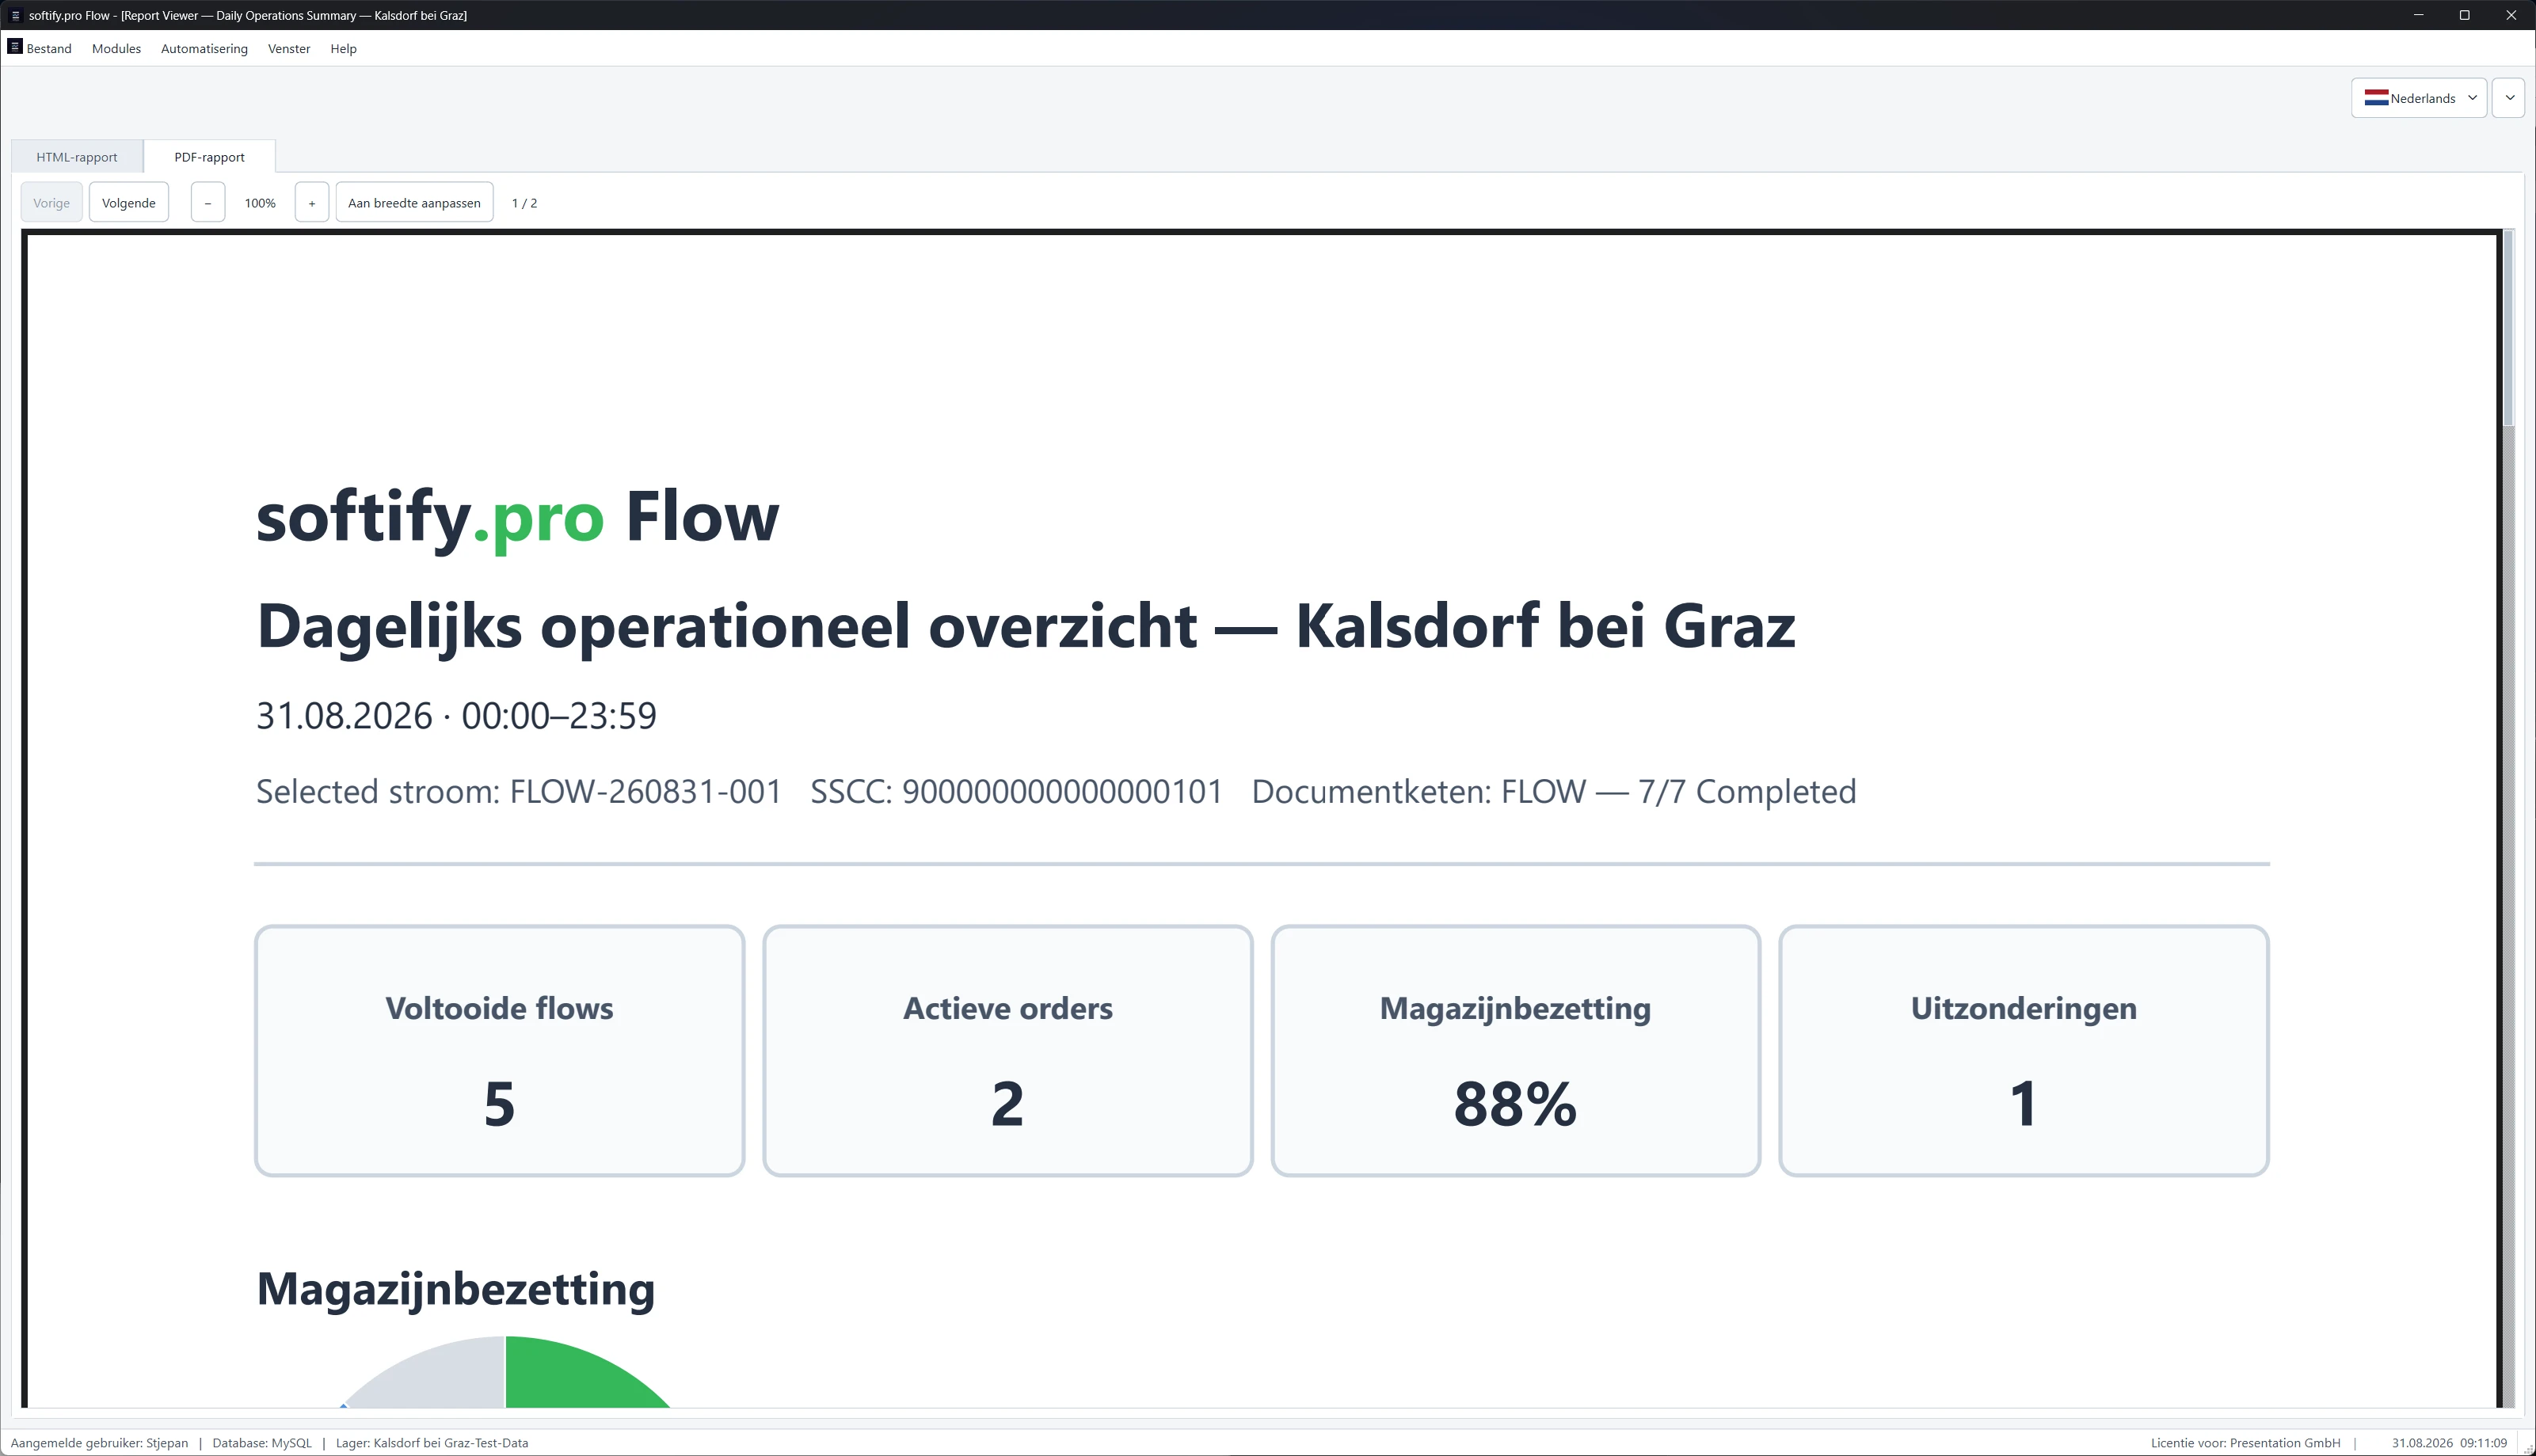
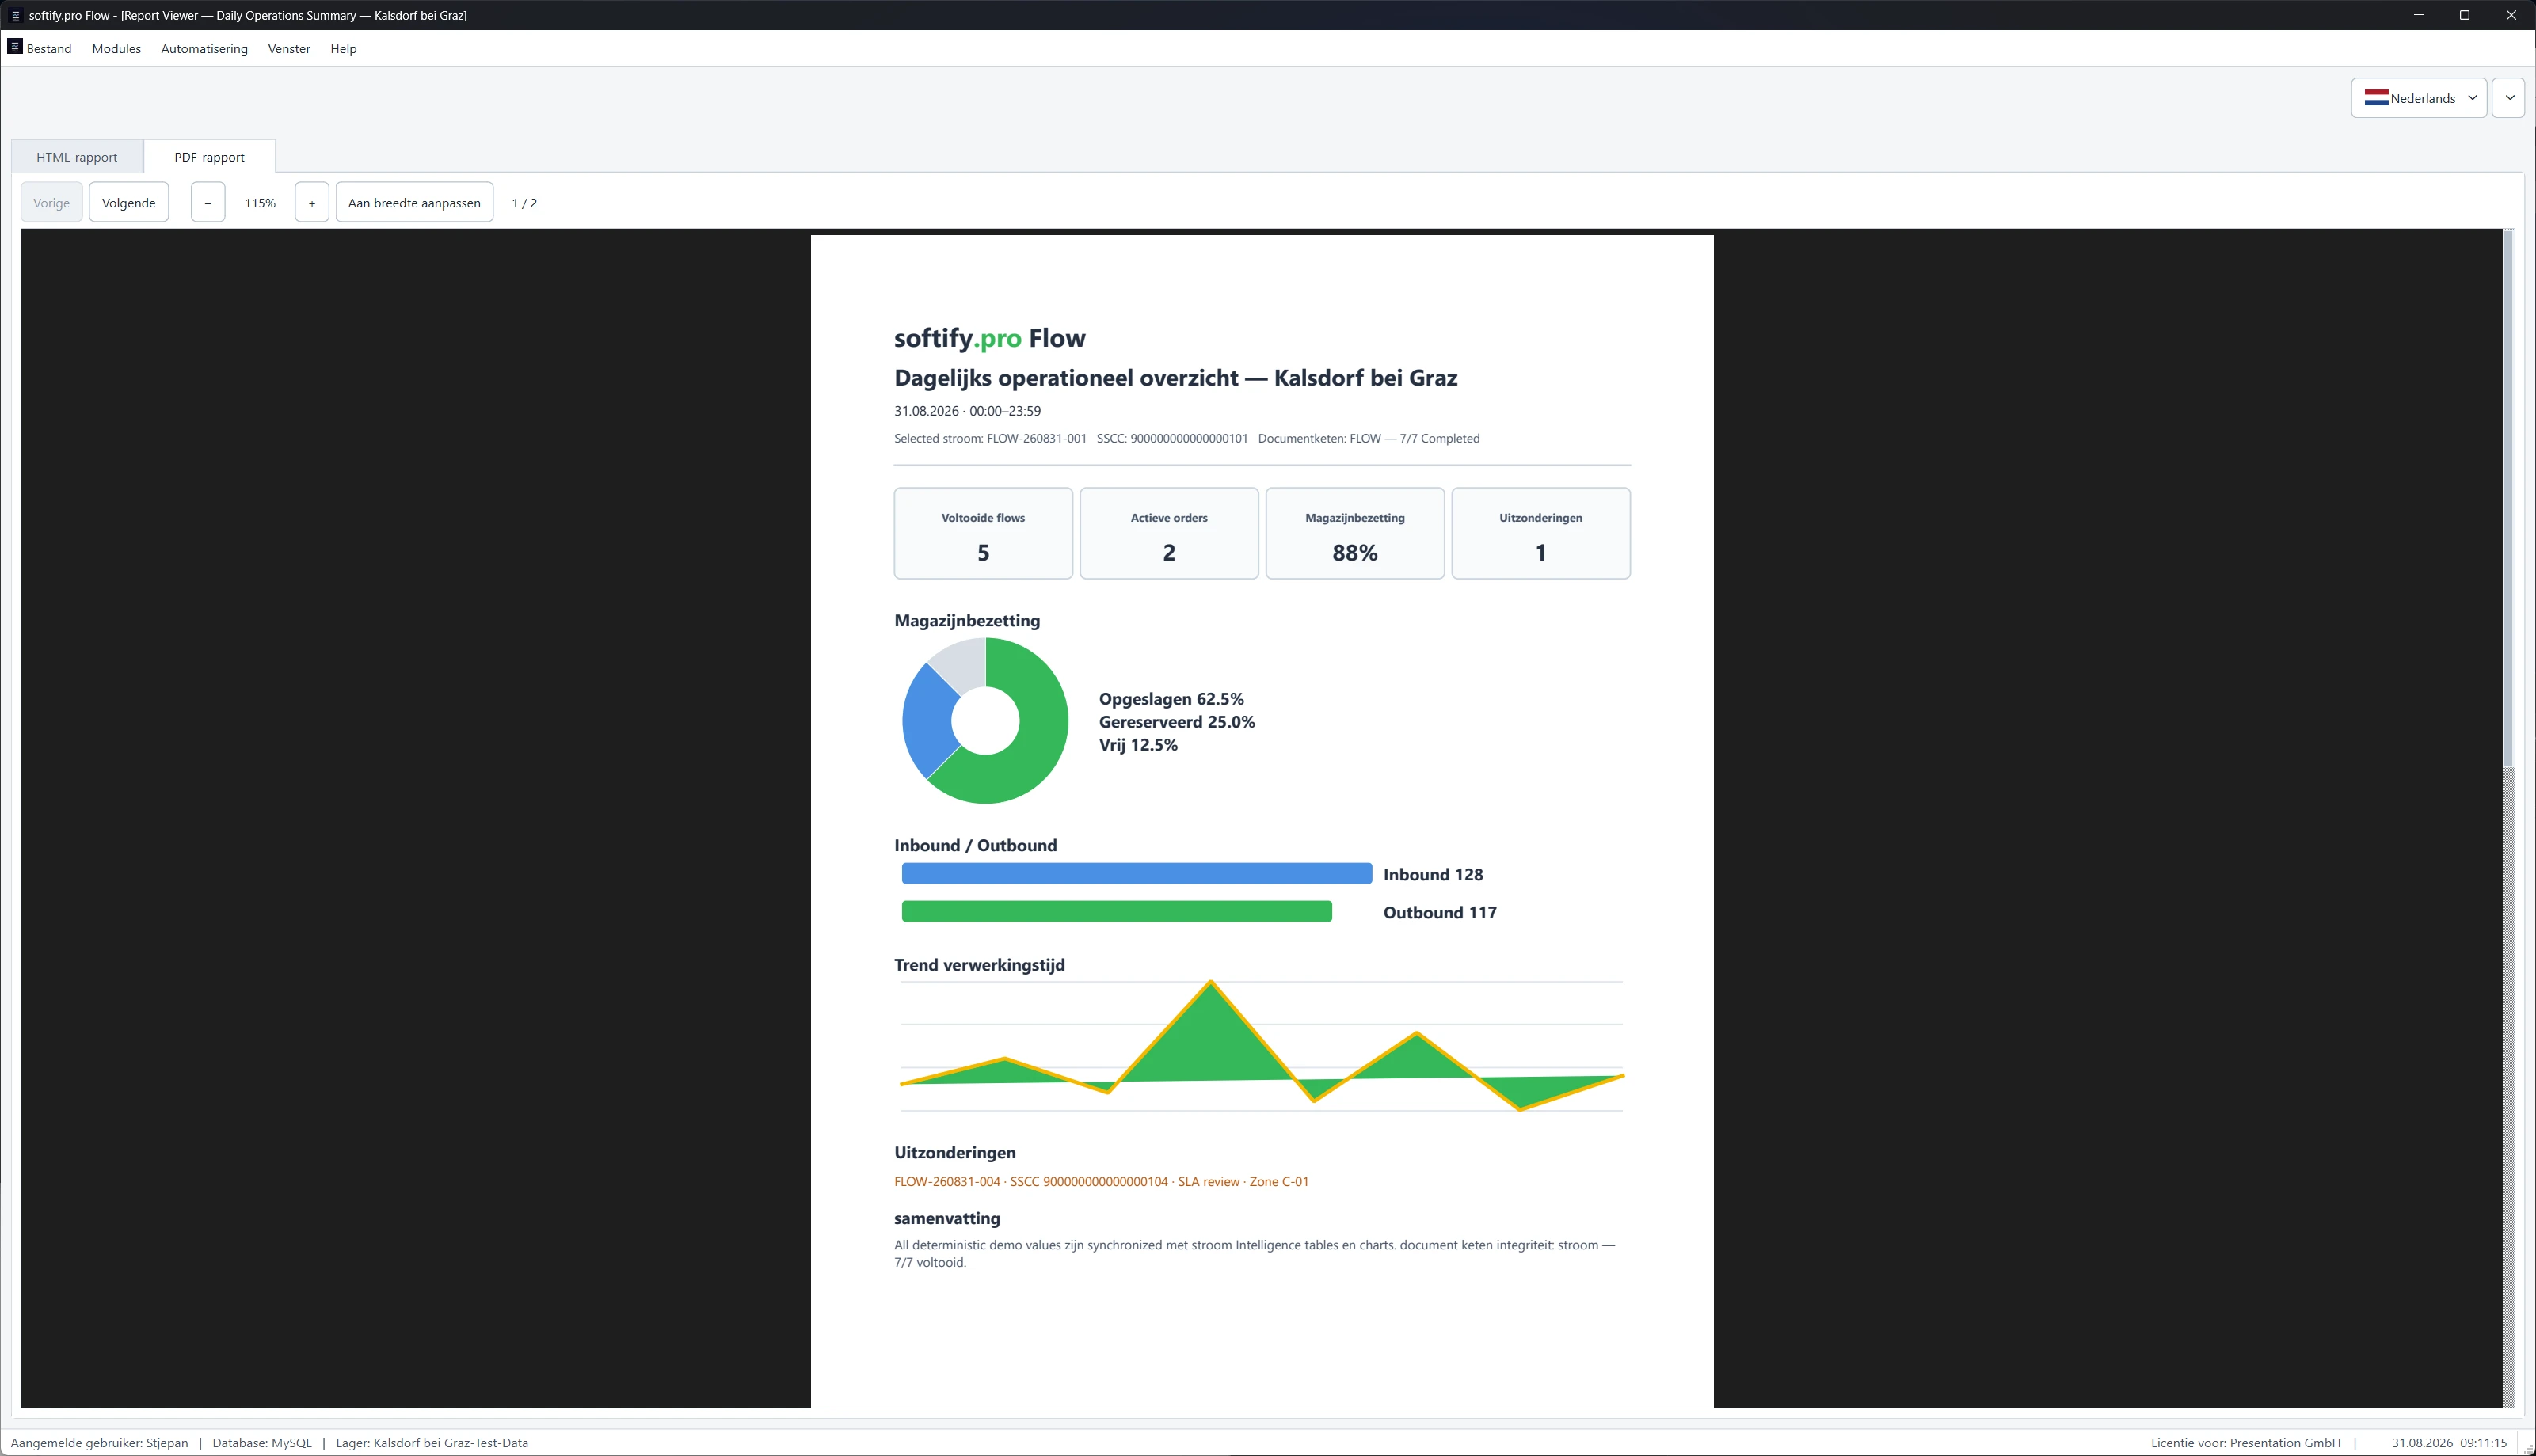
Panoramica operativa giornaliera.
Scorte e occupazione.
Performance dei Flow.
Tracciabilità SSCC.
Eccezioni e SLA.
La stessa storia operativa è riapparsa.
Flow completati.
Ordini attivi.
Utilizzo del magazzino.
Eccezioni.
Ricevimento merci.
Spedizioni.
Tempo di elaborazione.
Ma questa volta la domanda non era se il report sembrasse corretto.
La domanda era:
Può difendersi da solo?
Un buon report ti dà un numero.
Un sistema migliore può spiegare da dove viene quel numero.
Reporting dallo stesso stato operativo — non una seconda versione della realtà.
L'eccezione era ancora lì.
Uno dei dettagli più silenziosi si è rivelato uno dei più importanti.
I dati demo contengono un'eccezione.
Appare in Analytics.
Appare nel Drill-down.
Appare nella tracciabilità SSCC.
Appare nel Report Center.
E rimane visibile in Exceptions & SLA.
È esattamente ciò che dovrebbe accadere.
Riprendersi operativamente da un'eccezione non significa che l'eccezione debba scomparire dalla storia.
"Il processo è continuato" e "non è successo nulla" non sono la stessa affermazione.
Nella logistica, quella differenza conta.
A questo punto avevamo un problema di test.
Non un problema software.
Un problema di test.
Ora avevamo lo stesso magazzino rappresentato come:
- analytics,
- Flow individuali,
- cronologie SSCC,
- catene documentali,
- report,
- e viste delle eccezioni.
Ognuno poteva essere testato indipendentemente.
Aprire.
Cliccare.
Filtrare.
Verificare.
Superare.
Avanti.
Sarebbe stato facile.
Avrebbe anche perso la parte interessante.
Perché sei spunte verdi non dimostrano che sei viste concordino tra loro.
Entra in scena COCO.
Di nuovo.
COCO aveva già avuto a che fare con Flow in precedenza.
Autenticazione.
Utenti.
Ruoli.
Ambienti di database.
Lingue.
Esecuzione desktop.
Poi è arrivata la logistica.
Magazzini.
Inventario.
Prelievo.
Movimentazioni.
Eccezioni.
Documenti.
Ubuntu.
Red Hat Enterprise Linux.
Questa volta abbiamo dato a COCO qualcosa di leggermente diverso.
Non una schermata da verificare.
Una storia da seguire.
Prendi questo magazzino.
Prendi questo Flow.
Prendi questo SSCC.
Apri Analytics.
Apri Drill-down.
Cambia la lingua.
Guarda di nuovo.
Apri il report.
Trova lo stesso Flow.
Trova lo stesso SSCC.
Trova l'eccezione.
Confronta.
Poi confronta di nuovo.
COCO segue lo stesso contesto operativo attraverso softify.pro Flow — analytics, tracciabilità, cambi di lingua e reporting.
Questo cambia la natura del test.
La domanda non è più:
- Ogni modulo funziona?
Diventa:
- Tutti i moduli credono che sia accaduta la stessa cosa?
Una domanda molto migliore.
Molto meno comoda.
Un sistema di magazzino dovrebbe avere un'unica memoria.
Gli operatori possono vedere le posizioni.
I responsabili di magazzino possono vedere i KPI.
Il supporto può usare il drill-down.
Gli auditor possono usare i report.
COCO può vederli tutti.
Ma sotto queste prospettive, dovrebbe esserci un'unica storia.
Un Flow non dovrebbe acquisire diverse biografie a seconda del modulo aperto.
Un SSCC non dovrebbe avere diversi passati.
Un'eccezione non dovrebbe esistere solo dove conviene.
Un magazzino non dovrebbe diventare un altro magazzino perché è cambiata la lingua dell'interfaccia.
È di questo che tratta davvero l'attuale esperimento Flow.
Non dashboard.
Non report.
Nemmeno singole schermate.
Un'unica verità operativa, espressa in modi diversi.
Controllo.
Conoscere il magazzino.
Conoscere lo stato.
Sapere cosa si sta muovendo.
Sapere quale processo lo possiede.
Chiarezza.
Trasformare i KPI di nuovo in record.
Trasformare i record in storia.
Trasformare le eccezioni in prove.
Trasformare un SSCC in qualcosa di tracciabile.
Flow.
Un magazzino viene selezionato.
Analytics inizia a descriverlo.
Un Flow avanza.
L'SSCC rimane collegato.
Una catena documentale cresce.
Un'eccezione appare.
Il processo continua.
Il report ricorda.
Poi la lingua cambia.
Il magazzino è ancora lo stesso.
Il Flow è ancora lo stesso.
La storia è ancora la stessa.
Questa era la parte prevista.
Ciò che è successo dopo è stato più interessante.
COCO ha smesso di testare le viste in modo indipendente.
Ha iniziato a confrontarle.
Per un po', non è successo nulla di rilevante.
Stesso magazzino.
Stesso Flow.
Stesso SSCC.
Stessa storia.
Ancora.
Ancora.
Ancora.
E poi COCO si è fermato.
Non perché l'applicazione si fosse bloccata.
Non lo aveva fatto.
Non perché un test fosse fallito nel senso usuale.
Non era successo.
Si è fermato perché due risposte perfettamente ragionevoli hanno prodotto una terza domanda.
Sappiamo qual è la domanda.
Flow sa perché esiste.
COCO sa dove guardare dopo.
Il resto può aspettare.
Control. Clarity. Flow.