
Test Automation Results juist beoordelen
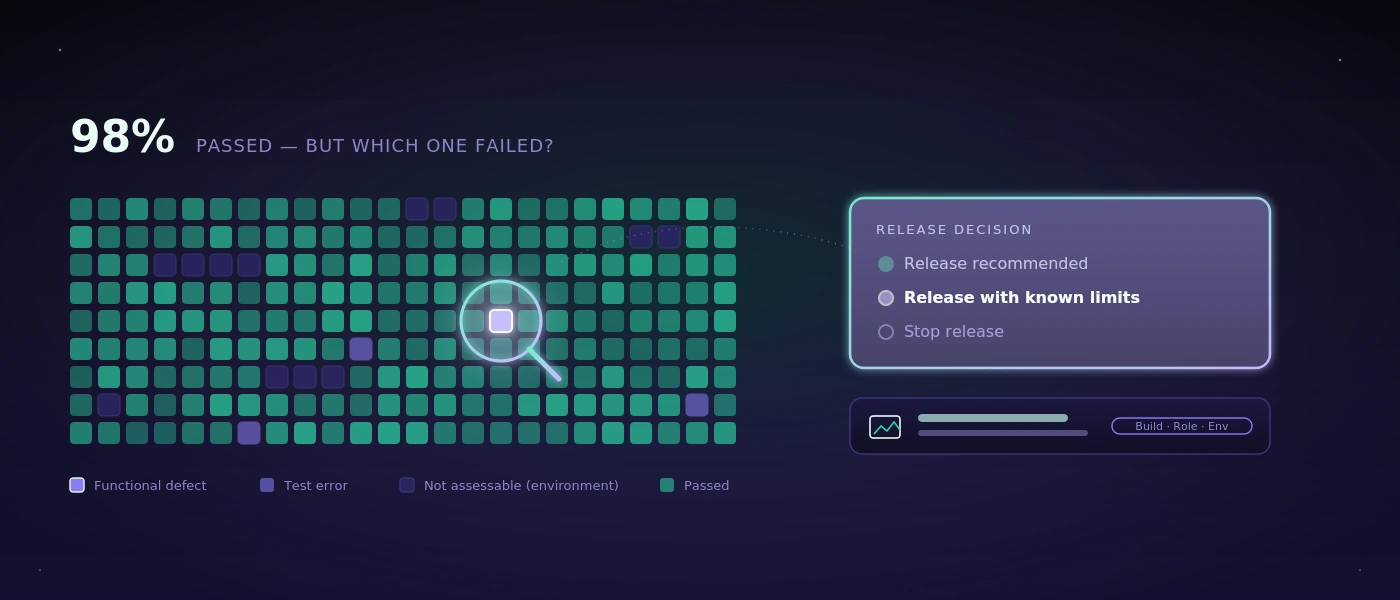
Een regressietest kan 's ochtends eindigen met 98 procent geslaagde gevallen en toch geen goed nieuws zijn. Misschien is precies de mislukte test de login van een grote klant. Misschien zijn 40 tests overgeslagen omdat de testomgeving niet bereikbaar was. Of de run was weliswaar groen, maar controleerde alleen of knoppen aanwezig zijn, niet of een order daadwerkelijk wordt opgeslagen, een leveringsbon wordt gegenereerd en de voorraad correct wordt aangepast. Test automation results zijn geen uitspraak over kwaliteit zolang hun context ontbreekt.
Voor QA-leiding, ontwikkeling en vakafdelingen ligt het eigenlijke werk daarom niet alleen in het automatiseren van tests. Doorslaggevend is om resultaten zo op te bereiden dat er betrouwbare beslissingen uit voortkomen: kan een release worden uitgerold? Moet een fout direct worden behandeld? Is de fout nieuw, teruggekeerd of slechts een probleem van de testomgeving? En zijn er bewijzen die ook een vakafdeling zonder testcode kan volgen?
Wat Test Automation Results echt zeggen
De eenvoudigste kengetal luidt: geslaagd of mislukt. Het is nuttig, maar zelden voldoende. Een hoog slagingspercentage kan vertrouwen scheppen als de tests kritieke processen afdekken, de testdata plausibel zijn en de omgeving op de latere productie lijkt. Ontbreekt een van deze factoren, dan blijft het getal vooral een signaal dat een geautomatiseerde run is uitgevoerd.
Bij bedrijfskritieke toepassingen tellen andere vragen zwaarder. In een magazijnoplossing is niet elk scherm even belangrijk. Een weergavefout in een interne hinttekst kan wachten. Een fout die bij goederenontvangst de verkeerde hoeveelheid boekt of een verzendlabel zonder afleveradres genereert, niet. Goede testresultaten wegen daarom risico's in plaats van alle gevallen gelijk te behandelen.
Ook een mislukte test is niet automatisch een productfout. Hij kan veroorzaakt worden door verlopen inloggegevens, een geblokkeerde testrol, niet-beschikbare interfaces, gewijzigde testdata of een trage omgeving. Wie deze oorzaken niet scheidt, produceert ruis. Het team besteedt dan tijd aan valse alarmen terwijl echte fouten verdwijnen tussen rode statusmeldingen.
Vier statustypen in plaats van één rode lijst
In de praktijk bewijst een duidelijke indeling haar waarde: functionele fout, technische testfout, omgevingsprobleem en verwachte wijziging. Een functionele fout betekent dat de toepassing een gedefinieerde eis schendt. Een technische testfout wijst eerder op de test zelf, bijvoorbeeld een selector die niet meer past na een bewust gewijzigde interface.
Een omgevingsprobleem doet zich voor wanneer bijvoorbeeld een testsysteem of een gekoppelde interface niet beschikbaar is. Verwachte wijzigingen ontstaan wanneer een proces bewust is aangepast, maar de automatisering nog de oude streeftoestand controleert. Deze categorieën voorkomen niet elke discussie. Maar ze zorgen ervoor dat de discussie op het juiste punt begint.
Van testruns naar beslissingsklare rapporten
Een bruikbaar rapport beantwoordt niet alleen dat iets is mislukt, maar wat er is gebeurd, hoe ernstig het is en of de fout reproduceerbaar lijkt. Daarvoor is meer nodig dan een lijst van testnamen en tijdstempels.
Bij elke relevante run horen de gecontroleerde build, de testomgeving, de gebruikte rol, centrale testdata en begin- en eindtijd. Juist bij Windows-desktoptoepassingen of complexe webplatforms is deze informatie nodig om verschillen af te bakenen. Een fout die alleen optreedt onder een beperkte magazijnrol is iets anders dan een fout die elke aanmelding blokkeert.
Betekenisvolle resultaten bevatten bovendien navolgbaar bewijs: screenshots, opgenomen stappen, foutmeldingen en zo nodig technische logboeken. Een screenshot alleen kan echter bedriegen. Het toont een moment, niet de oorzaak. De combinatie van stappenvolgorde, zichtbare toestand en verwachte reactie is veel behulpzamer.
AI-ondersteunde systemen kunnen dit bewijs omzetten in begrijpelijke beoordelingen. Bij COCO bijvoorbeeld draaien tests op een eigen, zelfgehoste AI-server. De evaluatie kan uitleggen dat een order wel is aangemaakt maar de verwachte statuswijziging uitbleef, en de opname van de uitvoering direct toewijzen. Voor veiligheidsbewuste teams is relevant waar screenshots, toepassingsgegevens en testverkeer worden verwerkt. Lokale controle is niet automatisch vereist, maar kan bij interne toepassingen en gevoelige gegevens de verstandigere weg zijn dan een externe clouddienst.
De juiste detailgraad voor verschillende ontvangers
Ontwikkelteams hebben foutmeldingen, technische stappen en zo precies mogelijke aanwijzingen voor reproductie nodig. Een operations manager heeft daarentegen eerst de getroffen functie, het bedrijfsrisico en een duidelijke uitspraak over de bedrijfsvaardigheid nodig. Beide perspectieven moeten uit dezelfde uitvoering kunnen ontstaan, zonder dat iemand resultaten handmatig in presentaties hoeft over te zetten.
Een goed rapport begint daarom met een korte beslissingslaag: vrijgave aanbevolen, vrijgave met bekende beperkingen of vrijgave stoppen. Daaronder staan de kritieke afwijkingen met prioriteit en bewijs. De technische details volgen pas daarna. Dat is geen vereenvoudiging ten koste van nauwkeurigheid, maar een nette scheiding van informatiebehoeften.
Dekking meten zonder jezelf veiligheid voor te spiegelen
Testdekking wordt vaak als percentage weergegeven. Deze waarde is nuttig wanneer duidelijk is wat ze meet. Codedekking toont bijvoorbeeld welke delen van de programmacode tijdens tests zijn uitgevoerd. Dat bewijst niet dat een bedrijfsproces correct werkt. Een test kan veel coderegels raken en toch nooit controleren of een verkeerd afleveradres op het document verschijnt.
Voor vakafdelingen is procesdekking vaak veelzeggender. Ze beschrijft welke echte processen beschermd zijn: order registreren, voorraad reserveren, deellevering boeken, retour aannemen of factuur vrijgeven. Bijzonder waardevol zijn overgangen tussen systemen en rollen, want daar ontstaan vaak fouten: bij het importeren van een bestelling, het afdrukken van een label of de wissel van kantoor naar magazijnterminal.
Prioriteer niet naar het aantal mogelijke tests, maar naar schadeimpact en wijzigingsfrequentie. Een zelden gebruikt proces met hoog financieel of juridisch risico verdient vaak eerder een automatisering dan een veelgebruikte, maar onschuldige weergave. Omgekeerd kan een stabiel, weinig kritiek proces nog steeds volstaan met een korte handmatige controle. Niet elke controle hoeft geautomatiseerd te worden alleen omdat het kan.
Instabiele tests zijn een eigen kwaliteitsprobleem
Tests die zonder herkenbare productwijziging soms slagen en soms mislukken, worden vaak flaky genoemd. Ze beschadigen vertrouwen sneller dan een permanent rode test. Zodra teams rode resultaten reflexmatig opnieuw starten, verliest de automatisering haar waarschuwingsfunctie.
De oorzaken zijn meestal concreet: vaste wachttijden, gedeelde testdata, parallelle toegang, asynchrone verwerking of een omgeving die niet wordt teruggezet. Een korte pauze van drie seconden in de test kan toevallig helpen, maar is geen oplossing. Beter is te wachten op een aantoonbare toestand, testdata uniek te maken en processen van elkaar te isoleren.
Niet elke instabiliteit is volledig te vermijden. Externe interfaces kunnen schommelen en echte infrastructuur kent storingen. Dan moet het rapport duidelijk aangeven of een test vanwege een externe afhankelijkheid niet beoordeelbaar was. Een herhaalde run kan voor diagnose zinvol zijn, maar mag de eerste bevinding niet onzichtbaar maken.
Een zinvol verloop na elke testrun
Na een geautomatiseerde run moet niet elk resultaat meteen gelijk worden behandeld. Eerst worden blokkerende fouten en niet-beoordeelbare kritieke tests gecontroleerd. Daarna volgt de indeling van nieuwe afwijkingen tegenover bekende, geaccepteerde problemen. Pas dan is een releasebeslissing deugdelijk.
Vastgelegde drempelwaarden helpen, maar ze moeten bij het proces passen. Zo kan een mislukte test in de betalings- of autorisatiestroom een onmiddellijke stop uitlokken. Bij een puur cosmetische afwijking kan een gedocumenteerde uitzondering verdedigbaar zijn. Zulke regels mogen niet pas onder tijdsdruk vóór een release ontstaan.
Even belangrijk is de terugkoppeling: elke productiefout die door de tests niet werd herkend, is een aanleiding om te controleren of een scenario, een testdatavariant of een controlepunt ontbreekt. Het doel is niet zoveel mogelijk tests op te stapelen. Het is om uit echte fouten gericht betere borging te bouwen.
De nuttigste testresultaten zijn uiteindelijk niet die met het groenste overzicht. Het zijn die waarbij een verantwoordelijke op maandagochtend kan nagaan wat gecontroleerd is, welk risico blijft en welke handeling nu verstandig is.