
Bien évaluer les Test Automation Results
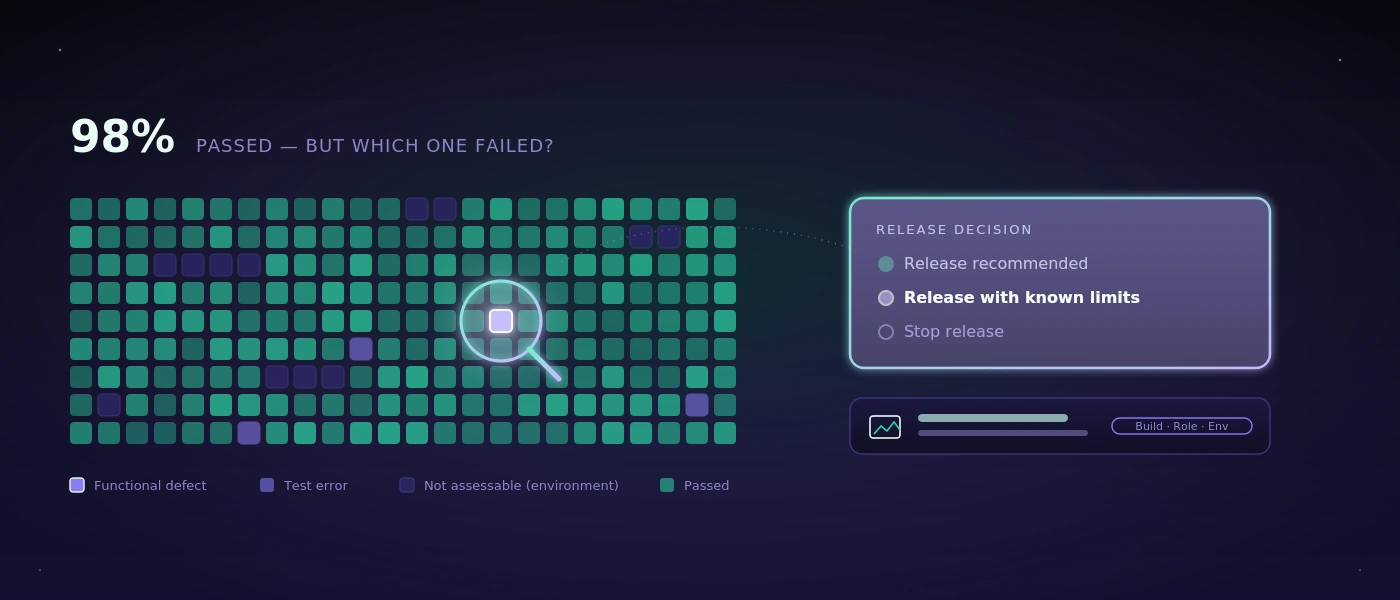
Un test de régression peut se terminer le matin avec 98 pour cent de cas réussis et ne pas être pour autant une bonne nouvelle. Peut-être que le test échoué est justement la connexion d'un grand client. Peut-être que 40 tests ont été ignorés parce que l'environnement de test n'était pas joignable. Ou bien l'exécution était verte, mais ne vérifiait que l'existence des boutons, pas si une commande est réellement enregistrée, un bon de livraison généré et le stock correctement ajusté. Les Test automation results ne sont pas une affirmation sur la qualité tant que leur contexte manque.
Pour la direction QA, le développement et les services métier, le vrai travail ne réside donc pas seulement dans l'automatisation des tests. L'essentiel est de préparer les résultats de manière à en tirer des décisions fiables : une version peut-elle être déployée ? Une erreur doit-elle être traitée immédiatement ? L'erreur est-elle nouvelle, récurrente ou seulement un problème de l'environnement de test ? Et existe-t-il des preuves qu'un service métier sans code de test peut aussi comprendre ?
Ce que disent vraiment les Test Automation Results
L'indicateur le plus simple est : réussi ou échoué. Il est utile, mais rarement suffisant. Un taux de réussite élevé peut créer la confiance si les tests couvrent des processus critiques, si les données de test sont plausibles et si l'environnement ressemble à l'exploitation future. Si l'un de ces facteurs manque, le chiffre reste surtout un signal indiquant qu'une exécution automatisée a eu lieu.
Pour les applications critiques pour l'activité, d'autres questions comptent davantage. Dans une solution d'entrepôt, tous les écrans ne sont pas aussi importants. Une erreur d'affichage dans un texte d'aide interne peut attendre. Une erreur qui enregistre la mauvaise quantité à la réception de marchandises ou génère une étiquette d'expédition sans adresse de destinataire, non. De bons résultats de test pondèrent donc les risques au lieu de traiter tous les cas de la même façon.
Un test échoué n'est pas non plus automatiquement un défaut du produit. Il peut être déclenché par des identifiants expirés, un rôle de test verrouillé, des interfaces indisponibles, des données de test modifiées ou un environnement lent. Qui ne sépare pas ces causes produit du bruit. L'équipe passe alors du temps sur de fausses alertes pendant que de vraies erreurs se perdent parmi les messages de statut rouges.
Quatre types de statut au lieu d'une liste rouge
Une classification claire a fait ses preuves en pratique : erreur fonctionnelle, erreur technique du test, problème d'environnement et changement attendu. Une erreur fonctionnelle signifie que l'application enfreint une exigence définie. Une erreur technique du test renvoie plutôt au test lui-même, par exemple un sélecteur qui ne correspond plus après une interface délibérément modifiée.
Un problème d'environnement existe lorsque, par exemple, un système de test ou une interface connectée n'est pas disponible. Les changements attendus surviennent quand un processus a été délibérément adapté, mais que l'automatisation vérifie encore l'ancien état cible. Ces catégories n'évitent pas toute discussion. Mais elles font en sorte que la discussion commence au bon endroit.
Des exécutions de tests aux rapports prêts à la décision
Un rapport utilisable ne répond pas seulement qu'une chose a échoué, mais ce qui s'est passé, quelle en est la gravité et si l'erreur paraît reproductible. Cela demande plus qu'une liste de noms de tests et d'horodatages.
À chaque exécution pertinente appartiennent la build vérifiée, l'environnement de test, le rôle utilisé, les principales données de test ainsi que l'heure de début et de fin. Surtout avec des applications de bureau Windows ou des plateformes web complexes, ces informations sont nécessaires pour cerner les différences. Une erreur qui n'apparaît que sous un rôle d'entrepôt restreint est autre chose qu'une erreur qui bloque chaque connexion.
Des résultats significatifs contiennent en outre des preuves traçables : captures d'écran, étapes enregistrées, messages d'erreur et, si nécessaire, journaux techniques. Une capture d'écran seule peut toutefois tromper. Elle montre un instant, pas la cause. La combinaison de la séquence d'étapes, de l'état visible et de la réaction attendue est bien plus utile.
Les systèmes assistés par IA peuvent transformer ces preuves en évaluations compréhensibles. Avec COCO, par exemple, les tests s'exécutent sur un serveur IA dédié et auto-hébergé. L'évaluation peut expliquer qu'une commande a bien été créée mais que le changement de statut attendu n'a pas eu lieu, et rattacher directement l'enregistrement de l'exécution. Pour les équipes soucieuses de sécurité, il importe de savoir où sont traités les captures d'écran, les données applicatives et le trafic de test. Le contrôle local n'est pas automatiquement nécessaire, mais pour des applications internes et des données sensibles, il peut être la voie la plus judicieuse par rapport à un service cloud externe.
Le bon niveau de détail pour différents destinataires
Les équipes de développement ont besoin de messages d'erreur, d'étapes techniques et d'indications aussi précises que possible pour la reproduction. Un responsable des opérations a en revanche besoin d'abord de la fonction concernée, du risque métier et d'une affirmation claire sur la capacité d'exploitation. Les deux perspectives doivent pouvoir découler de la même exécution, sans que personne n'ait à transférer manuellement des résultats dans des présentations.
Un bon rapport commence donc par un court niveau décisionnel : mise en production recommandée, mise en production avec limitations connues ou arrêt de la mise en production. En dessous figurent les écarts critiques avec priorité et preuve. Les détails techniques ne suivent qu'ensuite. Ce n'est pas une simplification au détriment de la précision, mais une séparation nette des besoins d'information.
Mesurer la couverture sans se bercer d'illusions
La couverture de test est souvent présentée sous forme de pourcentage. Cette valeur est utile quand on sait ce qu'elle mesure. La couverture de code montre par exemple quelles parties du code du programme ont été exécutées pendant les tests. Cela ne prouve pas qu'un processus métier fonctionne correctement. Un test peut toucher beaucoup de lignes de code et ne jamais vérifier si une mauvaise adresse de livraison apparaît sur le document.
Pour les services métier, la couverture des processus est souvent plus parlante. Elle décrit quels flux réels sont protégés : saisir une commande, réserver du stock, enregistrer une livraison partielle, accepter un retour ou valider une facture. Les passages entre systèmes et rôles sont particulièrement précieux, car c'est là que les erreurs surviennent souvent : à l'import d'une commande, à l'impression d'une étiquette ou lors du passage du bureau au terminal d'entrepôt.
Ne priorisez pas selon le nombre de tests possibles, mais selon l'impact des dommages et la fréquence des modifications. Un processus rarement utilisé avec un risque financier ou juridique élevé mérite souvent une automatisation plus tôt qu'une vue fréquemment utilisée mais inoffensive. Inversement, un processus stable et peu critique peut continuer à se contenter d'un bref contrôle manuel. Tout contrôle n'a pas à être automatisé simplement parce qu'il est automatisable.
Les tests instables sont un problème de qualité à part entière
Les tests qui réussissent parfois et échouent parfois sans changement identifiable du produit sont souvent qualifiés de flaky. Ils abîment la confiance plus vite qu'un test durablement rouge. Dès que les équipes relancent par réflexe les résultats rouges, l'automatisation perd sa fonction d'alerte.
Les causes sont généralement concrètes : attentes fixes, données de test partagées, accès parallèles, traitement asynchrone ou un environnement qui n'est pas réinitialisé. Une courte pause de trois secondes dans le test peut aider par hasard, mais ce n'est pas une solution. Il vaut mieux attendre un état vérifiable, rendre les données de test uniques et isoler les processus les uns des autres.
Toute instabilité ne peut pas être évitée complètement. Les interfaces externes peuvent fluctuer et l'infrastructure réelle connaît des pannes. Le rapport devrait alors indiquer clairement si un test n'était pas évaluable en raison d'une dépendance externe. Une exécution répétée peut être utile pour le diagnostic, mais elle ne doit pas rendre invisible le premier constat.
Un déroulement judicieux après chaque exécution de tests
Après une exécution automatisée, tous les résultats ne devraient pas être traités immédiatement de la même façon. On examine d'abord les erreurs bloquantes et les tests critiques non évaluables. Vient ensuite le classement des nouveaux écarts par rapport aux problèmes connus et acceptés. Ce n'est qu'alors qu'une décision de mise en production est solide.
Des seuils définis sont utiles, mais ils doivent correspondre au processus. Par exemple, un test échoué dans le flux de paiement ou d'autorisation peut déclencher un arrêt immédiat. Pour un écart purement cosmétique, une exception documentée peut être acceptable. De telles règles ne devraient pas n'apparaître que sous la pression du temps avant une mise en production.
Le retour d'expérience est tout aussi important : chaque erreur en production que les tests n'ont pas détectée est une occasion de vérifier s'il manque un scénario, une variante de données de test ou un point de contrôle. L'objectif n'est pas d'accumuler un maximum de tests. C'est de construire, à partir d'erreurs réelles, une meilleure protection ciblée.
Les résultats de test les plus utiles ne sont finalement pas ceux dont la vue d'ensemble est la plus verte. Ce sont ceux pour lesquels un responsable peut comprendre, le lundi matin, ce qui a été vérifié, quel risque subsiste et quelle action est maintenant raisonnable.