
Secure test data management utan att förlora kontrollen
En misslyckad testkörning är irriterande. En lyckad testkörning med riktiga kunddata i en otillräckligt skyddad miljö kan visa sig betydligt dyrare. Secure test data management löser inte den motsättningen med ett enda verktyg, utan med tydliga regler för data, åtkomst, testmiljöer, och bevis. För team som automatiserat testar webb- eller Windows-applikationer hör det därför till kvalitetsarbetet - inte bara till efterlevnad.
Varför testdata blir ett säkerhetsproblem
Produktionsdata är lockande för tester eftersom det innehåller riktiga specialfall: ofullständiga adresser, ovanliga orderkombinationer, historiska prisregler, eller felaktiga inmatningar. Men just den datan innehåller ofta namn, kontaktuppgifter, avtalsinformation, personalnummer, bankuppgifter, eller intern affärslogik.
Risken uppstår sällan genom ett enda grovt misstag. Den växer oftast steg för steg: en databasexport skapas för ett test, läggs i en delad katalog, och kopieras senare till en annan miljö. En extern tjänst får skärmdumpar för felanalys. Ett testkonto behåller omfattande rättigheter eftersom en sanering skulle kunna störa nästa körning. Efter några månader vet ingen längre tillförlitligt vilken data som finns var.
Hos små och medelstora företag förvärras problemet ofta av knapp kapacitet. Teamet vill hålla en releasedeadline, inte driva ett eget dataskyddsprojekt. Ansvaret kvarstår ändå. Den som använder data för kvalitetssäkring måste kunna spåra vilken data som behandlas, vem som har åtkomst, och när den tas bort igen.
Secure test data management börjar före testfallet
Den avgörande frågan är inte: "Hur skyddar vi testdatabeståndet?" Den är: "Vilken information behöver det här testet egentligen?" Många regressionstester behöver inga riktiga personreferenser alls. En fraktprocess måste till exempel kontrollera att leveransadresser, vikter, zoner, etiketter, och statusändringar behandlas korrekt. Syntetiska kunder, rimliga artikelstamdata, och medvetet definierade gränsfall räcker för det.
Denna åtskillnad leder till en praktisk dataklassificering. Inte varje testmiljö behöver samma datadjup. För enhets- och integrationstester räcker ofta helt konstgjorda datamängder. För end-to-end-tester kan pseudonymiserade kopior vara meningsfulla, om verkliga datamönster är sakligt relevanta. Produktionsliknande data bör vara undantaget - med dokumenterat syfte, begränsad åtkomst, och en fast livslängd.
Viktigt här är kvaliteten på ersättningsdatan. Slumpmässig påhittad data hjälper föga om den inte återspeglar realistiska beroenden. En testdatamängd för en lagerapplikation måste till exempel innehålla artikelvarianter, lagerplatser, spärrat lager, delleveranser, och returer i en samstämmig kombination. Bra testdata skyddar inte bara personuppgifter. De hittar buggar som aldrig skulle synas med tomma tabeller och exempelkunden "Sven Svensson".
Syntetisera, maskera, eller minimera?
Syntetisk data är det säkraste valet när de sakliga reglerna kan modelleras rent. Den uppstår riktat ur testkrav och innehåller ingen kopia av verkliga personer eller transaktioner. Ansträngningen ligger i underhållet: ändras datamodellen eller tillkommer nya processregler måste generatorer och fixtures växa med.
Maskering passar när en applikations beteende är starkt beroende av produktionsstrukturer. Därvid ersätts eller ändras känsliga fält, medan relationer behålls. Namn blir rimliga men fiktiva namn; e-postadresser blir icke-levererbara testadresser; kontonummer blir värden med korrekt format utan verklig koppling. En maskering är bara hållbar om även indirekta slutsatser beaktas. En kombination av en sällsynt plats, födelsedatum, och avtalsegenskap kan fortfarande göra en person identifierbar.
Dataminimering är ofta den underskattade tredje vägen. Istället för att kopiera en fullständig export tillhandahålls endast det nödvändiga utsnittet. Det minskar attackytan, lagringsbehovet, och saneringsinsatsen. För att testa en rabattlogik behöver ingen en hel kunds hela årshistorik.
Åtkomst och miljöer måste matcha risken
En skyddad datamängd förlorar sitt värde om den ligger i en fritt tillgänglig testmiljö. Testsystem behöver därför egna säkerhetsgränser - separata databaser, egna tjänstekonton, tydligt definierad nätverksåtkomst, och ingen tyst anslutning till produktion.
Åtkomsträttigheter bör baseras på roller, inte på delade konton. Utvecklare kan behöva andra rättigheter än QA, support, eller externa tjänsteleverantörer. Administratörsåtkomst är ibland nödvändig, men bör vara tidsbegränsad, loggad, och kopplad till ett spårbart godkännande. Även för testkonton gäller förnuftiga lösenordsregler, multifaktorautentisering där den finns tillgänglig, och kontospärrflöden vid upprepade misslyckade försök.
Automatiserade tester medför ytterligare ett specialfall: de genererar bevis. Skärmdumpar, skärminspelningar, loggar, och felmeddelanden kan innehålla känsligt innehåll, även när databasen har maskerats. En skärmdump av en kundvy, ett webbläsarspår med sessionsinformation, eller en logg med API-nyttolast hör till samma skyddsöverväganden som testdatabasen.
Därför behöver testartefakter bevaranderegler. Inte varje lyckad körning behöver lagras permanent. För kritiska godkännanden kan spårbar bevisning vara meningsfull, till exempel med tidsstämpel, byggnummer, testversion, och resultat. Misslyckade körningar behöver ofta ett längre analysfönster. Efter det bör artefakter raderas automatiskt. Det som inte längre finns kan inte oavsiktligt delas eller komprometteras.
Automatisering utan okontrollerade dataläckor
AI-stödd testautomatisering kan avsevärt påskynda tester, särskilt för omfattande webb- och Windows-applikationer. Men den förändrar säkerhetsfrågan: vart tar skärmdumpar, inmatningar, felbeskrivningar, och applikationstrafik vägen? Vem behandlar dem? Hur länge stannar de där?
För säkerhetsmedvetna team är självhostad exekvering ofta den bättre arkitekturen. Ett system som COCO kan köras inom den egna eller en tydligt avgränsad infrastruktur, exekvera teststeg, lagra bevis, och generera begripliga bedömningar. Det är inte obligatoriskt i varje situation. För en offentlig marknadsföringssida med rent syntetiska formulärvärden kan en extern tjänst vara försvarbar. Vid interna verksamhetsapplikationer, kundportaler, eller mjukvara med personrelaterade processer är dock lokal kontroll en konkret fördel.
Självhostning är inget frikort. Driften kräver uppdateringar, backupkoncept, åtkomstloggar, och en ansvarig instans. I gengäld förblir datasuveräniteten där den hör hemma. Rätt tillvägagångssätt beror på skyddsbehov, befintlig driftsförmåga, och typen av testad applikation - inte på den aktuella hypen kring ett visst testverktyg.
Så blir regler en arbetsduglig process
En genomförbar process behöver inte blockera releasen. Börja med en datakarta: vilka testmiljöer finns, vilka datatyper finns där, och vilka system genererar ytterligare artefakter? Denna inventering avslöjar oftast redan gamla exporter, glömda staging-system, och oklara ansvarsområden.
Därefter lönar sig en enkel beslutsmatris per testklass. Den avgör om syntetisk data räcker, en maskering krävs, eller ett tydligt motiverat produktionsutdrag behövs. Den kompletteras med ägare, raderingsfrister, och åtkomstroller. Det behöver inte vara ett överlastat regelverk. En kort, faktiskt efterlevd riktlinje är bättre än ett säkerhetsdokument som ingen hittar under en störning.
Tekniskt hör datatillhandahållande och sanering hemma i testpipelinen. En körning skapar reproducerbart de datamängder den behöver, använder unika markörer, och tar sedan bort dem igen. Det förhindrar att testmiljöer fylls med restdata och resultat blir mindre trovärdiga med varje sprint. För kritiska processer bör team dessutom kontrollera om dataåtkomst och testbevis behöver loggas på ett revisionssäkert sätt.
Säkerhet som gör testandet snabbare
Secure test data management ses ofta som ytterligare kontrollbörda. Dåligt implementerat kan det verkligen vara det. Väl implementerat skapar det dock tillförlitliga, repeterbara utgångsvillkor. Team slösar mindre tid på att leta efter en användbar dataexport, undviker trasiga tester på grund av osanerad kvarvarande data, och kan bättre motivera godkännanden.
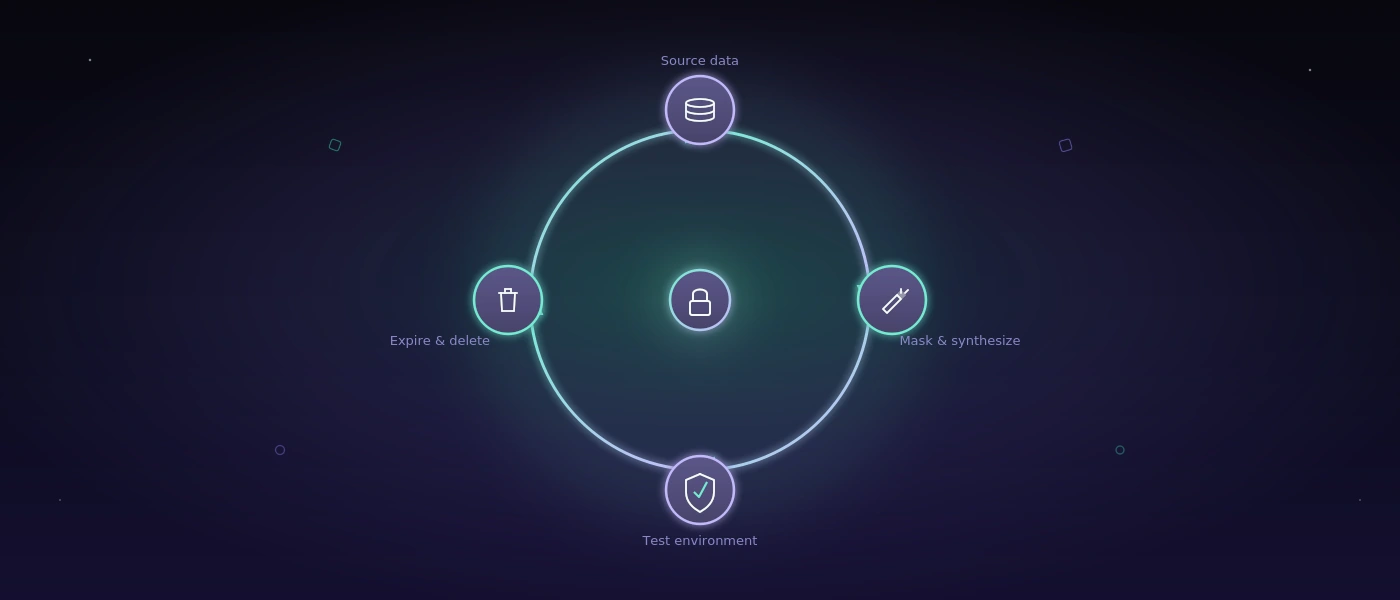
Det mest förnuftiga första steget är sällan ett stort plattformsprojekt. Ta testprocessen med högst risk eller störst friktion - till exempel godkännandet av en intern orderapplikation - och gör datakälla, åtkomst, artefakter, och radering synliga där. Ur det konkreta arbetet växer en säkerhetsrutin som inte gör testerna tyngre, utan mer trovärdiga.