
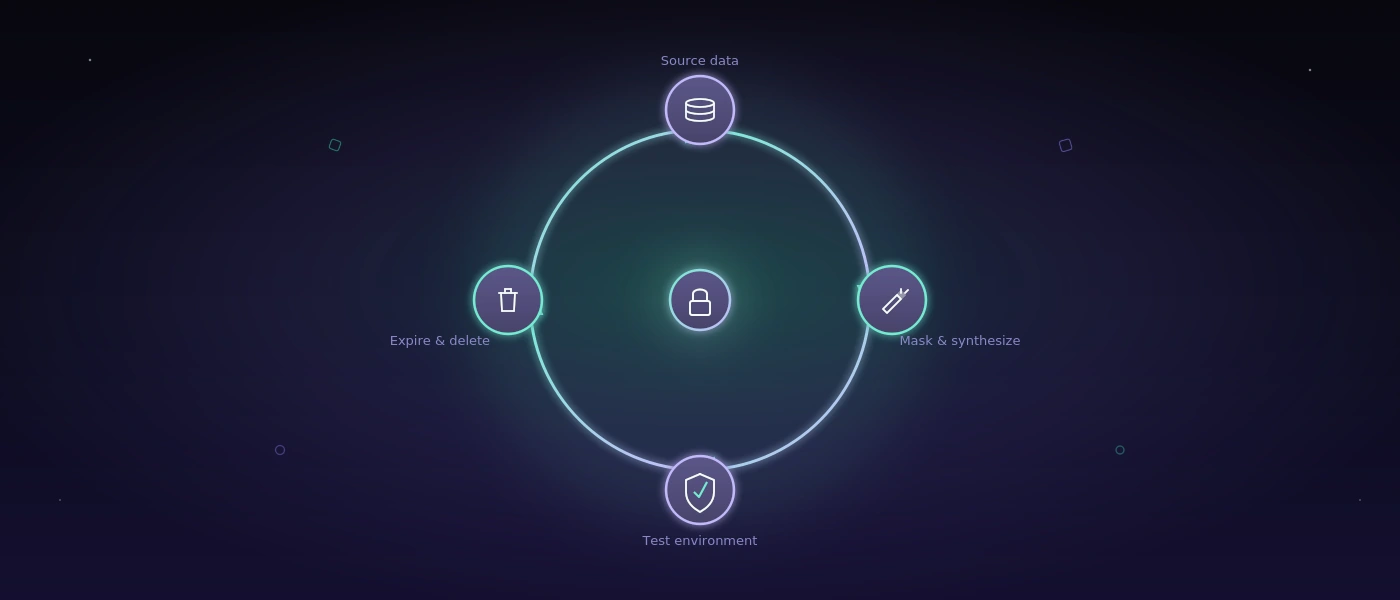
Secure test data management brez izgube nadzora
Neuspešen testni zagon je moteč. Uspešen testni zagon z resničnimi podatki strank v nezadostno zaščitenem okolju je lahko precej dražji. Secure test data management tega nasprotja ne rešuje z enim samim orodjem, temveč z jasnimi pravili za podatke, dostope, testna okolja, in dokaze. Za ekipe, ki avtomatizirano testirajo spletne ali Windows aplikacije, to zato sodi h kakovostnemu delu - ne le k skladnosti.
Zakaj testni podatki postanejo varnostna težava
Produkcijski podatki so za teste mamljivi, ker vsebujejo resnične robne primere: nepopolne naslove, nenavadne kombinacije naročil, zgodovinska cenovna pravila, ali napačne vnose. Vendar prav ti podatki pogosto vsebujejo imena, kontaktne podatke, pogodbene informacije, kadrovske številke, bančne podatke, ali interno poslovno logiko.
Tveganje redko nastane zaradi ene same grobe napake. Običajno raste postopoma: izvoz baze podatkov se ustvari za test, odloži v skupno mapo, in kasneje kopira v drugo okolje. Zunanja storitev prejme posnetke zaslona za analizo napak. Testni račun ohrani obsežne pravice, ker bi čiščenje lahko motilo naslednji zagon. Po nekaj mesecih nihče več zanesljivo ne ve, kateri podatki so kje.
Pri majhnih in srednje velikih podjetjih se težava pogosto zaostri zaradi omejenih zmogljivosti. Ekipa želi izpolniti rok izdaje, ne pa voditi lastnega projekta varstva podatkov. Odgovornost pa vseeno ostaja. Kdor uporablja podatke za zagotavljanje kakovosti, mora znati slediti, kateri podatki se obdelujejo, kdo ima do njih dostop, in kdaj se ponovno odstranijo.
Secure test data management se začne pred testnim primerom
Odločilno vprašanje ni: "Kako ščitimo nabor testnih podatkov?" Je: "Katero informacijo ta test dejansko potrebuje?" Številni regresijski testi sploh ne potrebujejo resničnih osebnih referenc. Postopek pošiljanja mora na primer preveriti, ali se dostavni naslovi, teže, cone, nalepke, in spremembe statusa obdelujejo pravilno. Za to zadostujejo sintetične stranke, verjetni matični podatki artiklov, in zavestno opredeljeni robni primeri.
To razlikovanje vodi do praktične klasifikacije podatkov. Ne potrebuje vsako testno okolje enake globine podatkov. Za enotske in integracijske teste pogosto zadostujejo povsem umetni nabori podatkov. Za end-to-end teste so lahko smiselne psevdonimizirane kopije, če so resnični vzorci podatkov strokovno relevantni. Podatki, podobni produkcijskim, bi morali biti izjema - z dokumentiranim namenom, omejenim dostopom, in fiksno življenjsko dobo.
Pri tem je pomembna kakovost nadomestnih podatkov. Naključni izmišljeni podatki malo pomagajo, če ne odražajo realističnih odvisnosti. Nabor testnih podatkov za skladiščno aplikacijo mora na primer vsebovati variante artiklov, skladiščne lokacije, blokirane zaloge, delne dobave, in vračila v skladni kombinaciji. Dobri testni podatki ne ščitijo le osebnih informacij. Najdejo napake, ki z praznimi tabelami in vzorčno stranko "Janez Novak" nikoli ne bi postale vidne.
Sintetizirati, maskirati, ali minimizirati?
Sintetični podatki so najvarnejša izbira, ko se lahko strokovna pravila čisto modelirajo. Nastanejo ciljno iz testnih zahtev in ne vsebujejo nobene kopije resničnih oseb ali transakcij. Trud je v vzdrževanju: če se podatkovni model spremeni ali se dodajo nova pravila procesa, morajo generatorji in fixtures rasti skupaj z njimi.
Maskiranje je primerno, kadar je obnašanje aplikacije močno odvisno od produkcijskih struktur. Pri tem se občutljiva polja nadomestijo ali spremenijo, medtem ko se razmerja ohranijo. Iz imen nastanejo verjetna, a izmišljena imena; iz e-poštnih naslovov nastanejo nedostavljivi testni naslovi; iz številk računov nastanejo vrednosti pravilne oblike brez resnične povezave. Maskiranje je zanesljivo le, če se upoštevajo tudi posredni sklepi. Kombinacija redkega kraja, datuma rojstva, in pogodbene značilnosti lahko osebo še vedno naredi prepoznavno.
Minimizacija podatkov je pogosto podcenjena tretja pot. Namesto kopiranja celotnega izvoza se zagotovi le potreben izsek. To zmanjša napadalno površino, potrebo po shranjevanju, in trud čiščenja. Za test logike popusta nihče ne potrebuje celotne letne zgodovine strank.
Dostopi in okolja morajo ustrezati tveganju
Zaščiten nabor podatkov izgubi svojo vrednost, če je v prosto dostopnem testnem okolju. Testni sistemi zato potrebujejo lastne varnostne meje - ločene baze podatkov, lastne storitvene račune, jasno opredeljene omrežne dostope, in nobene tihe povezave s produkcijo.
Pravice dostopa bi morale temeljiti na vlogah, ne na skupnih računih. Razvijalci morda potrebujejo drugačne pravice kot QA, podpora, ali zunanji ponudniki storitev. Skrbniški dostopi so včasih potrebni, vendar bi morali biti časovno omejeni, beleženi, in povezani s sledljivo odobritvijo. Tudi za testne račune veljajo smiselna gesla, večfaktorska avtentikacija, kjer je na voljo, in postopki zaklepanja računa ob ponovljenih neuspešnih poskusih.
Avtomatizirani testi prinašajo še en poseben primer: ustvarjajo dokaze. Posnetki zaslona, snemanja zaslona, dnevniki, in sporočila o napakah lahko vsebujejo občutljivo vsebino, tudi če je baza podatkov maskirana. Posnetek zaslona maske stranke, sled brskalnika s podatki o seji, ali dnevnik z API payloadom sodijo v isto varnostno obravnavo kot testna baza podatkov.
Zato testni artefakti potrebujejo pravila hrambe. Ni treba vsakega uspešnega zagona trajno shraniti. Za kritične odobritve je lahko smiseln sledljiv dokaz, na primer s časovnim žigom, številko izgradnje, testno različico, in rezultatom. Neuspešni zagoni pogosto potrebujejo daljše obdobje analize. Nato bi bilo treba artefakte samodejno izbrisati. Kar ne obstaja več, ne more biti nehote deljeno ali ogroženo.
Avtomatizacija brez nenadzorovanega uhajanja podatkov
Testna avtomatizacija, podprta z umetno inteligenco, lahko občutno pospeši teste, zlasti pri obsežnih spletnih in Windows aplikacijah. Vendar spremeni varnostno vprašanje: kam gredo posnetki zaslona, vnosi, opisi napak, in promet aplikacije? Kdo jih obdeluje? Kako dolgo tam ostanejo?
Za ekipe, ki so pozorne na varnost, je samostojno gostovano izvajanje pogosto boljša arhitektura. Sistem, kot je COCO, lahko deluje znotraj lastne ali jasno omejene infrastrukture, izvaja testne korake, shranjuje dokaze, in ustvarja razumljive ocene. To ni obvezno v vsaki situaciji. Za javno marketinško stran s povsem sintetičnimi vrednostmi obrazcev je zunanja storitev lahko sprejemljiva. Pri notranjih strokovnih aplikacijah, portalih za stranke, ali programski opremi z osebnimi postopki pa je lokalni nadzor konkretna prednost.
Samostojno gostovanje ni brezplačna vozovnica. Delovanje zahteva posodobitve, koncepte varnostnega kopiranja, dnevnike dostopa, in odgovorno osebo. V zameno suverenost podatkov ostane tam, kamor spada. Pravi pristop je odvisen od potrebe po zaščiti, obstoječih operativnih zmogljivosti, in vrste testirane aplikacije - ne od trenutnega navdušenja nad določenim testnim orodjem.
Kako pravila postanejo delujoč proces
Praktičen proces ne sme blokirati izdaje. Začnite z zemljevidom podatkov: katera testna okolja obstajajo, katere vrste podatkov so tam, in kateri sistemi ustvarjajo dodatne artefakte? Ta popis običajno že razkrije stare izvoze, pozabljene staging sisteme, in nejasne odgovornosti.
Nato se izplača preprosta odločitvena matrika za vsak razred testa. Določa, ali zadostujejo sintetični podatki, ali je potrebno maskiranje, ali je potreben jasno utemeljen produkcijski izvleček. Dopolnjujejo jo lastniki, roki brisanja, in vloge dostopa. To ne sme biti preobremenjen nabor pravil. Kratko, dejansko upoštevano navodilo je boljše od varnostnega dokumenta, ki ga med motnjo nihče ne najde.
Tehnično spadata zagotavljanje podatkov in čiščenje v testni cevovod. Zagon ponovljivo ustvari potrebne nabore podatkov, uporablja edinstvene oznake, in jih nato ponovno odstrani. To preprečuje, da bi se testna okolja polnila z ostanki podatkov in da bi rezultati z vsakim sprintom postajali manj zanesljivi. Za kritične procese bi morale ekipe dodatno preveriti, ali je treba dostope do podatkov in testne dokaze beležiti na način, primeren za revizijo.
Varnost, ki pospeši testiranje
Secure test data management se pogosto obravnava kot dodatno kontrolno breme. Slabo izvedeno je to lahko res. Dobro izvedeno pa ustvarja zanesljive, ponovljive začetne pogoje. Ekipe izgubijo manj časa z iskanjem uporabnega izvoza podatkov, se izognejo pokvarjenim testom zaradi neočiščenih starih podatkov, in lahko bolje utemeljijo odobritve.
Najsmiselnejši prvi korak je redko velik platformski projekt. Vzemite testni proces z najvišjim tveganjem ali največjim trenjem - na primer odobritev notranje aplikacije za naročila - in tam naredite vidne vir podatkov, dostope, artefakte, in brisanje. Iz tega konkretnega dela nastane varnostna rutina, ki testov ne naredi bolj okornih, temveč bolj verodostojnih.