
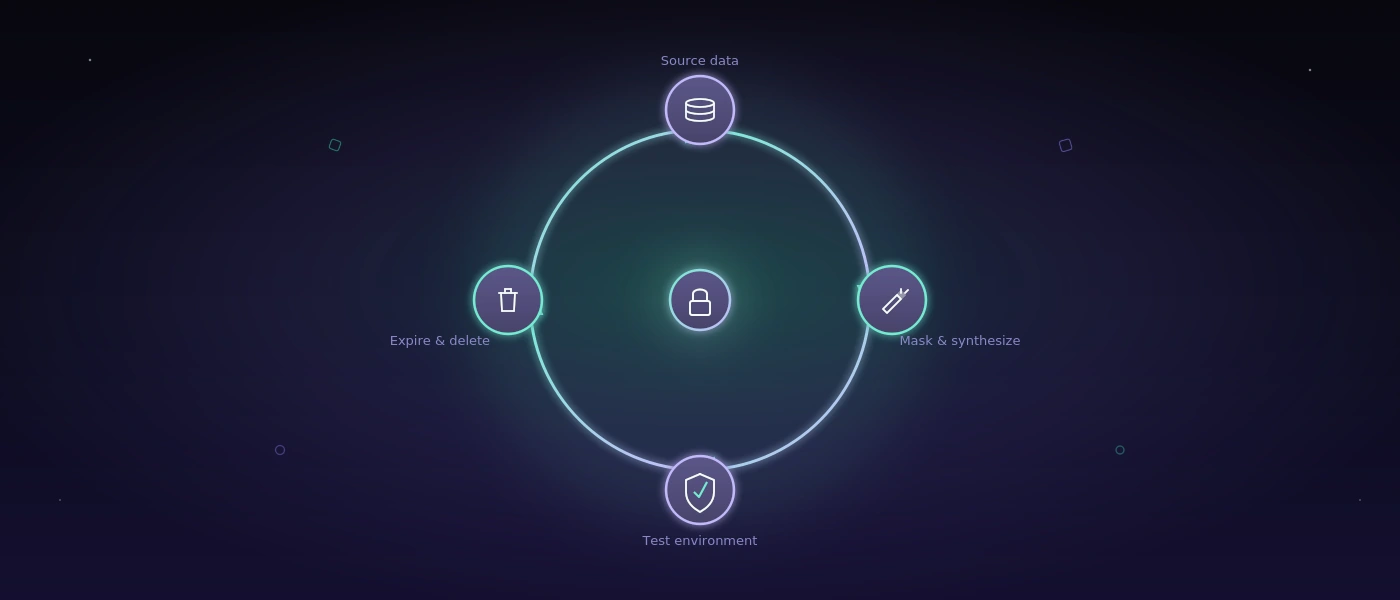
Secure test data management uten å miste kontrollen
En mislykket testkjøring er irriterende. En vellykket testkjøring med ekte kundedata i et utilstrekkelig beskyttet miljø kan vise seg å bli betydelig dyrere. Secure test data management løser ikke denne motsetningen med ett enkelt verktøy, men med tydelige regler for data, tilgang, testmiljøer, og bevis. For team som automatisert tester web- eller Windows-applikasjoner, hører dette derfor til kvalitetsarbeidet - ikke bare til etterlevelse.
Hvorfor testdata blir et sikkerhetsproblem
Produksjonsdata er forlokkende for tester fordi de inneholder reelle spesialtilfeller: ufullstendige adresser, uvanlige ordrekombinasjoner, historiske prisregler, eller feilaktige inndata. Men nettopp disse dataene inneholder ofte navn, kontaktopplysninger, kontraktsinformasjon, personalnumre, bankopplysninger, eller intern forretningslogikk.
Risikoen oppstår sjelden av én enkelt grov feil. Den vokser vanligvis trinnvis: en databaseeksport opprettes for en test, legges i en delt katalog, og kopieres senere til et annet miljø. En ekstern tjeneste mottar skjermbilder for feilanalyse. En testkonto beholder omfattende rettigheter fordi en opprydding kan forstyrre neste kjøring. Etter noen måneder vet ingen lenger pålitelig hvilke data som ligger hvor.
Hos små og mellomstore bedrifter forverres problemet ofte av knapp kapasitet. Teamet vil holde en utgivelsesfrist, ikke drive et eget personvernprosjekt. Ansvaret består likevel. Den som bruker data til kvalitetssikring må kunne spore hvilke data som behandles, hvem som har tilgang, og når de fjernes igjen.
Secure test data management begynner før testtilfellet
Det avgjørende spørsmålet er ikke: «Hvordan beskytter vi testdatabeholdningen?» Det er: «Hvilken informasjon trenger denne testen egentlig?» Mange regresjonstester trenger ingen reelle personreferanser i det hele tatt. En forsendelsesprosess må for eksempel kontrollere om leveringsadresser, vekter, soner, etiketter, og statusendringer behandles korrekt. Til det er syntetiske kunder, plausible artikkelstamdata, og bevisst definerte grensetilfeller nok.
Dette skillet fører til en praktisk dataklassifisering. Ikke alle testmiljøer trenger samme datadybde. For enhets- og integrasjonstester holder det ofte med helt kunstige datasett. For ende-til-ende-tester kan pseudonymiserte kopier være fornuftige, hvis reelle datamønstre er faglig relevante. Produksjonslignende data bør være unntaket - med dokumentert formål, begrenset tilgang, og en fast levetid.
Viktig her er kvaliteten på erstatningsdataene. Tilfeldige fantasidata hjelper lite hvis de ikke gjenspeiler realistiske avhengigheter. Et testdatasett for en lagerapplikasjon må for eksempel inneholde artikkelvarianter, lagerplasser, sperret beholdning, delleveranser, og returer i en samstemt kombinasjon. God testdata beskytter ikke bare personopplysninger. De finner feil som aldri ville blitt synlige med tomme tabeller og eksempelkunden «Ola Nordmann».
Syntetisere, maskere, eller minimere?
Syntetiske data er det tryggeste valget når de faglige reglene kan modelleres rent. De oppstår målrettet fra testkrav og inneholder ingen kopi av reelle personer eller transaksjoner. Innsatsen ligger i vedlikeholdet: endrer datamodellen seg eller kommer det nye prosessregler, må generatorer og fixtures vokse med.
Maskering egner seg når en applikasjons oppførsel er sterkt avhengig av produksjonsstrukturer. Da erstattes eller endres sensitive felt, mens relasjoner beholdes. Navn blir plausible, men fiktive navn; e-postadresser blir ikke-leverbare testadresser; kontonumre blir verdier med korrekt format uten reell tilknytning. En maskering er bare robust hvis også indirekte slutninger tas med i betraktningen. En kombinasjon av et sjeldent sted, fødselsdato, og kontraktsegenskap kan fortsatt gjøre en person identifiserbar.
Dataminimering er ofte den undervurderte tredje veien. I stedet for å kopiere en fullstendig eksport, tilbys bare det nødvendige utsnittet. Det reduserer angrepsflaten, lagringsbehovet, og opprydningsinnsatsen. For å teste en rabattlogikk trenger ingen hele et års kundehistorikk.
Tilgang og miljøer må matche risikoen
Et beskyttet datasett mister sin verdi hvis det ligger i et fritt tilgjengelig testmiljø. Testsystemer trenger derfor egne sikkerhetsgrenser - separate databaser, egne tjenestekontoer, klart definert nettverkstilgang, og ingen stilltiende forbindelse til produksjon.
Tilgangsrettigheter bør baseres på roller, ikke på delte kontoer. Utviklere kan trenge andre rettigheter enn QA, support, eller eksterne tjenesteleverandører. Administratortilgang er noen ganger nødvendig, men bør være tidsbegrenset, logget, og knyttet til en sporbar godkjenning. Også for testkontoer gjelder fornuftige passordregler, multifaktorautentisering der den er tilgjengelig, og kontosperreflyter ved gjentatte mislykkede forsøk.
Automatiserte tester bringer med seg enda et spesialtilfelle: de genererer bevis. Skjermbilder, skjermopptak, logger, og feilmeldinger kan inneholde sensitivt innhold, selv når databasen er maskert. Et skjermbilde av en kundeskjerm, et nettlesersport med øktinformasjon, eller en logg med API-nyttelast hører til samme beskyttelsesvurdering som testdatabasen.
Derfor trenger testartefakter oppbevaringsregler. Ikke hver vellykkede kjøring trenger å lagres permanent. For kritiske godkjenninger kan sporbart bevis være fornuftig, for eksempel med tidsstempel, byggnummer, testversjon, og resultat. Mislykkede kjøringer trenger ofte et lengre analysevindu. Etter det bør artefakter slettes automatisk. Det som ikke lenger finnes, kan ikke ved et uhell deles eller kompromitteres.
Automatisering uten ukontrollerte datalekkasjer
KI-støttet testautomatisering kan betydelig fremskynde tester, spesielt for omfattende web- og Windows-applikasjoner. Men det endrer sikkerhetsspørsmålet: hvor går skjermbilder, inndata, feilbeskrivelser, og applikasjonstrafikk? Hvem behandler dem? Hvor lenge blir de der?
For sikkerhetsbevisste team er selvhostet kjøring ofte den bedre arkitekturen. Et system som COCO kan kjøre innenfor egen eller en klart avgrenset infrastruktur, utføre teststeg, lagre bevis, og generere forståelige vurderinger. Det er ikke obligatorisk i alle situasjoner. For en offentlig markedsføringsside med rent syntetiske skjemaverdier kan en ekstern tjeneste være forsvarlig. Ved interne fagapplikasjoner, kundeportaler, eller programvare med personrelaterte prosesser er lokal kontroll imidlertid en konkret fordel.
Selvhosting er ikke et frikort. Driften krever oppdateringer, sikkerhetskopikonsepter, tilgangslogger, og en ansvarlig instans. Til gjengjeld forblir datasuvereniteten der den hører hjemme. Den riktige tilnærmingen avhenger av beskyttelsesbehov, eksisterende driftsevne, og typen testet applikasjon - ikke av det aktuelle hypet rundt et bestemt testverktøy.
Slik blir regler til en arbeidsdyktig prosess
En gjennomførbar prosess trenger ikke å blokkere utgivelsen. Begynn med et datakart: hvilke testmiljøer finnes, hvilke datatyper ligger der, og hvilke systemer genererer ytterligere artefakter? Denne kartleggingen avdekker som regel allerede gamle eksporter, glemte staging-systemer, og uklare ansvarsforhold.
Deretter lønner det seg med en enkel beslutningsmatrise per testklasse. Den fastsetter om syntetiske data er nok, en maskering er nødvendig, eller om et klart begrunnet produksjonsutdrag trengs. Den suppleres med eiere, slettefrister, og tilgangsroller. Det trenger ikke være et overbelastet regelverk. En kort, faktisk fulgt retningslinje er bedre enn et sikkerhetsdokument som ingen finner under en driftsforstyrrelse.
Teknisk hører dataklargjøring og opprydding hjemme i testpipelinen. En kjøring oppretter de datasettene den trenger reproduserbart, bruker unike merkinger, og fjerner dem deretter igjen. Det hindrer at testmiljøer fylles med restdata og resultater blir mindre pålitelige for hver sprint. For kritiske prosesser bør team dessuten sjekke om datatilgang og testbevis må logges på en revisjonssikker måte.
Sikkerhet som gjør testingen raskere
Secure test data management blir ofte betraktet som ekstra kontrollbyrde. Dårlig implementert kan det virkelig være det. Godt implementert skaper det imidlertid pålitelige, repeterbare utgangsforhold. Team kaster bort mindre tid på å lete etter en brukbar dataeksport, unngår ødelagte tester på grunn av uoppryddet gammel data, og kan bedre begrunne godkjenninger.
Det mest fornuftige første trinnet er sjelden et stort plattformprosjekt. Ta testprosessen med høyest risiko eller størst friksjon - for eksempel godkjenningen av en intern ordreapplikasjon - og gjør datakilde, tilgang, artefakter, og sletting synlige der. Fra dette konkrete arbeidet vokser det frem en sikkerhetsrutine som ikke gjør testene tyngre, men mer troverdige.