
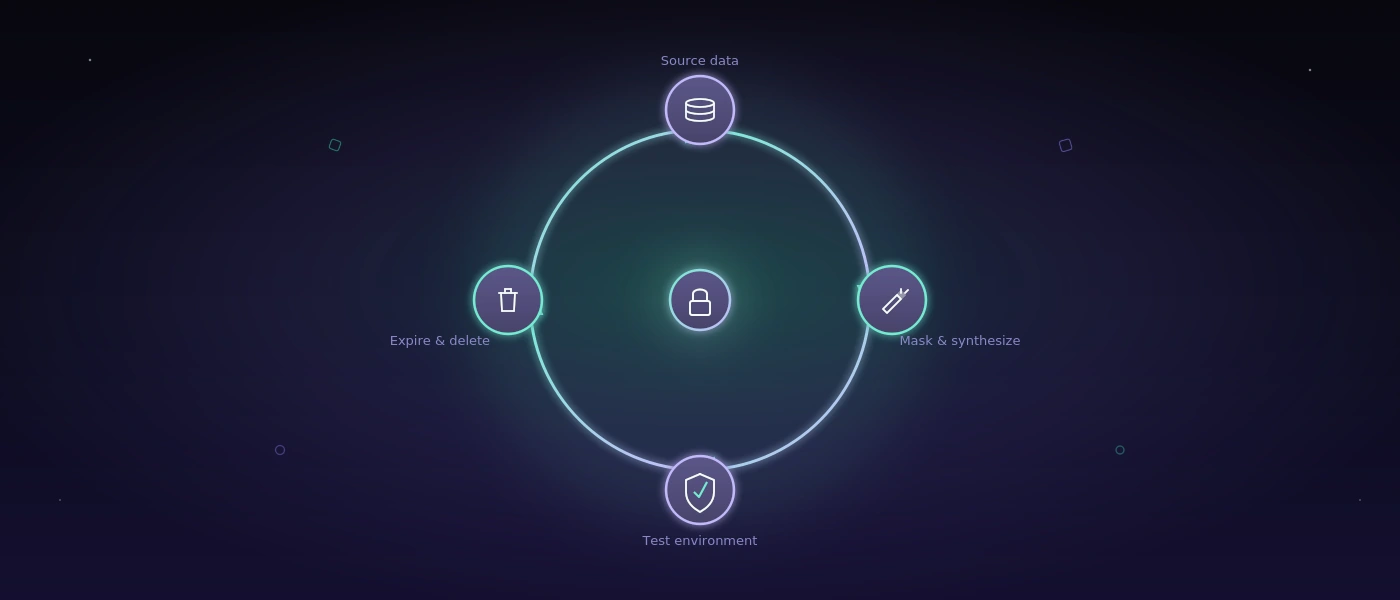
Secure test data management zonder controleverlies
Een mislukte testrun is vervelend. Een geslaagde testrun met echte klantgegevens in een onvoldoende beveiligde omgeving kan aanzienlijk duurder uitpakken. Secure test data management lost die tegenstelling niet op met één enkele tool, maar met duidelijke regels voor data, toegang, testomgevingen, en bewijsstukken. Voor teams die web- of Windows-toepassingen geautomatiseerd testen, hoort dit dus bij kwaliteitswerk - niet alleen bij compliance.
Waarom testdata een beveiligingsprobleem wordt
Productiedata is verleidelijk voor tests omdat het echte randgevallen bevat: onvolledige adressen, ongewone bestelcombinaties, historische prijsregels, of foutieve invoer. Maar juist die data bevat vaak namen, contactgegevens, contractinformatie, personeelsnummers, bankgegevens, of interne bedrijfslogica.
Het risico ontstaat zelden door één enkele grove fout. Meestal groeit het stapsgewijs: een databaseexport wordt aangemaakt voor een test, in een gedeelde map geplaatst, en later gekopieerd naar een andere omgeving. Een externe dienst ontvangt screenshots voor foutanalyse. Een testaccount behoudt uitgebreide rechten omdat opschoning de volgende run zou kunnen verstoren. Na een paar maanden weet niemand meer betrouwbaar welke data waar staat.
Bij kleine en middelgrote bedrijven verscherpt het probleem zich vaak door krappe capaciteit. Het team wil een releasedeadline halen, niet een eigen gegevensbeschermingsproject runnen. Toch blijft de verantwoordelijkheid bestaan. Wie data gebruikt voor kwaliteitsborging moet kunnen navolgen welke data worden verwerkt, wie er toegang toe heeft, en wanneer ze weer worden verwijderd.
Secure test data management begint vóór het testgeval
De beslissende vraag luidt niet: "Hoe beschermen we het testdatabestand?" Ze luidt: "Welke informatie heeft deze test werkelijk nodig?" Veel regressietests hebben geen echte persoonsverwijzingen nodig. Een verzendproces moet bijvoorbeeld controleren of afleveradressen, gewichten, zones, labels, en statuswijzigingen correct worden verwerkt. Daarvoor volstaan synthetische klanten, plausibele artikelstamdata, en bewust gedefinieerde randgevallen.
Dit onderscheid leidt tot een praktische dataclassificatie. Niet elke testomgeving heeft dezelfde datadiepte nodig. Voor unit- en integratietests volstaan vaak volledig kunstmatige datasets. Voor end-to-end-tests kunnen gepseudonimiseerde kopieën zinvol zijn, als reële datapatronen vakinhoudelijk relevant zijn. Productiegelijke data zou de uitzondering moeten zijn - met gedocumenteerd doel, beperkte toegang, en een vaste levensduur.
Belangrijk hierbij is de kwaliteit van de vervangende data. Willekeurige fantasiedata helpt weinig als het geen realistische afhankelijkheden weergeeft. Een testdataset voor een magazijntoepassing moet bijvoorbeeld artikelvarianten, magazijnlocaties, geblokkeerde voorraad, deelleveringen, en retouren in een kloppende combinatie bevatten. Goede testdata beschermt niet alleen persoonsgebonden informatie. Ze vindt fouten die met lege tabellen en de standaardklant "Jan Janssen" nooit zichtbaar zouden worden.
Synthetiseren, maskeren, of minimaliseren?
Synthetische data is de veiligste keuze wanneer de vakinhoudelijke regels zich netjes laten modelleren. Ze ontstaat gericht uit testvereisten en bevat geen kopie van reële personen of transacties. De inspanning zit in het onderhoud: verandert het datamodel of komen er nieuwe procesregels bij, dan moeten generators en fixtures meegroeien.
Maskeren is geschikt wanneer het gedrag van een toepassing sterk afhangt van productiestructuren. Daarbij worden gevoelige velden vervangen of gewijzigd, terwijl relaties behouden blijven. Van namen worden plausibele maar fictieve namen; van e-mailadressen worden onbestelbare testadressen; van rekeningnummers worden waarden met correct formaat zonder echte verwijzing. Een maskering is alleen betrouwbaar als ook indirecte conclusies worden meegewogen. Een combinatie van een zeldzame plaats, geboortedatum, en contractkenmerk kan een persoon nog steeds herkenbaar maken.
Dataminimalisatie is vaak de onderschatte derde weg. In plaats van een volledige export te kopiëren, wordt alleen het benodigde deel beschikbaar gesteld. Dat vermindert het aanvalsoppervlak, de opslagbehoefte, en de opschoningsinspanning. Voor een test van een kortingslogica heeft niemand de volledige klantgeschiedenis van een jaar nodig.
Toegang en omgevingen moeten bij het risico passen
Een beschermde dataset verliest zijn waarde als hij zich in een vrij bereikbare testomgeving bevindt. Testsystemen hebben daarom eigen beveiligingsgrenzen nodig - gescheiden databases, eigen serviceaccounts, duidelijk gedefinieerde netwerktoegang, en geen stilzwijgende verbinding met productie.
Toegangsrechten zouden op rollen moeten berusten, niet op gedeelde accounts. Ontwikkelaars hebben mogelijk andere rechten nodig dan QA, support, of externe dienstverleners. Beheerderstoegang is soms nodig, maar zou tijdelijk moeten zijn, gelogd, en gekoppeld aan een navolgbare goedkeuring. Ook voor testaccounts gelden zinvolle wachtwoordregels, multi-factor-authenticatie waar beschikbaar, en account-lockout-flows bij herhaalde mislukte pogingen.
Geautomatiseerde tests brengen nog een bijzonder geval met zich mee: ze genereren bewijs. Screenshots, schermopnamen, logs, en foutmeldingen kunnen gevoelige inhoud bevatten, zelfs als de database is gemaskeerd. Een screenshot van een klantscherm, een browsertrace met sessie-informatie, of een log met API-payload horen tot dezelfde beschermingsafweging als de testdatabase.
Daarom hebben testartefacten bewaarregels nodig. Niet elke geslaagde run hoeft permanent te worden opgeslagen. Voor kritieke goedkeuringen kan navolgbaar bewijs zinvol zijn, bijvoorbeeld met tijdstempel, buildnummer, testversie, en resultaat. Mislukte runs hebben vaak een langere analysetermijn nodig. Daarna zouden artefacten automatisch verwijderd moeten worden. Wat niet meer bestaat, kan niet per ongeluk worden gedeeld of gecompromitteerd.
Automatisering zonder ongecontroleerde datalekken
AI-ondersteunde testautomatisering kan tests aanzienlijk versnellen, vooral bij omvangrijke web- en Windows-toepassingen. Maar ze verandert de beveiligingsvraag: waar gaan screenshots, invoer, foutbeschrijvingen, en applicatieverkeer naartoe? Wie verwerkt ze? Hoe lang blijven ze daar?
Voor veiligheidsbewuste teams is self-hosted uitvoering vaak de betere architectuur. Een systeem als COCO kan binnen de eigen of een duidelijk afgebakende infrastructuur draaien, teststappen uitvoeren, bewijsstukken opslaan, en begrijpelijke beoordelingen genereren. Dat is niet in elke situatie noodzakelijk. Voor een publieke marketingpagina met puur synthetische formulierwaarden kan een externe dienst verdedigbaar zijn. Bij interne vakapplicaties, klantportalen, of software met persoonsgebonden processen is lokale controle echter een tastbaar voordeel.
Zelfhosting is geen vrijbrief. De exploitatie vereist updates, back-upconcepten, toegangslogs, en een verantwoordelijke instantie. Daar staat tegenover dat de datasoevereiniteit blijft waar ze hoort. De juiste aanpak hangt af van de beschermingsbehoefte, de aanwezige operationele capaciteiten, en het type geteste toepassing - niet van de actuele hype rond een bepaald testinstrument.
Zo worden regels een werkbaar proces
Een praktisch proces hoeft de release niet te blokkeren. Begin met een datalandkaart: welke testomgevingen zijn er, welke soorten data bevinden zich daar, en welke systemen genereren extra artefacten? Deze inventarisatie legt meestal al oude exports, vergeten staging-systemen, en onduidelijke verantwoordelijkheden bloot.
Daarna loont een eenvoudige beslissingsmatrix per testklasse. Ze bepaalt of synthetische data volstaat, een maskering vereist is, of een duidelijk onderbouwd productie-uittreksel nodig is. Ze wordt aangevuld met eigenaren, verwijderingstermijnen, en toegangsrollen. Dat hoeft geen overladen regelwerk te zijn. Een korte, daadwerkelijk gehanteerde richtlijn is beter dan een beveiligingsdocument dat niemand tijdens een storing terugvindt.
Technisch horen databeschikbaarstelling en opschoning thuis in de testpijplijn. Een run maakt zijn benodigde datasets reproduceerbaar aan, gebruikt unieke kenmerken, en verwijdert ze daarna weer. Dat voorkomt dat testomgevingen zich vullen met restdata en resultaten met elke sprint minder betrouwbaar worden. Voor kritieke processen zouden teams bovendien moeten nagaan of datatoegang en testbewijs auditklaar gelogd moeten worden.
Beveiliging die het testen sneller maakt
Secure test data management wordt vaak gezien als extra controle-inspanning. Slecht uitgevoerd kan dat ook zo zijn. Goed uitgevoerd schept het echter betrouwbare, herhaalbare uitgangscondities. Teams verspillen minder tijd aan het zoeken naar een bruikbare data-export, vermijden kapotte tests door niet-opgeschoonde oude data, en kunnen goedkeuringen beter onderbouwen.
De zinvolste eerste stap is zelden een groot platformproject. Neem het testproces met het hoogste risico of de grootste wrijving - bijvoorbeeld de vrijgave van een interne orderapplicatie - en maak daar databron, toegang, artefacten, en verwijdering zichtbaar. Uit dit concrete werk ontstaat een beveiligingsroutine die tests niet omslachtiger maakt, maar geloofwaardiger.