
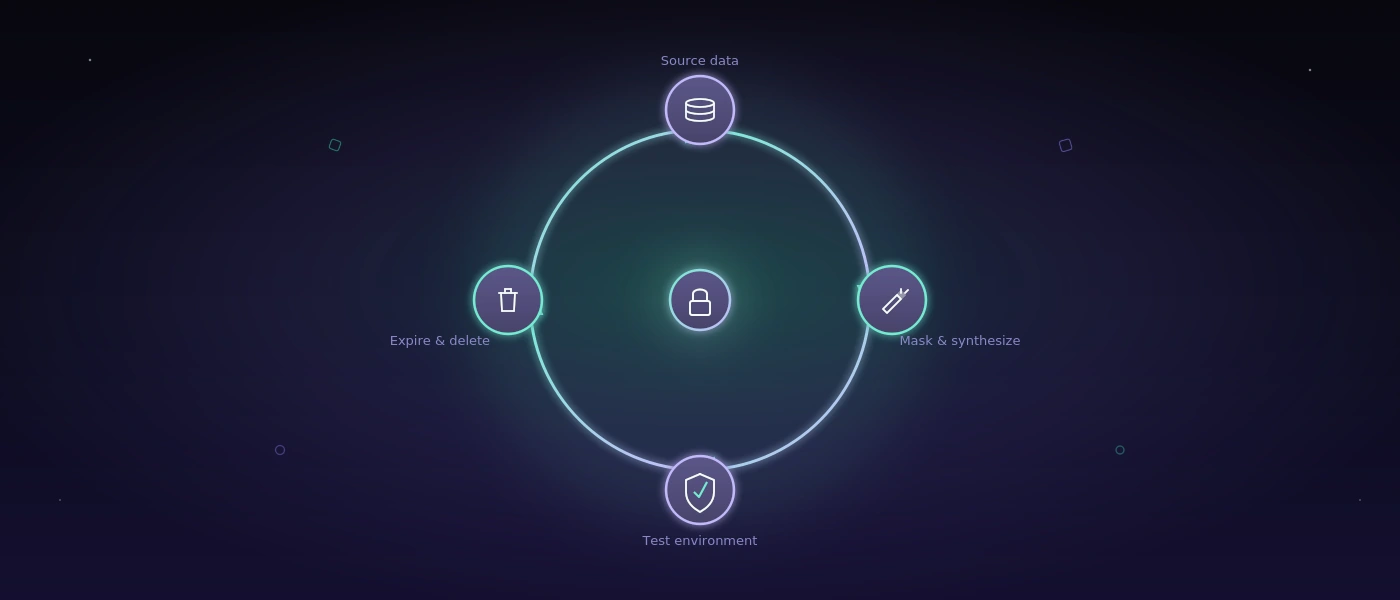
Secure test data management bez gubitka kontrole
Neuspješno testno izvođenje je iritantno. Uspješno testno izvođenje sa stvarnim podacima kupaca u nedovoljno zaštićenom okruženju može biti znatno skuplje. Secure test data management ne rješava tu proturječnost jednim alatom, već jasnim pravilima za podatke, pristupe, testna okruženja, i dokaze. Za timove koji automatizirano testiraju web ili Windows aplikacije, to je stoga dio rada na kvaliteti - ne samo usklađenosti.
Zašto testni podaci postaju sigurnosni problem
Produkcijski podaci su primamljivi za testove jer sadrže stvarne rubne slučajeve: nepotpune adrese, neobične kombinacije narudžbi, povijesna pravila cijena, ili pogrešne unose. No upravo ti podaci često sadrže imena, kontaktne podatke, ugovorne informacije, matične brojeve zaposlenika, bankovne podatke, ili internu poslovnu logiku.
Rizik rijetko nastaje zbog jedne velike pogreške. Obično raste postupno: izvoz baze podataka izrađuje se za test, odlaže u zajednički direktorij, i kasnije kopira u drugo okruženje. Vanjska usluga prima snimke zaslona za analizu grešaka. Testni račun zadržava široke ovlasti jer bi čišćenje moglo poremetiti sljedeće izvođenje. Nakon nekoliko mjeseci nitko više pouzdano ne zna koji se podaci gdje nalaze.
Kod malih i srednjih poduzeća problem se često pogoršava zbog ograničenih kapaciteta. Tim želi ispoštovati rok izdanja, a ne voditi vlastiti projekt zaštite podataka. Odgovornost ipak ostaje. Tko koristi podatke za osiguranje kvalitete mora moći pratiti koji se podaci obrađuju, tko ima pristup, i kada se ponovno uklanjaju.
Secure test data management počinje prije testnog slučaja
Odlučujuće pitanje nije: "Kako štitimo skup testnih podataka?" Ono glasi: "Koju informaciju taj test doista treba?" Mnogi regresijski testovi ne trebaju stvarne osobne podatke. Proces otpreme, primjerice, mora provjeriti obrađuju li se ispravno dostavne adrese, težine, zone, naljepnice, i promjene statusa. Za to su dovoljni sintetski kupci, vjerodostojni matični podaci artikala, i svjesno definirani rubni slučajevi.
Ta razlika vodi do praktične klasifikacije podataka. Ne treba svako testno okruženje istu dubinu podataka. Za jedinične i integracijske testove često su dovoljni potpuno umjetni skupovi podataka. Za end-to-end testove mogu biti smislene pseudonimizirane kopije, ako su stvarni obrasci podataka stručno relevantni. Podaci slični produkcijskima trebali bi biti iznimka - s dokumentiranom svrhom, ograničenim pristupom, i fiksnim vijekom trajanja.
Pritom je važna kvaliteta zamjenskih podataka. Nasumični izmišljeni podaci malo pomažu ako ne odražavaju realistične ovisnosti. Skup testnih podataka za skladišnu aplikaciju mora, primjerice, sadržavati varijante artikala, lokacije skladišta, blokirane zalihe, djelomične isporuke, i povrate u skladnoj kombinaciji. Dobri testni podaci ne štite samo osobne informacije. Oni pronalaze greške koje nikada ne bi bile vidljive s praznim tablicama i uzorkom kupca "Ivo Ivić".
Sintetizirati, maskirati, ili minimizirati?
Sintetski podaci su najsigurniji izbor kada se stručna pravila mogu čisto modelirati. Nastaju ciljano iz testnih zahtjeva i ne sadrže kopiju stvarnih osoba ili transakcija. Trud leži u održavanju: ako se promijeni model podataka ili se dodaju nova procesna pravila, generatori i fixtures moraju rasti zajedno s njima.
Maskiranje je prikladno kada ponašanje aplikacije uvelike ovisi o produkcijskim strukturama. Pritom se osjetljiva polja zamjenjuju ili mijenjaju, dok se odnosi zadržavaju. Od imena postaju vjerodostojna, ali izmišljena imena; od e-mail adresa postaju nedostupne testne adrese; od brojeva računa postaju vrijednosti ispravnog formata bez stvarne veze. Maskiranje je pouzdano samo ako se uzmu u obzir i neizravni zaključci. Kombinacija rijetkog mjesta, datuma rođenja, i ugovorne značajke i dalje može učiniti osobu prepoznatljivom.
Minimizacija podataka često je podcijenjen treći put. Umjesto kopiranja potpunog izvoza, pruža se samo potreban isječak. To smanjuje površinu napada, potrebe za pohranom, i trud čišćenja. Za test logike popusta nikome ne treba cijela godišnja povijest kupca.
Pristupi i okruženja moraju odgovarati riziku
Zaštićeni skup podataka gubi svoju vrijednost ako se nalazi u slobodno dostupnom testnom okruženju. Testni sustavi stoga trebaju vlastite sigurnosne granice - odvojene baze podataka, vlastite servisne račune, jasno definirane mrežne pristupe, i nikakvu tihu povezanost s produkcijom.
Prava pristupa trebala bi se temeljiti na ulogama, a ne na zajedničkim računima. Programeri možda trebaju drugačija prava od QA-a, podrške, ili vanjskih pružatelja usluga. Administratorski pristupi ponekad su potrebni, ali trebali bi biti vremenski ograničeni, zabilježeni, i povezani s dokazivim odobrenjem. I za testne račune vrijede smislena pravila lozinki, višefaktorska autentifikacija gdje je dostupna, i tijekovi blokiranja računa kod ponovljenih neuspjelih pokušaja.
Automatizirani testovi donose još jedan poseban slučaj: stvaraju dokaze. Snimke zaslona, snimanja zaslona, zapisnici, i poruke o pogreškama mogu sadržavati osjetljiv sadržaj, čak i kad je baza podataka maskirana. Snimka zaslona kupčeve maske, tragovi preglednika s informacijama o sesiji, ili zapisnik s API payloadom pripadaju istoj razini zaštite kao i testna baza podataka.
Zato testni artefakti trebaju pravila zadržavanja. Ne treba svako uspješno izvođenje trajno pohranjivati. Za kritična odobrenja može biti smislen sljedivi dokaz, primjerice s vremenskom oznakom, brojem builda, verzijom testa, i rezultatom. Neuspjela izvođenja često trebaju dulje razdoblje analize. Nakon toga artefakti bi se trebali automatski brisati. Ono što više ne postoji ne može se nehotice podijeliti ili kompromitirati.
Automatizacija bez nekontroliranog curenja podataka
AI potpomognuta automatizacija testiranja može znatno ubrzati testove, posebno kod opsežnih web i Windows aplikacija. No ona mijenja sigurnosno pitanje: kamo idu snimke zaslona, unosi, opisi pogrešaka, i aplikacijski promet? Tko ih obrađuje? Koliko dugo ondje ostaju?
Za timove svjesne sigurnosti, samostalno hostirano izvođenje često je bolja arhitektura. Sustav poput COCOa može raditi unutar vlastite ili jasno omeđene infrastrukture, izvršavati testne korake, pohranjivati dokaze, i stvarati razumljive procjene. To nije obavezno u svakoj situaciji. Za javnu marketinšku stranicu s čisto sintetskim vrijednostima obrazaca, vanjska usluga može biti opravdana. Kod internih stručnih aplikacija, kupčevih portala, ili softvera s osobnim procesima, lokalna kontrola ipak je opipljiva prednost.
Samostalno hostiranje nije slobodan prolaz. Rad zahtijeva ažuriranja, koncepte sigurnosnih kopija, zapisnike pristupa, i odgovornu osobu. Zauzvrat, suverenitet podataka ostaje tamo gdje pripada. Ispravan pristup ovisi o potrebi za zaštitom, postojećim operativnim sposobnostima, i vrsti testirane aplikacije - ne o trenutnom hype-u oko određenog testnog alata.
Kako pravila postaju funkcionalan proces
Praktičan proces ne mora blokirati izdanje. Počnite s kartom podataka: koja testna okruženja postoje, koje se vrste podataka ondje nalaze, i koji sustavi stvaraju dodatne artefakte? Taj popis obično već otkriva stare izvoze, zaboravljene staging sustave, i nejasne odgovornosti.
Nakon toga isplati se jednostavna matrica odlučivanja po klasi testa. Ona određuje jesu li sintetski podaci dovoljni, je li potrebno maskiranje, ili je potreban jasno obrazložen produkcijski izvod. Nadopunjuje se vlasnicima, rokovima brisanja, i ulogama pristupa. To ne mora biti prenatrpani skup pravila. Kratka, stvarno provođena smjernica bolja je od sigurnosnog dokumenta koji nitko ne pronalazi tijekom kvara.
Tehnički, opskrba podacima i čišćenje pripadaju testnom pipelineu. Izvođenje reproducibilno stvara potrebne skupove podataka, koristi jedinstvene oznake, i potom ih ponovno uklanja. To sprječava da se testna okruženja pune preostalim podacima i da rezultati postaju sve manje pouzdani sa svakim sprintom. Za kritične procese, timovi bi trebali dodatno provjeriti moraju li pristupi podacima i testni dokazi biti bilježeni na revizijski način.
Sigurnost koja ubrzava testiranje
Secure test data management često se smatra dodatnim kontrolnim opterećenjem. Loše provedeno, to doista može biti. Dobro provedeno, međutim, stvara pouzdane, ponovljive polazne uvjete. Timovi manje vremena troše tražeći upotrebljiv izvoz podataka, izbjegavaju pokvarene testove zbog neočišćenih starih podataka, i mogu bolje obrazložiti odobrenja.
Najsmisleniji prvi korak rijetko je velik platformski projekt. Uzmite testni proces s najvišim rizikom ili najvećim trenjem - primjerice odobrenje interne aplikacije za narudžbe - i ondje učinite vidljivim izvor podataka, pristupe, artefakte, i brisanje. Iz tog konkretnog rada nastaje sigurnosna rutina koja testove ne čini glomaznijima, već vjerodostojnijima.