
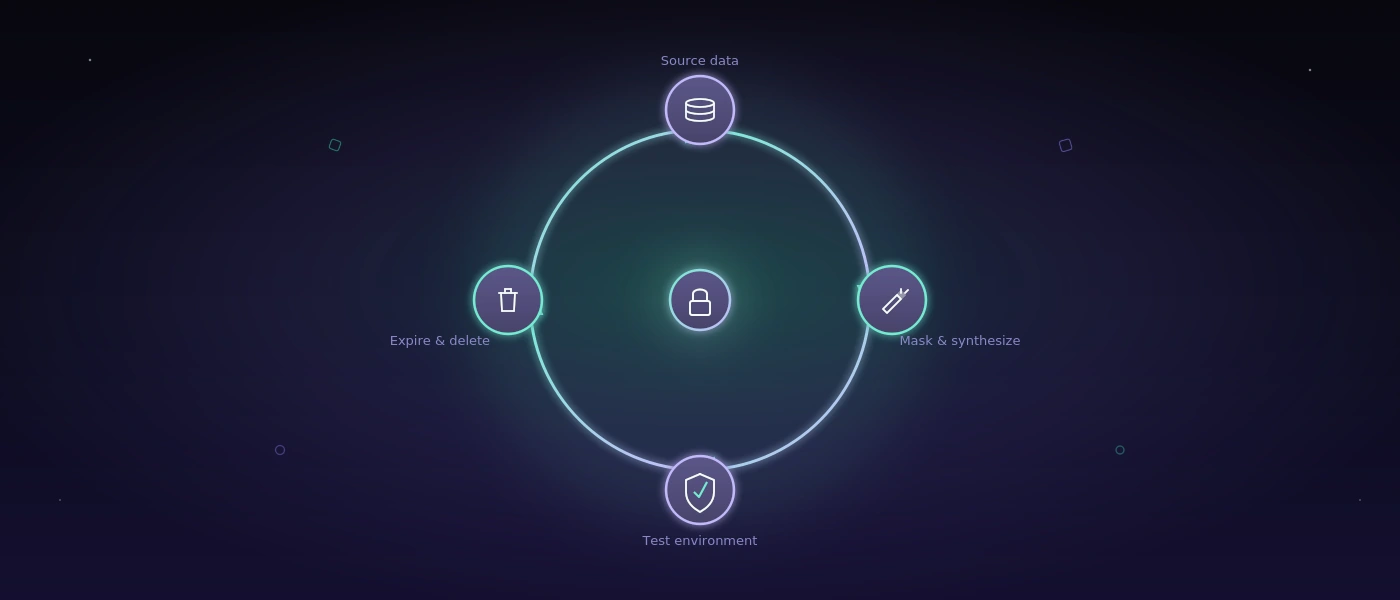
Secure test data management sans perdre le contrôle
Une exécution de test échouée est agaçante. Une exécution de test réussie avec de vraies données clients dans un environnement insuffisamment protégé peut s'avérer nettement plus coûteuse. Le secure test data management ne résout pas cette contradiction avec un seul outil, mais avec des règles claires pour les données, les accès, les environnements de test, et les preuves. Pour les équipes qui testent de manière automatisée des applications web ou Windows, cela fait donc partie du travail de qualité - pas seulement de la conformité.
Pourquoi les données de test deviennent un problème de sécurité
Les données de production sont séduisantes pour les tests car elles contiennent des cas limites réels : adresses incomplètes, combinaisons de commandes inhabituelles, règles de prix historiques, ou saisies erronées. Mais ces mêmes données contiennent souvent des noms, des coordonnées, des informations contractuelles, des numéros de personnel, des données bancaires, ou de la logique métier interne.
Le risque naît rarement d'une seule erreur flagrante. Il grandit généralement étape par étape : un export de base de données est créé pour un test, déposé dans un répertoire partagé, puis copié plus tard dans un autre environnement. Un service externe reçoit des captures d'écran pour l'analyse des erreurs. Un compte de test conserve des droits étendus parce qu'un nettoyage pourrait perturber la prochaine exécution. Après quelques mois, plus personne ne sait de manière fiable quelles données se trouvent où.
Dans les petites et moyennes entreprises, le problème s'aggrave souvent à cause de capacités limitées. L'équipe veut tenir un délai de mise en production, pas gérer son propre projet de protection des données. La responsabilité demeure malgré tout. Quiconque utilise des données pour l'assurance qualité doit pouvoir retracer quelles données sont traitées, qui y a accès, et quand elles sont à nouveau supprimées.
Le secure test data management commence avant le cas de test
La question décisive n'est pas : « Comment protégeons-nous le jeu de données de test ? » C'est : « De quelle information ce test a-t-il vraiment besoin ? » De nombreux tests de régression ne nécessitent aucune référence personnelle réelle. Un processus d'expédition, par exemple, doit vérifier si les adresses de livraison, les poids, les zones, les étiquettes, et les changements de statut sont traités correctement. Des clients synthétiques, des données de référence articles plausibles, et des cas limites définis délibérément suffisent pour cela.
Cette distinction mène à une classification des données praticable. Chaque environnement de test n'a pas besoin de la même profondeur de données. Pour les tests unitaires et d'intégration, des jeux de données entièrement artificiels suffisent souvent. Pour les tests de bout en bout, des copies pseudonymisées peuvent avoir du sens si des motifs de données réels sont pertinents sur le plan métier. Les données proches de la production devraient être l'exception - avec un objectif documenté, un accès limité, et une durée de vie fixe.
La qualité des données de substitution est importante ici. Des données fantaisistes aléatoires aident peu si elles ne reflètent pas des dépendances réalistes. Un jeu de données de test pour une application d'entrepôt doit, par exemple, contenir des variantes d'articles, des emplacements de stockage, des stocks bloqués, des livraisons partielles, et des retours dans une combinaison cohérente. De bonnes données de test ne protègent pas seulement les informations personnelles. Elles trouvent des bugs qui ne se manifesteraient jamais avec des tables vides et le client type « Jean Dupont ».
Synthétiser, masquer, ou minimiser ?
Les données synthétiques sont le choix le plus sûr lorsque les règles métier peuvent être modélisées proprement. Elles naissent spécifiquement des exigences de test et ne contiennent aucune copie de personnes ou d'opérations réelles. L'effort réside dans la maintenance : si le modèle de données change ou que de nouvelles règles de processus s'ajoutent, générateurs et fixtures doivent évoluer en conséquence.
Le masquage convient lorsque le comportement d'une application dépend fortement des structures de production. Les champs sensibles y sont remplacés ou modifiés, tandis que les relations sont préservées. Les noms deviennent des noms plausibles mais fictifs ; les adresses e-mail deviennent des adresses de test non distribuables ; les numéros de compte deviennent des valeurs au format correct sans lien réel. Un masquage n'est solide que si les déductions indirectes sont également prises en compte. Une combinaison d'un lieu rare, d'une date de naissance, et d'une caractéristique contractuelle peut encore rendre une personne identifiable.
La minimisation des données est souvent la troisième voie sous-estimée. Au lieu de copier un export complet, seule la portion nécessaire est fournie. Cela réduit la surface d'attaque, les besoins de stockage, et l'effort de nettoyage. Pour tester une logique de remise, personne n'a besoin de tout l'historique client d'une année.
Les accès et environnements doivent correspondre au risque
Un jeu de données protégé perd sa valeur s'il se trouve dans un environnement de test librement accessible. Les systèmes de test ont donc besoin de leurs propres frontières de sécurité - bases de données séparées, comptes de service dédiés, accès réseau clairement définis, et aucune connexion silencieuse à la production.
Les droits d'accès devraient reposer sur des rôles, pas sur des comptes partagés. Les développeurs peuvent avoir besoin de droits différents de ceux de l'AQ, du support, ou des prestataires externes. Les accès administrateur sont parfois nécessaires, mais ils devraient être limités dans le temps, journalisés, et liés à une approbation traçable. Des règles de mot de passe sensées, une authentification multifacteur là où elle est disponible, et des flux de blocage de compte en cas de tentatives échouées répétées s'appliquent aussi aux comptes de test.
Les tests automatisés apportent un autre cas particulier : ils génèrent des preuves. Captures d'écran, enregistrements d'écran, journaux, et messages d'erreur peuvent contenir un contenu sensible, même lorsque la base de données a été masquée. Une capture d'écran d'un masque client, une trace navigateur avec des informations de session, ou un journal avec une charge utile d'API relèvent de la même considération de protection que la base de données de test.
C'est pourquoi les artefacts de test ont besoin de règles de conservation. Chaque exécution réussie n'a pas besoin d'être stockée durablement. Pour les validations critiques, une preuve traçable peut avoir du sens, par exemple avec un horodatage, un numéro de build, une version de test, et un résultat. Les exécutions échouées nécessitent souvent une fenêtre d'analyse plus longue. Après quoi, les artefacts devraient être supprimés automatiquement. Ce qui n'existe plus ne peut pas être partagé ou compromis par accident.
Automatisation sans fuites de données incontrôlées
L'automatisation des tests assistée par IA peut accélérer considérablement les tests, en particulier pour des applications web et Windows étendues. Mais elle change la question de sécurité : où vont les captures d'écran, les saisies, les descriptions d'erreurs, et le trafic applicatif ? Qui les traite ? Combien de temps y restent-ils ?
Pour les équipes soucieuses de sécurité, l'exécution auto-hébergée est souvent la meilleure architecture. Un système comme COCO peut fonctionner au sein de sa propre infrastructure, ou d'une infrastructure clairement délimitée, exécutant les étapes de test, stockant les preuves, et générant des évaluations compréhensibles. Ce n'est pas obligatoire dans toutes les situations. Pour une page marketing publique avec des valeurs de formulaire purement synthétiques, un service externe peut être acceptable. Pour des applications métier internes, des portails clients, ou des logiciels traitant des opérations personnelles, en revanche, le contrôle local est un avantage concret.
L'auto-hébergement n'est pas un passe-droit. L'exploitation exige des mises à jour, des concepts de sauvegarde, des journaux d'accès, et une entité responsable. En contrepartie, la souveraineté des données reste là où elle doit être. La bonne approche dépend du besoin de protection, des capacités opérationnelles existantes, et du type d'application testée - pas de l'engouement actuel pour un outil de test particulier.
Comment les règles deviennent un processus opérationnel
Un processus praticable n'a pas besoin de bloquer la mise en production. Commencez par une carte des données : quels environnements de test existent, quels types de données s'y trouvent, et quels systèmes génèrent des artefacts supplémentaires ? Cet inventaire révèle généralement déjà d'anciens exports, des systèmes de staging oubliés, et des responsabilités peu claires.
Ensuite, une simple matrice de décision par classe de test se révèle payante. Elle détermine si des données synthétiques suffisent, si un masquage est requis, ou si un extrait de production clairement justifié est nécessaire. Elle est complétée par des propriétaires, des délais de suppression, et des rôles d'accès. Cela n'a pas besoin d'être un corpus de règles surchargé. Une consigne courte et réellement suivie vaut mieux qu'un document de sécurité que personne ne trouve pendant un incident.
Techniquement, la mise à disposition et le nettoyage des données relèvent du pipeline de test. Une exécution crée les jeux de données dont elle a besoin de manière reproductible, utilise des marqueurs uniques, et les supprime ensuite à nouveau. Cela empêche les environnements de test de se remplir de données résiduelles et les résultats de devenir moins fiables à chaque sprint. Pour les processus critiques, les équipes devraient en outre vérifier si les accès aux données et les preuves de test doivent être journalisés de manière auditable.
Une sécurité qui accélère les tests
Le secure test data management est souvent considéré comme une charge de contrôle supplémentaire. Mal mis en œuvre, il peut effectivement l'être. Bien mis en œuvre, en revanche, il crée des conditions de départ fiables et reproductibles. Les équipes perdent moins de temps à chercher un export de données utilisable, évitent les tests cassés à cause de données résiduelles non nettoyées, et peuvent mieux justifier les validations.
La première étape la plus sensée est rarement un grand projet de plateforme. Prenez le processus de test présentant le risque le plus élevé ou la plus grande friction - par exemple la validation d'une application de commandes interne - et rendez-y visibles la source des données, les accès, les artefacts, et la suppression. De ce travail concret naît une routine de sécurité qui ne rend pas les tests plus lourds, mais plus crédibles.