
Inventory Management im Lager
Ein fehlendes Teil fällt selten beim Zählen im Lager auf. Meist zeigt es sich erst, wenn ein Auftrag nicht gepackt werden kann, ein Monteur vor dem leeren Regal steht oder der Einkauf per Telefon nach einer Lieferzusage sucht. Gutes Inventory Management verhindert diese Überraschungen nicht mit mehr Tabellen, sondern mit einem verlässlichen Bild davon, was vorhanden ist, wo es liegt und was als Nächstes damit passiert.
Für kleine und mittlere Unternehmen ist das keine Frage eines möglichst großen ERP-Systems. Entscheidend ist, ob die Mitarbeitenden im Wareneingang, Lager und Versand mit wenigen klaren Schritten arbeiten können - auch unter Zeitdruck, über Schichtwechsel hinweg und dann, wenn eine Lieferung anders ausfällt als geplant.
Inventory Management beginnt mit Bewegungen, nicht mit Bestandslisten
Eine Bestandsliste ist eine Momentaufnahme. Sie kann korrekt sein und dennoch wenig helfen, wenn niemand nachvollziehen kann, warum sich eine Menge verändert hat. Ein belastbares System behandelt Bestände deshalb als Folge dokumentierter Bewegungen: Ware kommt an, wird geprüft, eingelagert, reserviert, kommissioniert, umgelagert, versendet oder korrigiert.
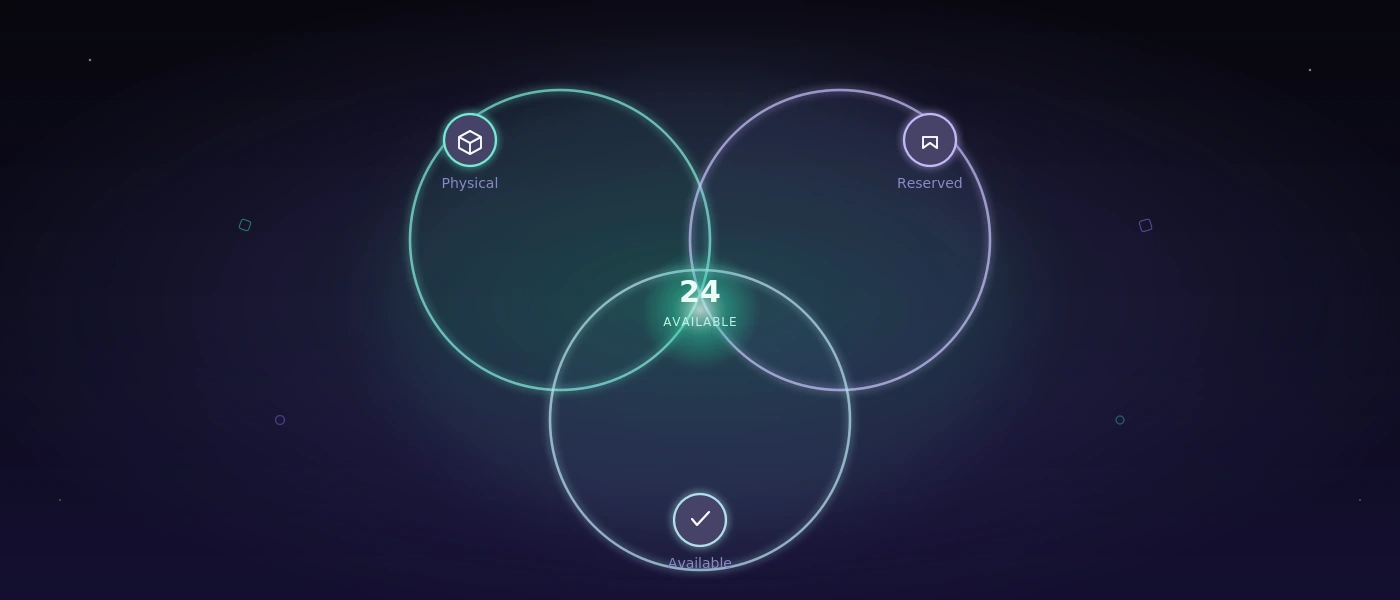
Jede Bewegung braucht einen eindeutigen Anlass, einen Zeitpunkt, eine verantwortliche Person und möglichst einen Bezug zu einem Vorgang. Das kann eine Bestellung, ein Kundenauftrag, ein Lieferschein oder ein Fertigungsauftrag sein. Damit wird aus der Zahl „24 Stück verfügbar" eine prüfbare Aussage: 30 Stück wurden eingebucht, vier sind für zwei Aufträge reserviert, und keine offene Umlagerung verfälscht den verfügbaren Bestand.
Diese Unterscheidung ist gerade bei knappen Teilen relevant. Physisch vorhanden, reserviert und frei verfügbar sind drei unterschiedliche Zustände. Werden sie vermischt, verspricht der Vertrieb Ware, die das Lager bereits für einen anderen Auftrag benötigt. Werden sie sauber geführt, kann ein Team früh entscheiden: nachbestellen, umpriorisieren oder dem Kunden realistisch Auskunft geben.
Wo manuelle Prozesse typischerweise brechen
Spreadsheets sind nicht grundsätzlich falsch. Für ein kleines Sortiment, einen Lagerort und wenige Bewegungen pro Woche können sie wirtschaftlicher sein als eine eigene Anwendung. Problematisch werden sie, sobald mehrere Personen gleichzeitig arbeiten oder Bestände aus mehreren Quellen aktualisiert werden.
Dann entstehen die bekannten Lücken: Der Wareneingang liegt als Papier auf dem Schreibtisch, die Excel-Datei wurde lokal geändert, eine Umlagerung wurde nur mündlich abgesprochen, und der Versand bucht erst nach Feierabend. Der Bestand ist nicht unbedingt falsch, aber er ist zeitlich versetzt und seine Herkunft unklar. Genau das macht ihn für operative Entscheidungen ungeeignet.
Auch die Organisationsstruktur spielt eine Rolle. Ein zentraler Standort braucht andere Abläufe als ein Betrieb mit Außenlagern, Servicefahrzeugen oder einer Produktion, die Material entnimmt. Wer diese Unterschiede mit einer einzigen Freitextspalte abbildet, verlagert die Logik in die Köpfe einzelner Mitarbeitender. Das funktioniert, bis diese Person Urlaub hat oder das Auftragsvolumen steigt.
Den Prozess vor der Software festlegen
Ein sinnvolles Projekt beginnt nicht mit der Frage, welcher Scanner gekauft wird oder welche Oberfläche modern aussieht. Zuerst muss klar sein, welche Entscheidungen das System unterstützen soll. Dafür reichen oft konkrete Beobachtungen aus dem Alltag: Wie wird Ware heute angenommen? Wann gilt sie als geprüft? Wer darf Bestände korrigieren? Was passiert bei beschädigter Ware? Und an welchem Punkt wird ein Auftrag verbindlich reserviert?
Aus diesen Antworten entstehen wenige, verbindliche Regeln. Beispielsweise darf Wareneingang erst nach einer Mengenprüfung eingebucht werden. Artikel ohne Lagerplatz dürfen nicht als einlagerbar erscheinen. Bestandskorrekturen erfordern einen Grundcode und bleiben in der Historie sichtbar. Versandte Ware wird nicht stillschweigend gelöscht, sondern über eine dokumentierte Ausbuchung dem Auftrag zugeordnet.
Das ist weniger spektakulär als eine große Digitalisierungsfolie, aber im Betrieb wesentlich wertvoller. Wenn die Regeln eindeutig sind, kann Software sie zuverlässig prüfen. Wenn sie unklar bleiben, beschleunigt jede neue Anwendung nur widersprüchliche Arbeitsschritte.
Stammdaten: klein anfangen, konsequent pflegen
Nicht jeder Artikel braucht zu Beginn zehn Klassifikationen. Eine brauchbare Grundlage besteht häufig aus Artikelnummer, Bezeichnung, Einheit, aktivem Lagerstatus und einem oder mehreren Lagerplätzen. Je nach Geschäft kommen Chargen, Seriennummern, Mindestbestände, Lieferantenartikelnummern oder Ablaufdaten hinzu.
Wichtig ist die Konsequenz, nicht die Menge der Felder. Zwei Artikelnummern für denselben physischen Artikel oder wechselnde Einheiten wie „Karton", „Packung" und „Stück" ohne Umrechnungsregel erzeugen spätere Fehler fast automatisch. Ein System kann solche Eingaben technisch erlauben. Es sollte sie dort begrenzen, wo sie den Ablauf gefährden.
Welche Funktionen im Lager wirklich helfen
Für viele mittelständische Lager ist ein klarer Kern wertvoller als ein überladener Funktionskatalog. Dieser Kern umfasst in der Regel vier Bereiche:
- Wareneingang mit Bestellbezug, Mengenprüfung und Einlagerung
- Lagerbewegungen zwischen definierten Plätzen und Bereichen
- Auftragsreservierung, Kommissionierung und Versandbuchung
- Inventur und Bestandskorrekturen mit nachvollziehbarer Historie
Ergänzend können Etikettendruck, Barcode-Scanning, Lieferscheine, Versandlabels oder eine Übergabe an Buchhaltung und Shop-Systeme viel Zeit sparen. Aber sie sollten auf einem sauberen Bewegungsmodell aufbauen. Ein schneller Etikettendruck bringt wenig, wenn der Artikel beim Scannen nicht eindeutig dem richtigen Lagerplatz oder Auftrag zugeordnet wird.
Bei der Bedienung zählt zudem die Umgebung. Ein Mitarbeitender mit Handschuhen am Wareneingang benötigt große, eindeutige Aktionen und möglichst wenig Texteingabe. Eine Disponentin am Arbeitsplatz braucht dagegen Filter, Suchfunktionen und eine Sicht auf offene Vorgänge. Beide Rollen dürfen dieselben Daten verwenden, aber sie brauchen nicht dieselbe Oberfläche.
Echtzeit heißt nicht: jede Zahl ist unkritisch
Viele Unternehmen wünschen sich Echtzeitbestände. Das ist sinnvoll, doch der Begriff wird oft zu grob verwendet. Ein Bestand kann unmittelbar nach jedem Scan aktualisiert werden und trotzdem falsch sein, wenn ein Prozess unvollständig bleibt. Wird Ware zwar gescannt, aber nicht geprüft, ist die Zahl technisch aktuell und operativ fragwürdig.
Deshalb braucht jedes System einen Umgang mit Ausnahmen. Differenzen im Wareneingang, beschädigte Verpackungen, Rücksendungen und nicht auffindbare Artikel sind keine Randfälle. Sie gehören zum Alltag. Gute Prozesse markieren sie sichtbar, statt Mitarbeitende zu improvisierten Nebenlisten zu zwingen.
Auch die Berechtigungen verdienen Aufmerksamkeit. Nicht jede Person sollte Artikelstammdaten ändern oder historische Buchungen korrigieren können. Ein praxistaugliches Rechtekonzept trennt Routinevorgänge von Eingriffen mit höherem Risiko. Das schützt nicht nur vor Fehlern, sondern erleichtert die Ursachenanalyse, wenn ein Bestand unerwartet abweicht.
Integration nur dort, wo sie den Ablauf verbessert
Inventory Management steht selten allein. Aufträge kommen möglicherweise aus einem Webshop, einer E-Mail-Erfassung, einer Branchenlösung oder direkt vom Vertrieb. Versanddienstleister benötigen Adressdaten und Gewichte. Die Buchhaltung erwartet Belege in einer bestimmten Form.
Eine Integration lohnt sich, wenn sie doppelte Erfassung beseitigt oder Fehlerquellen reduziert. Sie ist nicht automatisch sinnvoll, nur weil eine Schnittstelle verfügbar ist. Gerade bei gewachsenen Abläufen kann ein klarer Import mit Prüfung verlässlicher sein als eine dauerhafte Echtzeitkopplung, die unbemerkt fehlerhafte Daten überträgt.
Technisch sollte die Lösung nachvollziehbar bleiben: eindeutige Schnittstellen, protokollierte Übertragungen, verständliche Fehlermeldungen und eine Datenbankstruktur, die Änderungen nicht versteckt. Mit einer gepflegten Anwendung auf Basis von PHP 8.4 und MySQL 8 lassen sich solche Prozesse schlank umsetzen, ohne Teams in ein globales Konzernsystem zu zwingen. Entscheidend ist nicht der Technologiebegriff, sondern ob Wartung, Erweiterungen und Datenkorrekturen auch in drei Jahren noch kontrollierbar sind.
Einführung in kleinen, messbaren Schritten
Ein Big Bang ist im Lager selten die beste Wahl. Sicherer ist ein begrenzter Start, etwa mit Wareneingang und einem ausgewählten Lagerbereich. In dieser Phase lassen sich Scanzeiten, Fehlerarten, offene Sonderfälle und die Qualität der Stammdaten beobachten. Erst danach folgen Reservierung, Versand oder weitere Standorte.
Parallelbetrieb kann dabei sinnvoll sein, aber nur mit einem klaren Ende. Zwei führende Bestände über längere Zeit schaffen genau das Problem, das die neue Lösung beheben soll. Besser ist eine festgelegte Umstellung mit Inventur, bereinigten Stammdaten und Verantwortlichkeiten für die ersten Wochen.
Der Erfolg zeigt sich nicht daran, wie viele Funktionen aktiviert wurden. Er zeigt sich daran, ob weniger Rückfragen entstehen, ob Aufträge vollständiger gepackt werden und ob ein Team ohne detektivische Suche erklären kann, warum ein Artikelbestand so aussieht, wie er aussieht.
Wenn der aktuelle Prozess mit einer gut gepflegten Tabelle tatsächlich stabil funktioniert, sollte er bleiben dürfen. Wenn aber Informationen zwischen Papier, Telefonaten und mehreren Dateien verloren gehen, ist der nächste sinnvolle Schritt kein größeres Werkzeug, sondern ein klarer Ablauf, der jede wichtige Lagerbewegung sichtbar macht.