softify.pro
Cargando …
Servicios Nosotros COCO – nuestro servidor de IA Portafolio Insiders Casos de éxito Curiosidades Contacto Acceso

NEXT-GEN SOFTWARE AESTHETIC

Pure fluidity meets ultimate performance.

La nueva identidad visual para los flujos de trabajo digitales modernos.

softify.pro — La nueva identidad visual para los flujos de trabajo digitales modernos.

Desplázate para explorar ↓

Software construido como realmente trabajan las empresas modernas

softify.pro es un estudio de software construido en torno a una idea: la tecnología debería moverse con la misma fluidez que las empresas a las que da soporte. Trabajamos en la intersección del desarrollo web moderno, la automatización de procesos y la inteligencia artificial aplicada — tres disciplinas que rara vez conviven bajo un mismo techo, pero que cada vez más lo necesitan. Nuestros clientes van desde pequeños talleres que digitalizan su primera facturación hasta fabricantes medianos consolidados que sustituyen hojas de cálculo por software logístico real. Lo que los conecta no es el tamaño, sino la ambición: quieren sistemas rápidos, fiables y realmente agradables de usar, no solo funcionales. Cada proyecto comienza con las mismas tres preguntas: qué necesita esta empresa acelerar de verdad, qué ya funciona bien y debe respetarse en lugar de sustituirse, y qué parte del flujo de trabajo puede, una vez construida correctamente, funcionar por sí sola. Las respuestas determinan todo lo que sigue, desde la tecnología elegida hasta el plan de implementación.

Servicios

La nueva identidad visual para los flujos de trabajo digitales modernos.

01 — LOGISTICS

Automatizando la logística — pensado para pymes de la región DACH

Gran parte de nuestro trabajo se dedica a software de logística y operaciones para pequeñas y medianas empresas de Alemania, Austria y Suiza. Estas empresas suelen quedar atrapadas entre dos opciones poco atractivas: costosas suites logísticas empresariales diseñadas para corporaciones diez veces más grandes, o un mosaico de hojas de cálculo, formularios en papel y llamadas telefónicas que limita silenciosamente su capacidad de crecer.

Construimos el camino intermedio — automatización a medida que se adapta a cómo trabaja realmente un almacén, un taller o un equipo de distribución concretos. Eso puede significar digitalizar la recepción de mercancías y los movimientos de stock, generar automáticamente albaranes y etiquetas de envío, conectar la recepción de pedidos con la planificación de rutas, o simplemente sustituir una frágil hoja de cálculo que solo una persona entiende por un sistema compartido en el que todo el equipo puede confiar. Como trabajamos directamente con propietarios y responsables de operaciones en la región DACH, los requisitos se recogen en el idioma en el que realmente opera la empresa, y la implementación se planifica en torno a turnos y almacenes reales, no a un cronograma abstracto.

02 — WEB

Desarrollo web moderno, sobre tecnología actual

Diseñamos y desarrollamos aplicaciones web y sitios usando tecnología actual y activamente mantenida, en lugar de frameworks obsoletos mantenidos vivos por costumbre. Eso significa PHP 8.4 limpio en el backend cuando una aplicación clásica renderizada en servidor es la opción correcta, JavaScript moderno donde la interactividad importa, y MySQL 8 para datos que deben mantenerse coherentes y consultables durante años, no solo los primeros seis meses tras el lanzamiento. Cada proyecto se planifica para escritorio y móvil desde el primer boceto, no se adapta después: los tiempos de carga, los puntos de ruptura del diseño y las interacciones táctiles forman parte de la especificación, no una idea de último momento.

Más allá de la interfaz visible, nos importa cómo es un sitio por dentro: código legible, un esquema de base de datos que no necesitará reconstruirse en la próxima solicitud de funcionalidad, y pasos de despliegue que un segundo desarrollador podría seguir sin tener que llamarnos. Un sitio que rinde bien hoy y que aún puede ampliarse limpiamente dentro de tres años es, para nosotros, la verdadera definición de «moderno».

03 — AI / COCO

COCO — nuestro propio servidor de IA para pruebas de software automatizadas

Para clientes empresariales, operamos y mantenemos nuestro propio servidor de IA dedicado, llamado COCO. A diferencia de un chatbot genérico añadido a un flujo de trabajo, COCO está diseñado y alojado específicamente para las pruebas automatizadas de software web y aplicaciones de escritorio multiplataforma — desde flujos de inicio de sesión y autenticación hasta procesos empresariales completos de varios pasos.

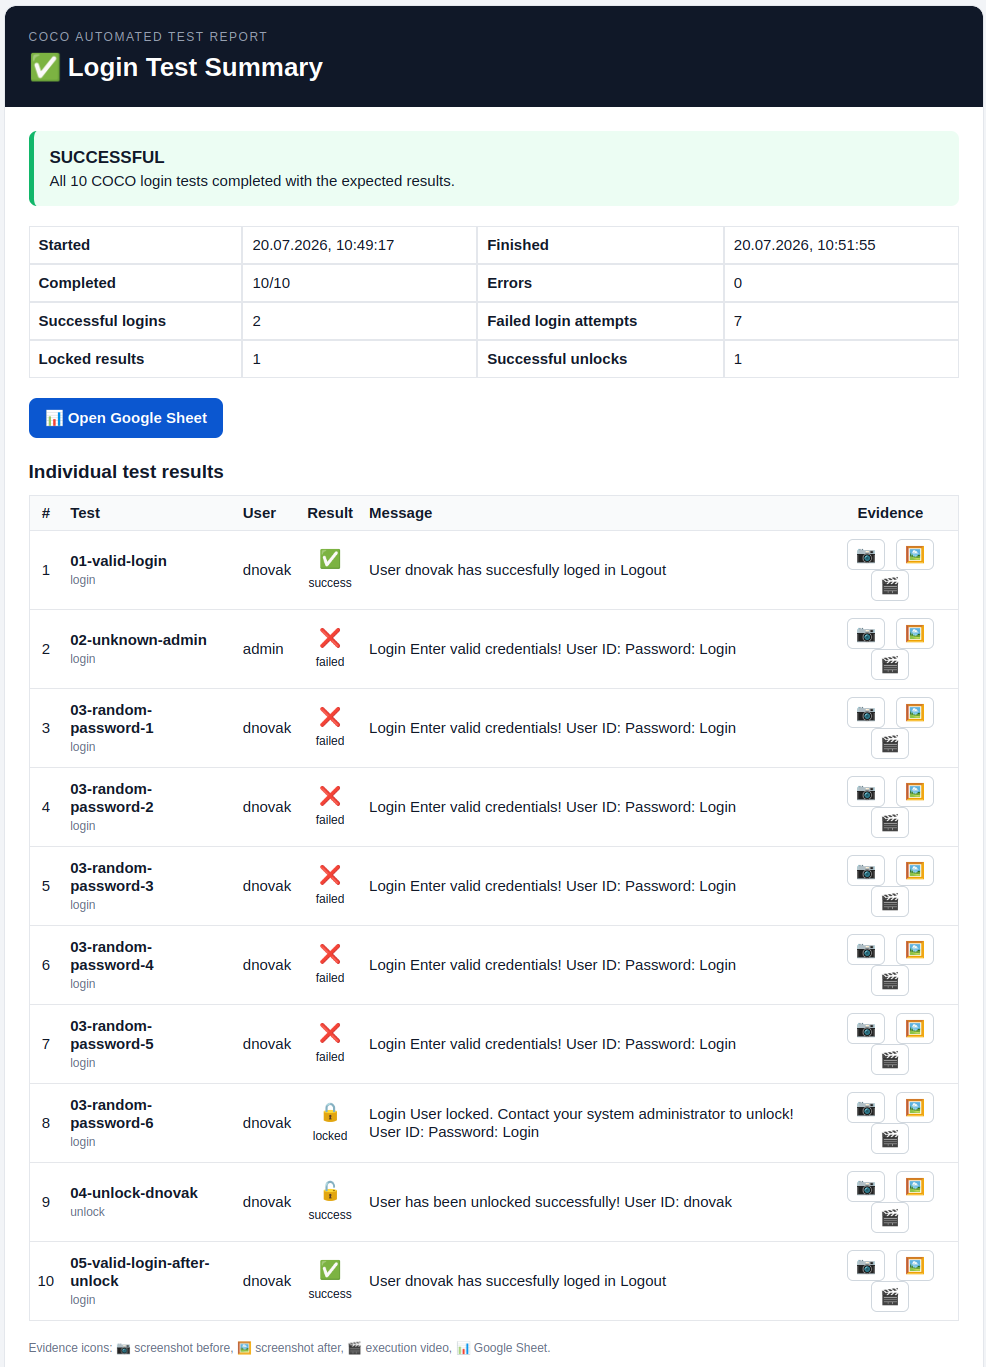
COCO planifica un escenario de prueba, lo ejecuta contra la aplicación real, captura capturas de pantalla de antes y después y grabaciones de ejecución como evidencia, y produce una evaluación en lenguaje sencillo de qué funcionó, qué falló y por qué — incluyendo casos límite como intentos de inicio de sesión fallidos repetidos, bloqueos de cuenta y flujos de recuperación, tediosos y propensos a errores si se prueban manualmente. Como el servidor se ejecuta localmente bajo nuestra gestión, los clientes empresariales mantienen el control total sobre dónde se almacenan los datos de prueba y las capturas de pantalla, sin enviar por defecto el tráfico interno de la aplicación a un servicio en la nube de terceros.

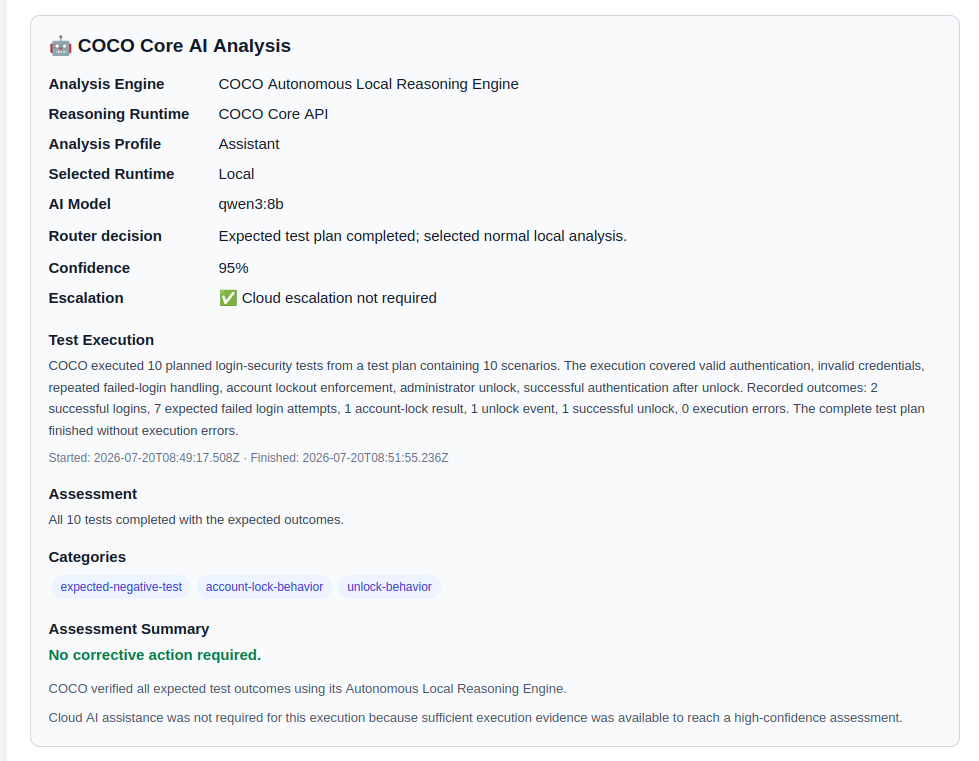
Configuramos y mantenemos COCO individualmente para cada cliente empresarial — definiendo los planes de prueba relevantes para su aplicación específica, ajustando los umbrales de confianza y decidiendo caso por caso cuándo un resultado debe escalarse para revisión humana. El objetivo no es sustituir a un equipo de QA, sino darle un colega incansable que ejecute las pruebas de regresión repetitivas antes de cada versión, antes incluso de que tenga que intervenir una persona.

COCO automated login test report
COCO — automated login & account-lockout test report
COCO AI analysis panel
COCO — plain-language AI analysis of a completed test run

Por qué softify.pro

Nos mantenemos deliberadamente lo bastante pequeños como para que cada proyecto lo gestionen las personas que estuvieron en la conversación de planificación inicial, sin pasar a una cola. Eso significa ciclos de retroalimentación más cortos, menos malentendidos y un equipo que, incluso seis meses después, recuerda por qué se tomó una decisión concreta. Preferimos una fiabilidad aburrida pero demostrable a perseguir tendencias: se elige una pila tecnológica porque encaja con el problema y podrá mantenerla otra persona dentro de cinco años, no porque estuviera de moda en el sprint en que se eligió. Si una hoja de cálculo todavía hace el trabajo mejor que un software a medida, también se lo diremos — nuestro objetivo es un flujo de trabajo realmente más rápido, no simplemente una factura de software más alta.

Trabajos seleccionados

Una pequeña selección de trabajos que podemos mostrar públicamente — más casos de estudio y proyectos empresariales están disponibles bajo petición y NDA.

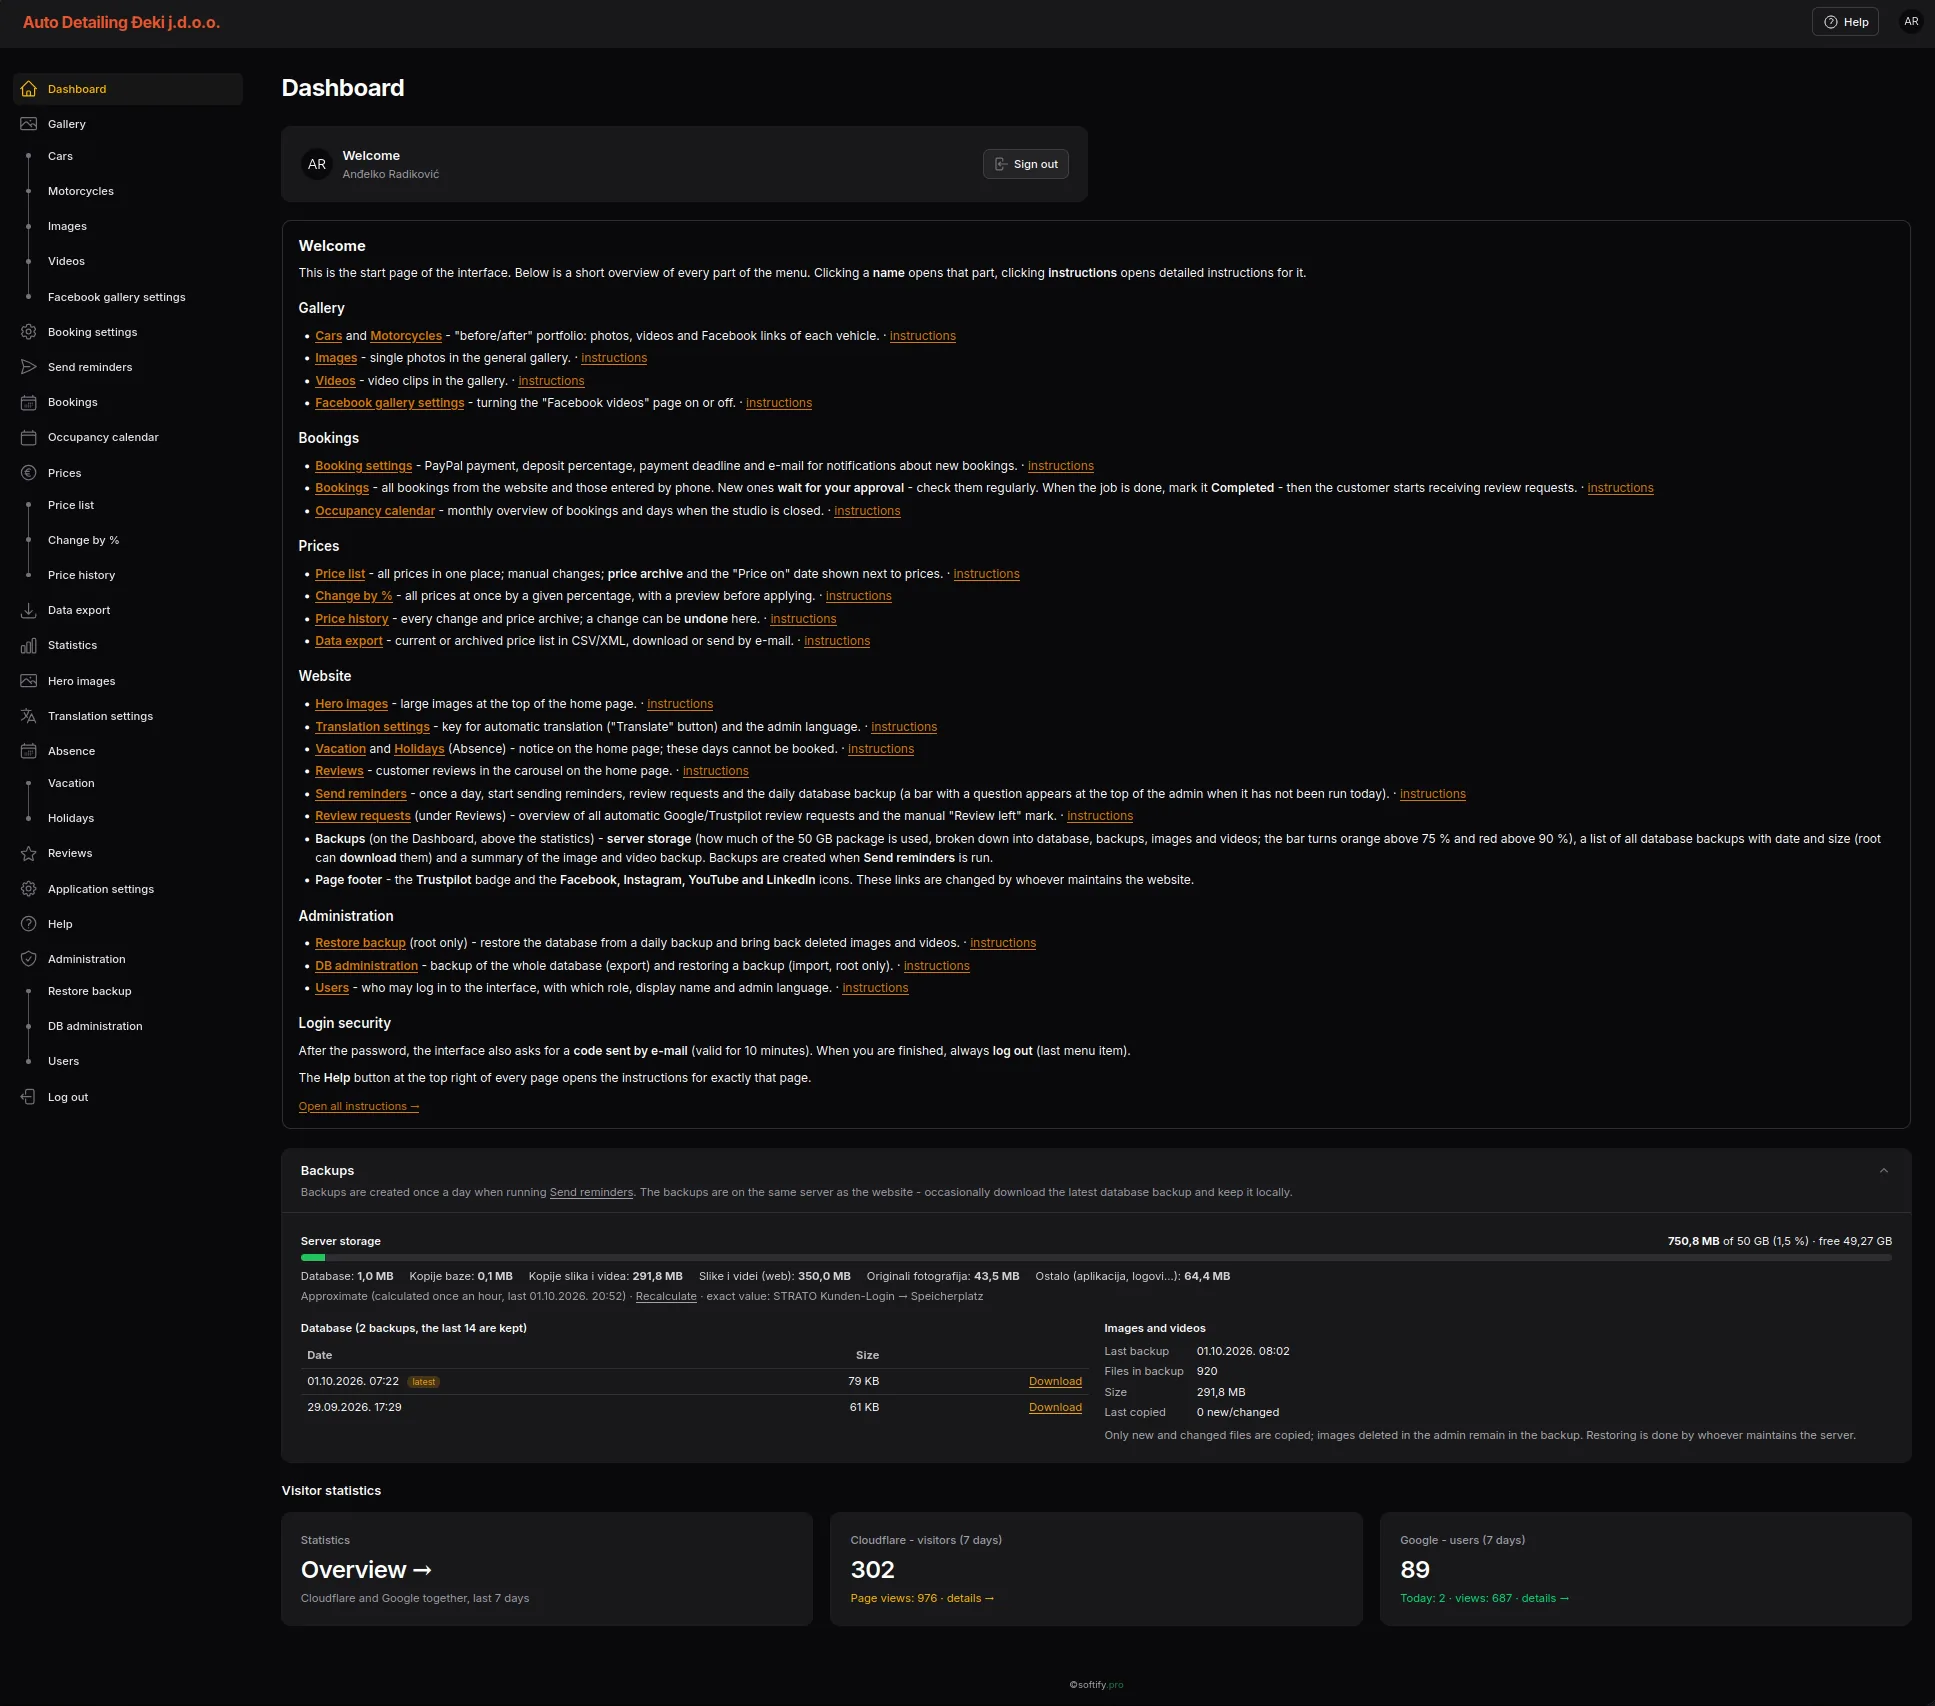
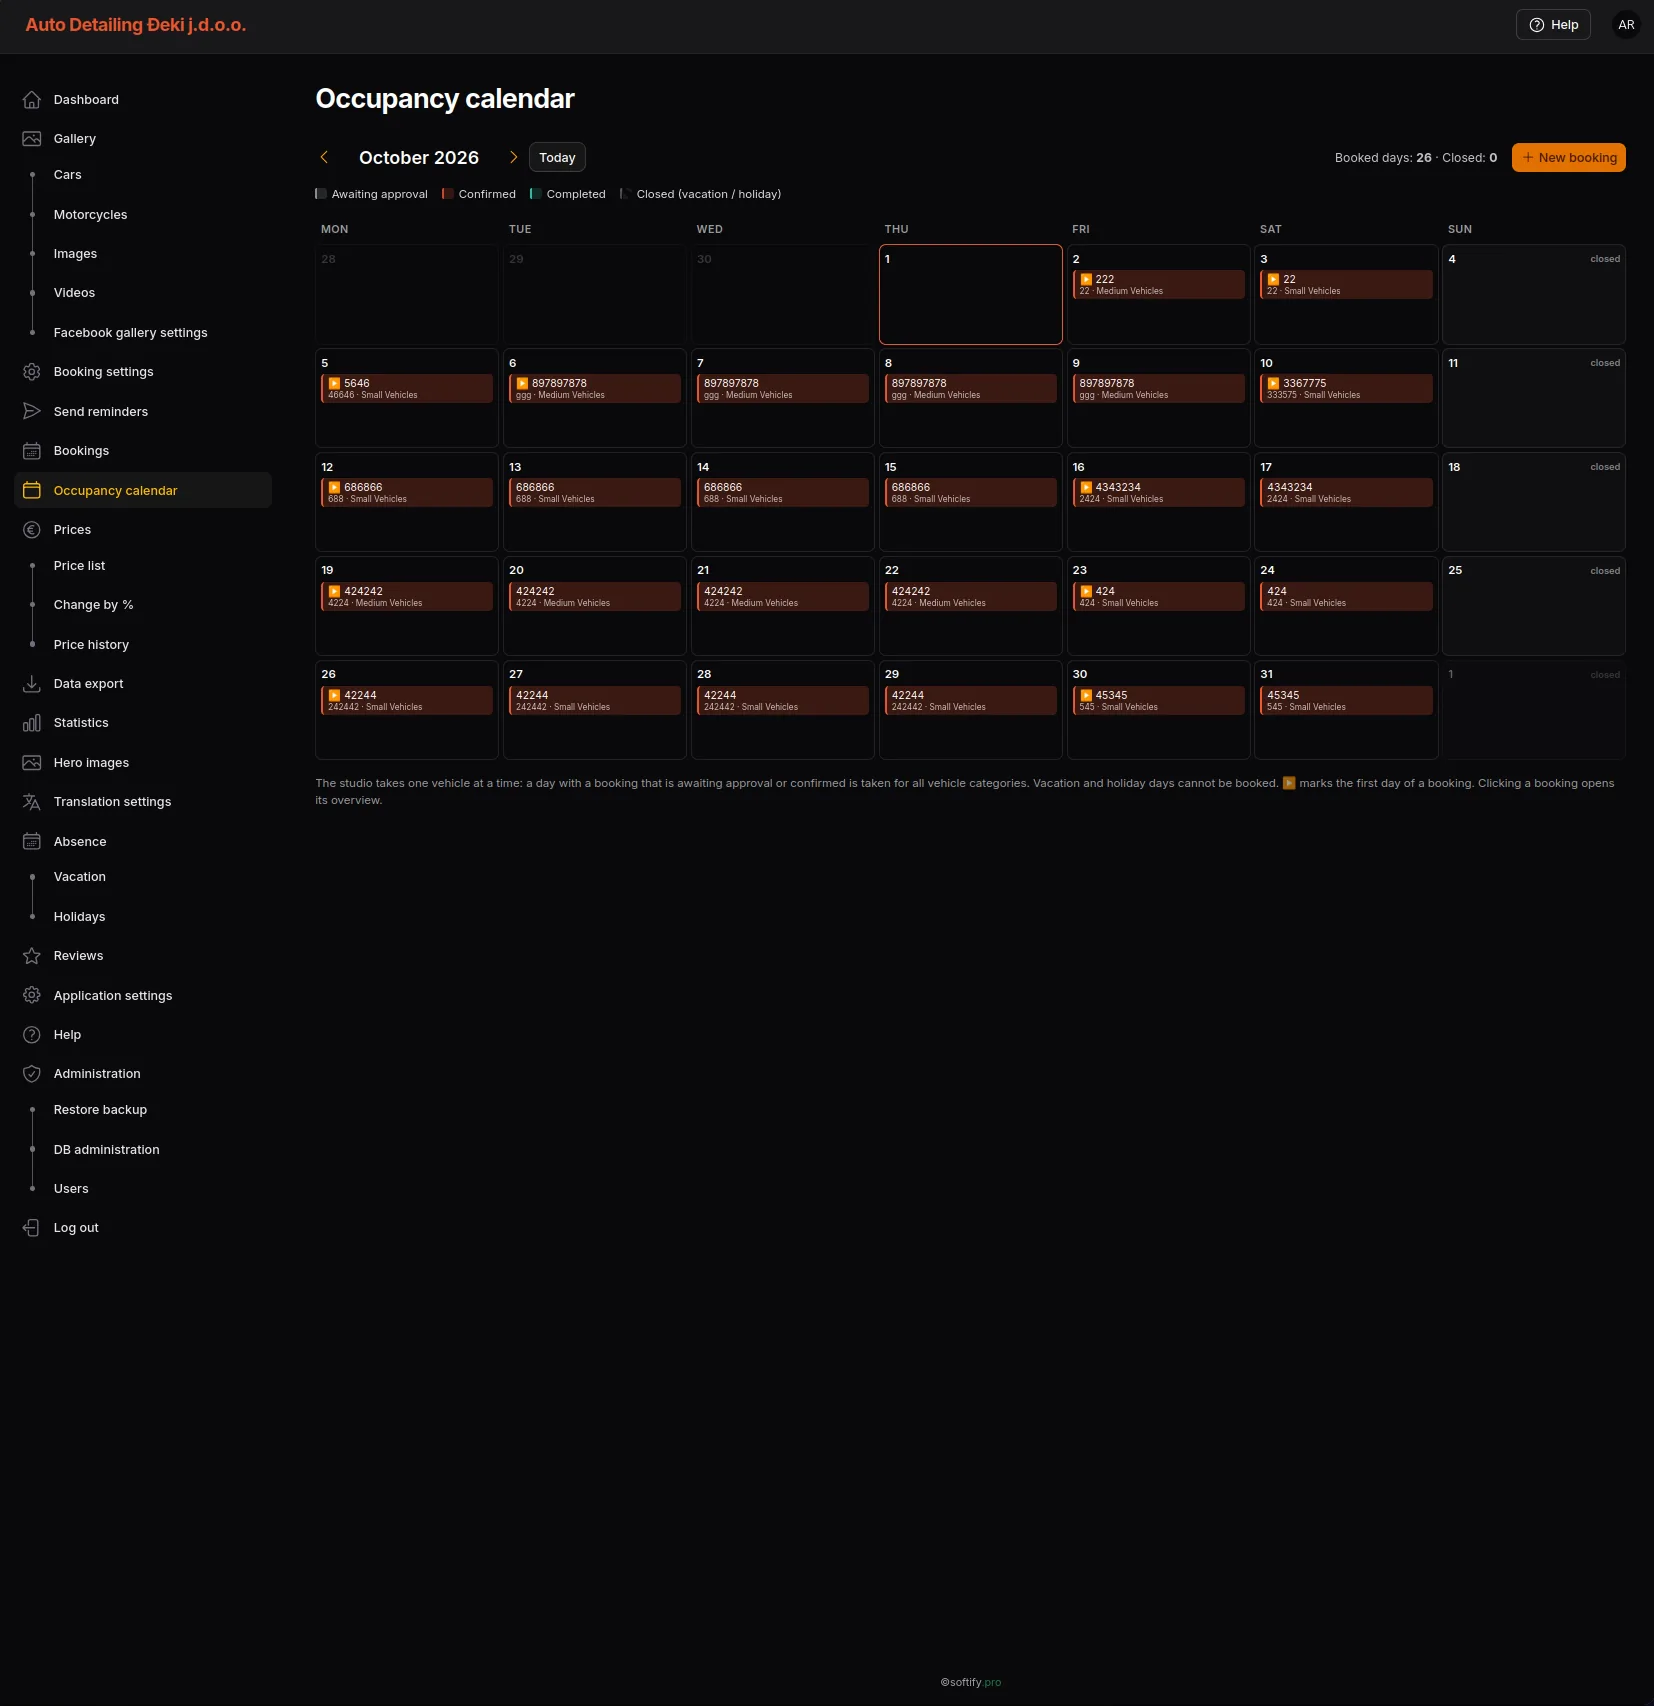
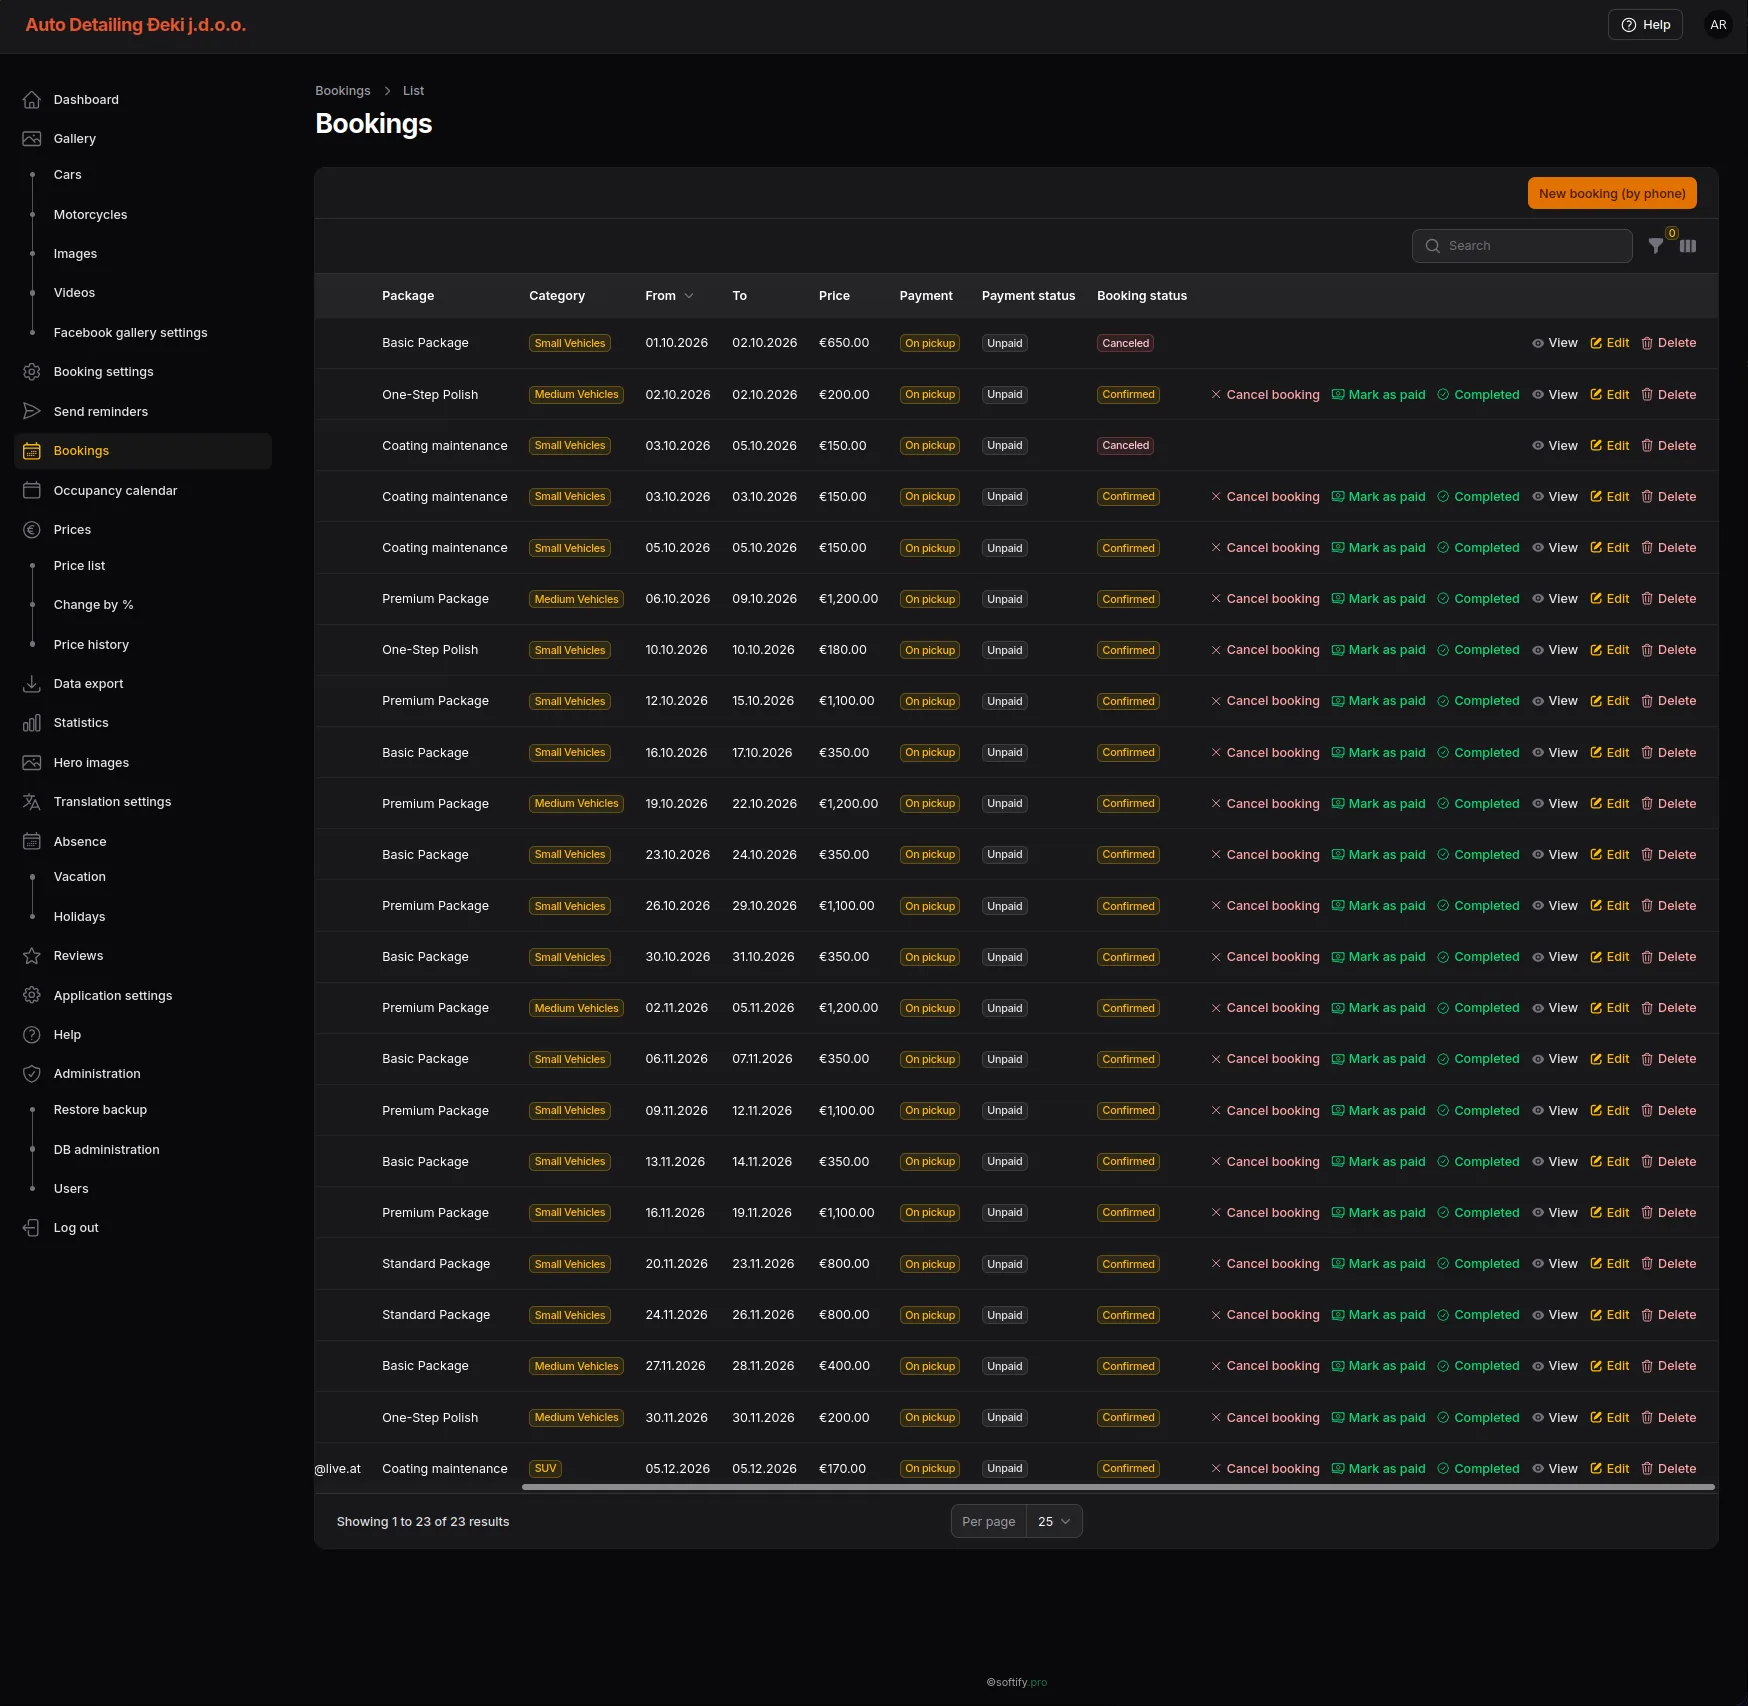
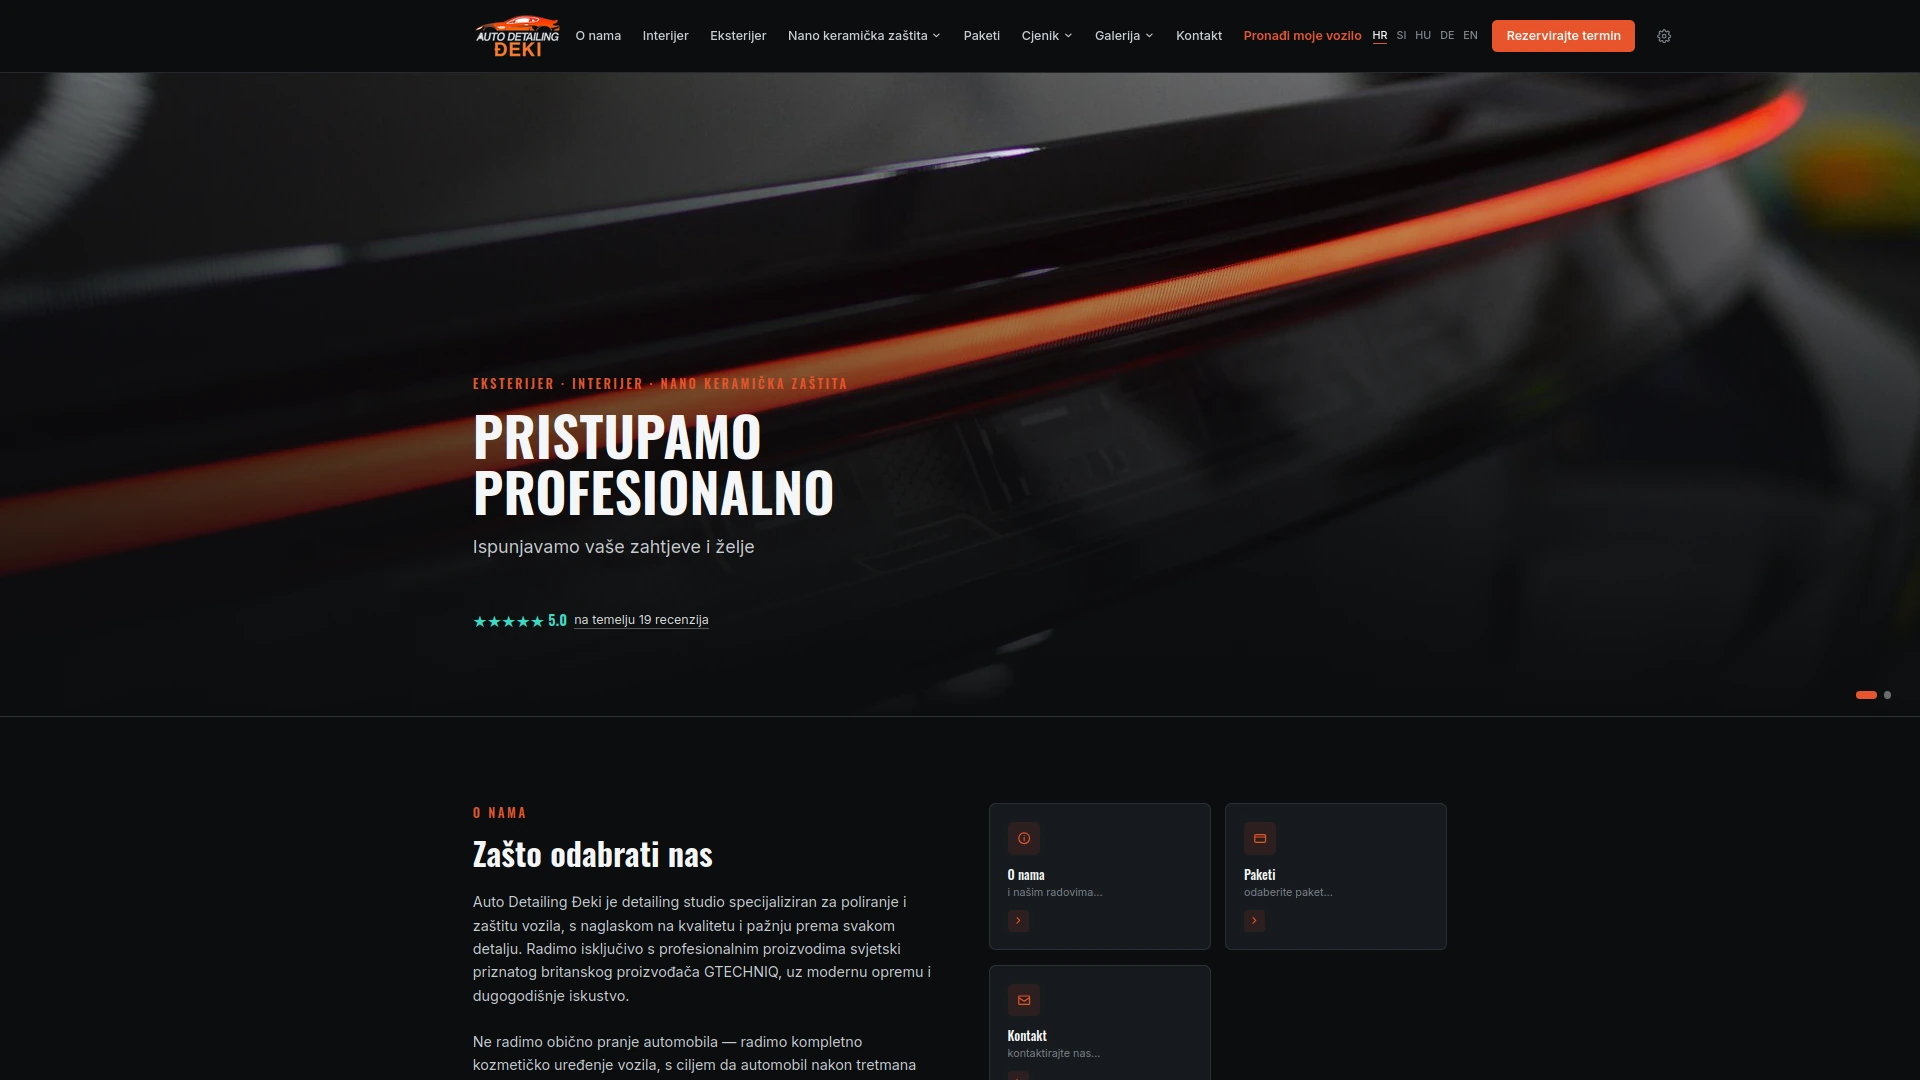
Auto Detailing Đeki – Del sitio web a una plataforma de servicios digital autodetailing-deki.pro

Auto Detailing Đeki – Del sitio web a una plataforma de servicios digital

Plataforma multilingüe para el detailing de vehículos – desde el cálculo del precio, pasando por la reserva, hasta el seguimiento transparente de pedidos, gestionada desde un back office central.

Koralpenhaus

Koralpenhaus

Sitio web regional de presentación y reservas en la región alpina, construido con un enfoque en una estructura clara, carga rápida y mantenimiento sencillo de contenidos.

Dexosano

Dexosano

Una plataforma web moderna basada en PHP, desarrollada con el mismo enfoque centrado en el rendimiento que softify.pro aplica a cada proyecto de cliente.

softify.pro - Insiders

Un almacén. Una verdad.

Un almacén. Una verdad.

Hay una forma sencilla de hacer que un software de almacén parezca convincente.
Abrir un panel de control.
Mostrar algunos números en verde.
Añadir un gráfico.
Colocar algo de stock en un mapa del almacén.
Terminar con un informe.
Todo parece estar bien.
Y aun así todo puede estar mal.
Porque a un almacén no le importa lo bien que se vea el panel de control.
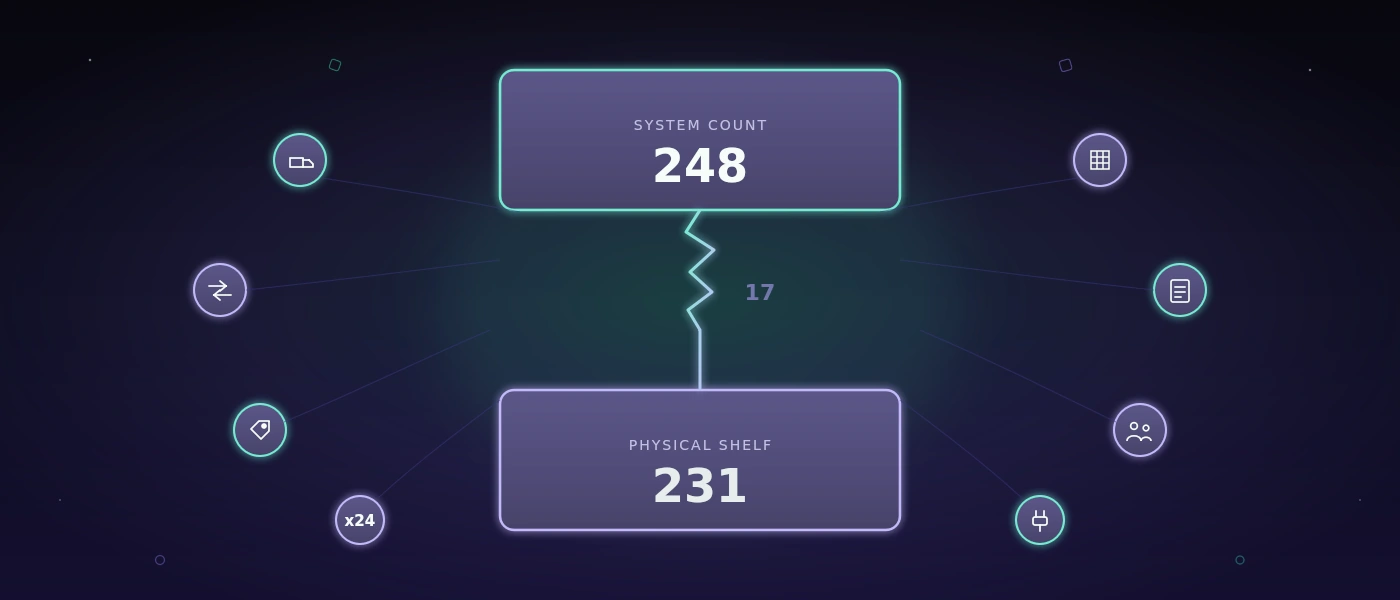
Le importa si cada parte del sistema coincide en lo que realmente ha ocurrido.
Eso se convirtió en la parte interesante del último experimento softify.pro Flow.
No otra pantalla.
No otro KPI.
No otro informe.
Algo mucho menos visible.
Coherencia.
Empezó con un almacén.
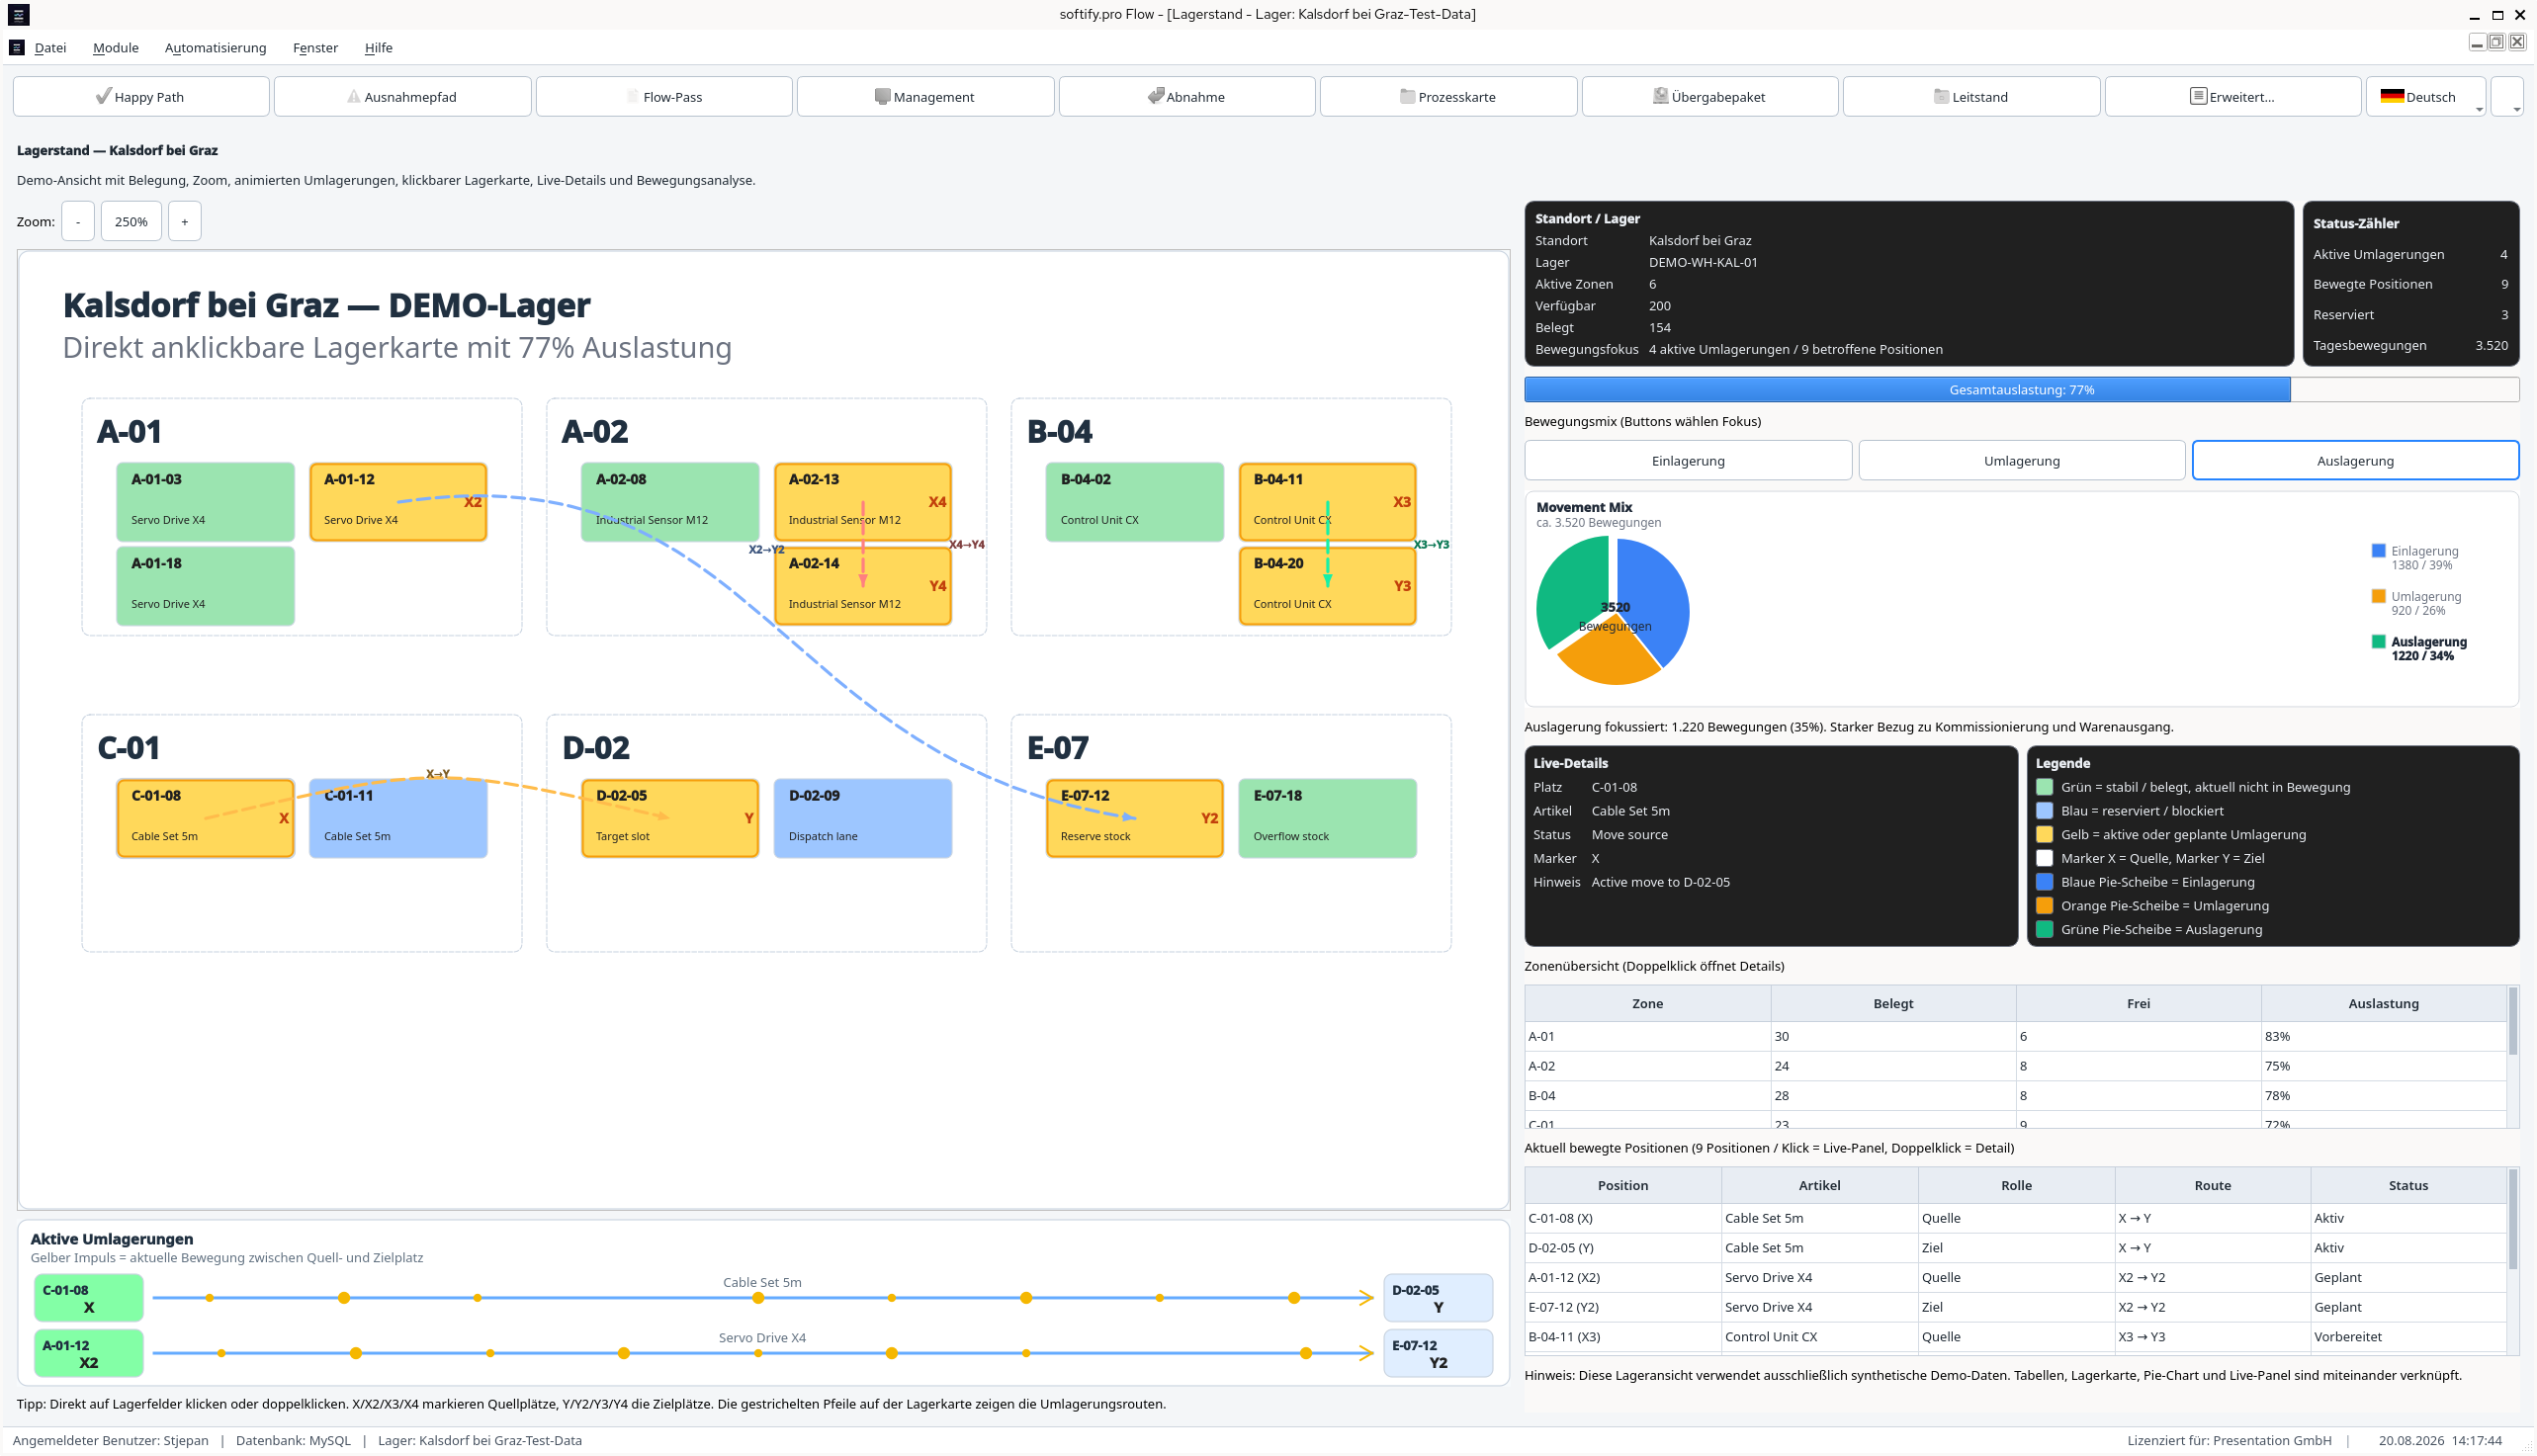
La demo actual de softify.pro Flow funciona con varios entornos de almacén sintéticos.
Distintos identificadores de almacén.
Distintas capacidades.
Distintas estructuras de zonas.
Sin inventario de producción.
Sin datos de clientes.
Sin información operativa real.
Pero la lógica del proceso se comporta como si todo eso importara.
Porque en la logística real, importa.
Una vez seleccionado un almacén, ese contexto pasa a formar parte de todo lo que sigue.
Flows.
SSCC.
Movimientos.
Operarios.
Analítica.
Informes.
Suena obvio.
Se vuelve considerablemente menos obvio cuando el mismo proceso empieza a aparecer en varias partes distintas de la aplicación.
Entonces abrimos otra vista.
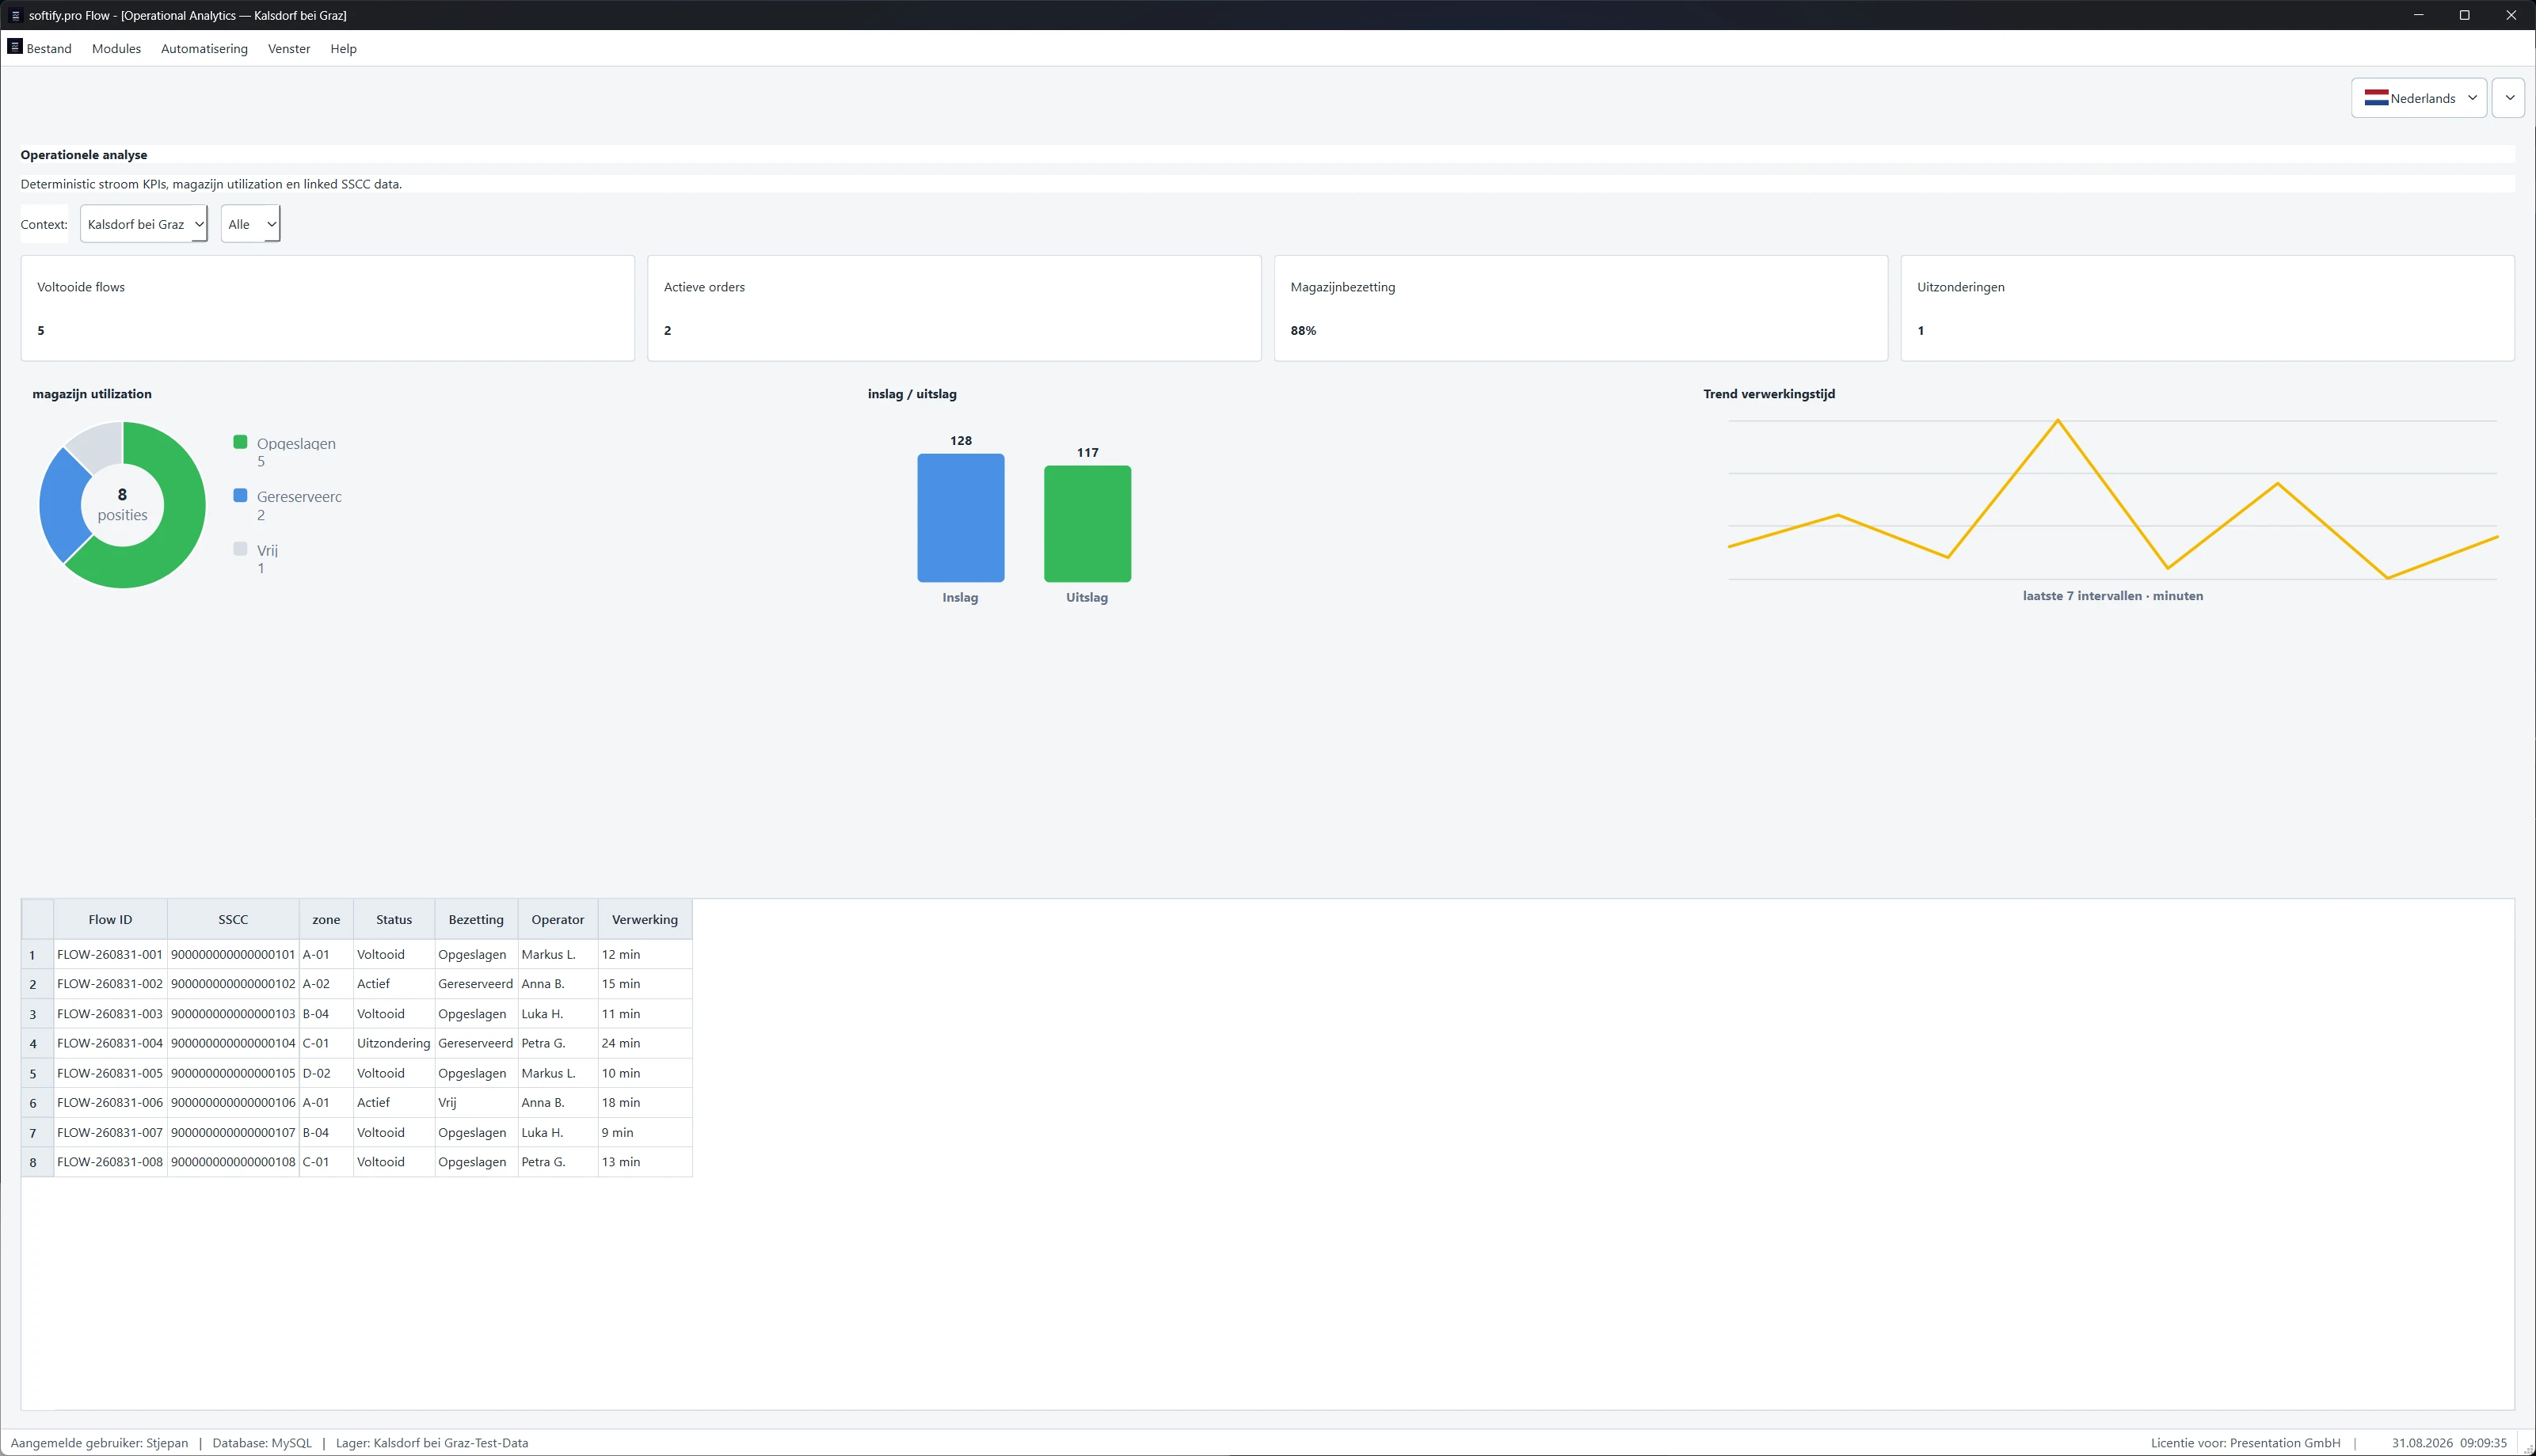
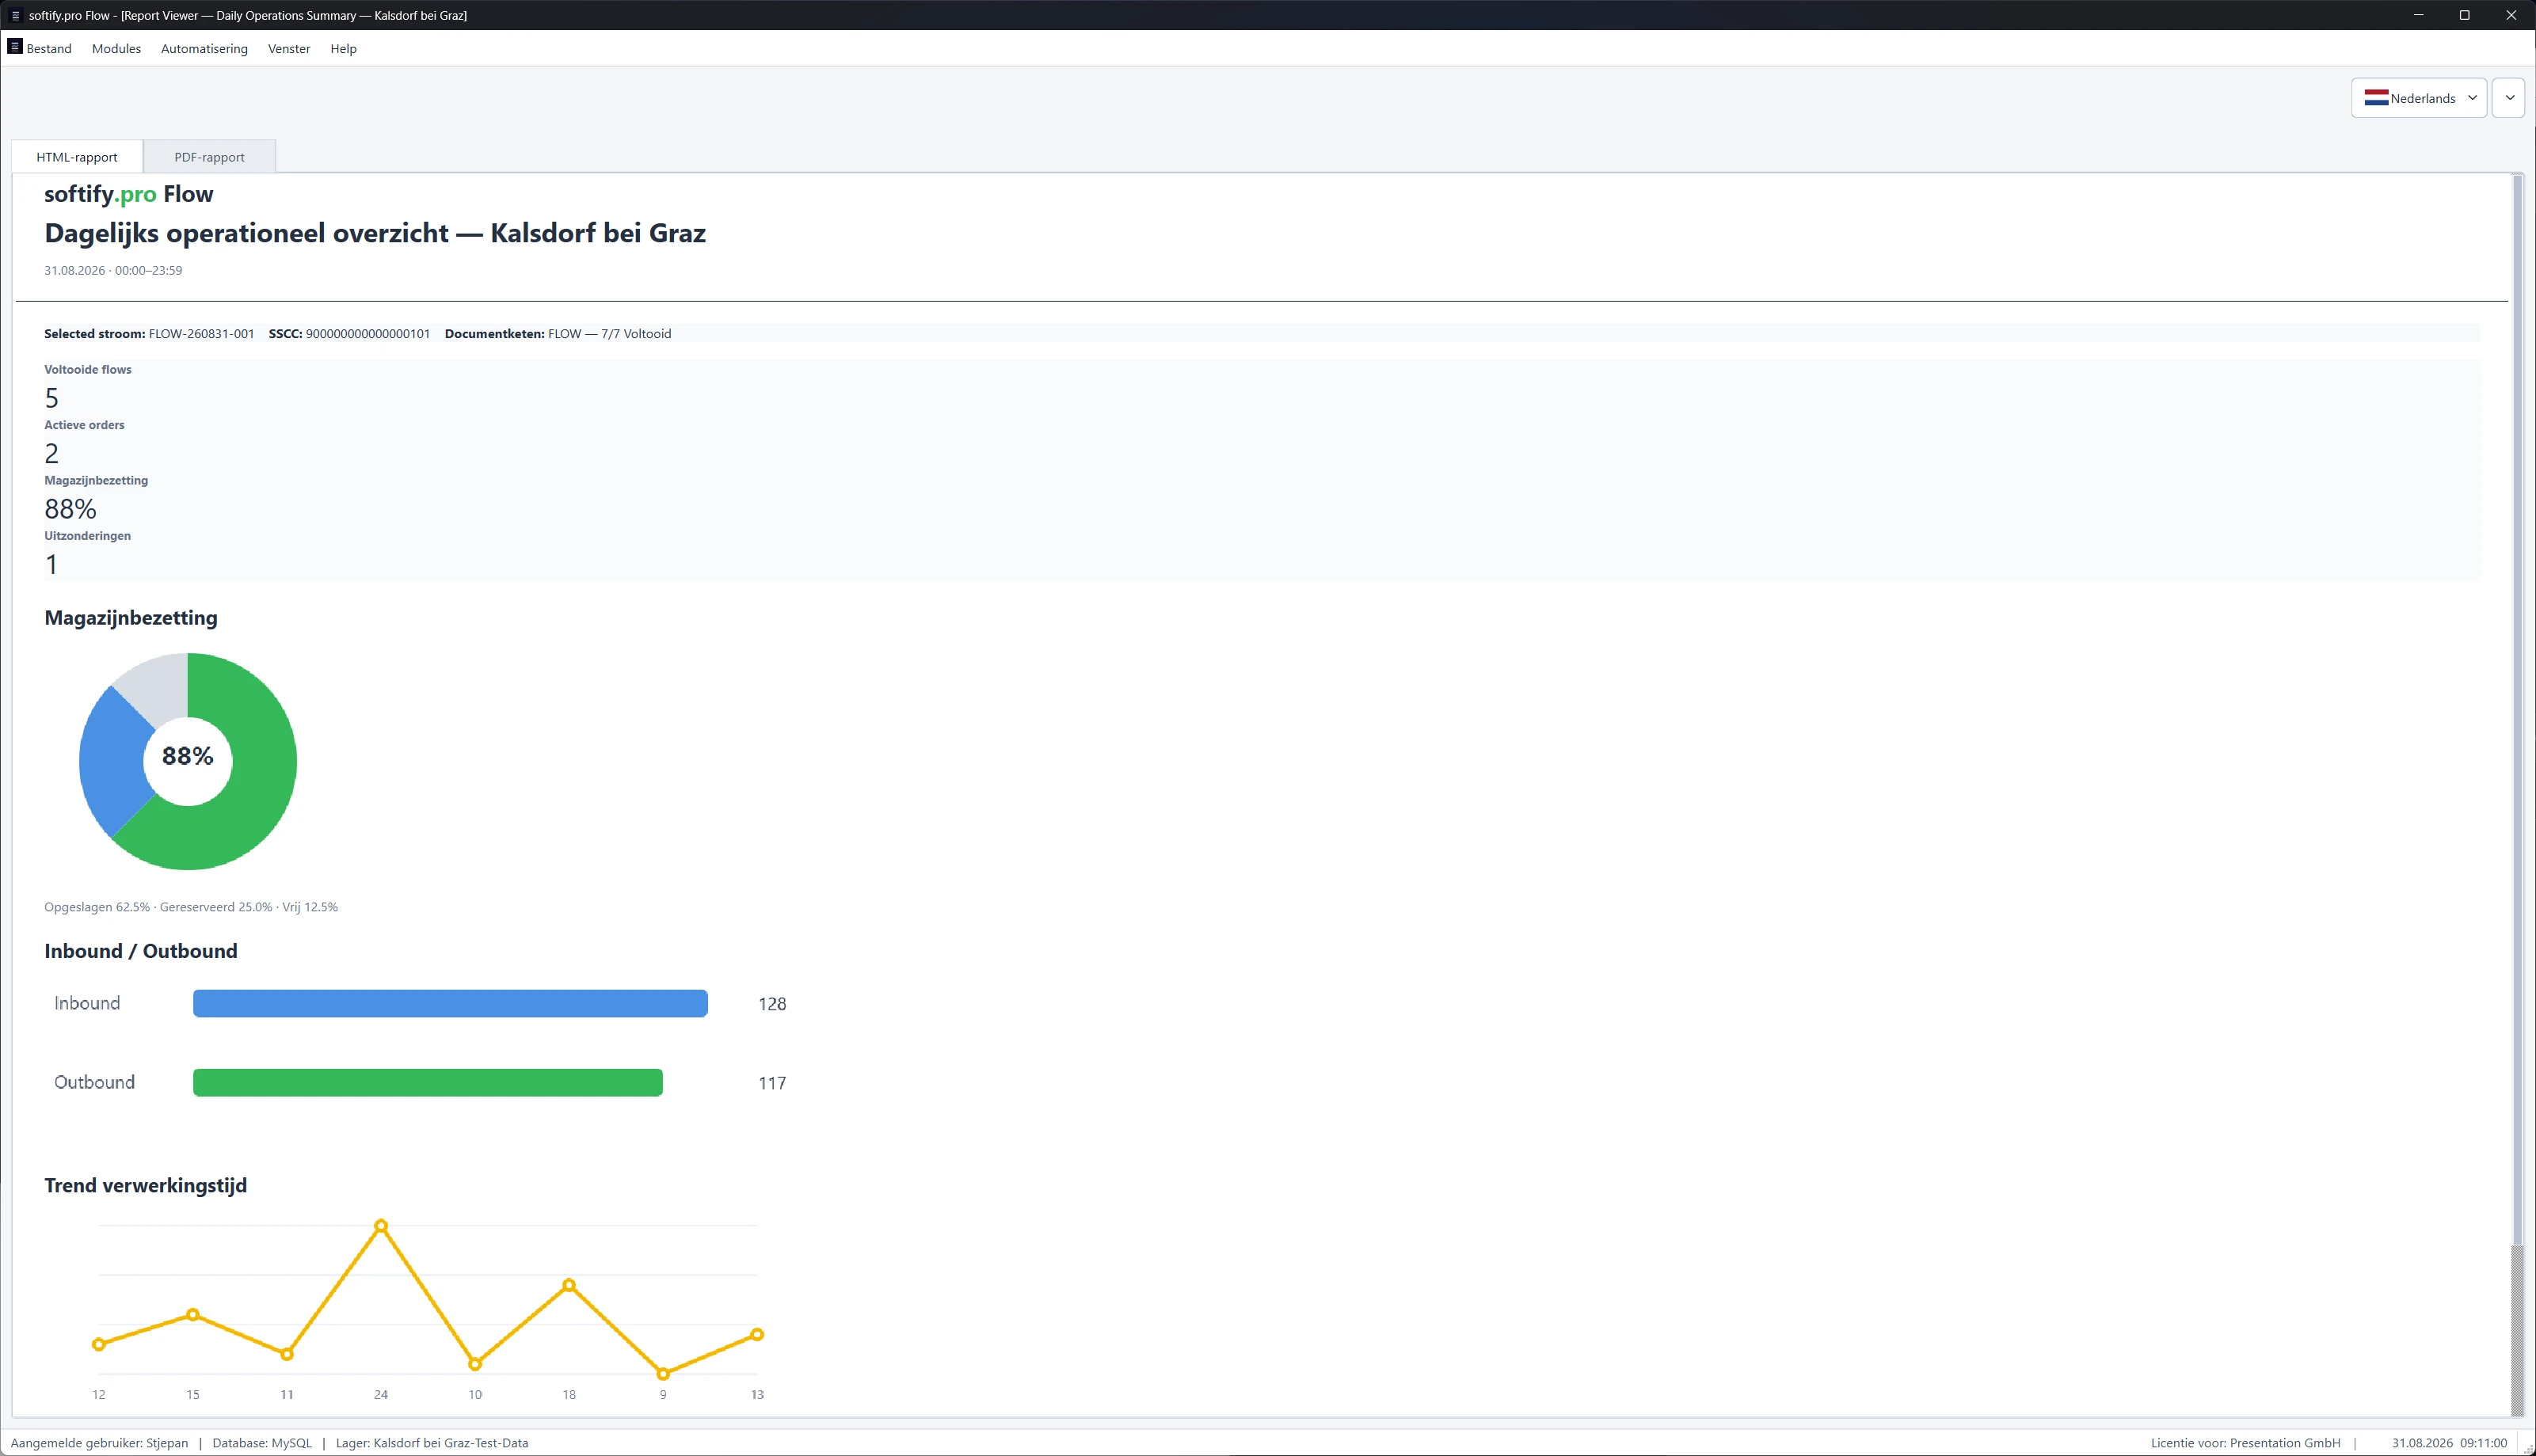
Operational Analytics.
De repente el almacén se veía completamente distinto.
Sin posiciones de almacenamiento.
Sin flechas de movimiento.
En su lugar:

  • Flows completados,
  • pedidos activos,
  • utilización del almacén,
  • excepciones,
  • entradas,
  • salidas,
  • tiempo de procesamiento.

La representación visual había cambiado.
El almacén, no.
Esa distinción se volvió importante.
Porque bajo los KPI seguía habiendo registros individuales.
Identificadores de Flow.
SSCC.
Zonas.
Estados.
Operarios.
Tiempos de procesamiento.
Vista distinta.
Misma realidad operativa.
Hasta ahí, bien.

Operational Analytics — estado agregado del almacén, con los registros Flow subyacentes todavía visibles.

Flow.

El 88% solo es útil si el sistema puede explicarlo.
Supongamos que el panel de control dice:
Utilización del almacén: 88%.
Útil.
Pero incompleto.
Algunas posiciones están ocupadas.
Algunas están reservadas.
Algunas permanecen libres.
Esos estados no son intercambiables.
El número solo resulta fiable si el sistema todavía puede explicar de dónde viene.
¿Cinco Flows completados?
Muéstralos.
¿Dos pedidos activos?
Muéstralos.
¿Una excepción?
¿Cuál?
¿88% de utilización?
¿Qué está ocupado?
¿Qué está reservado?
¿Qué permanece libre?
Un panel de control debería resumir la realidad.
No debería sustituirla.
Entonces cambiamos el idioma.
Neerlandés.
El almacén siguió siendo el mismo.
Los identificadores de Flow siguieron siendo los mismos.
Los SSCC siguieron siendo los mismos.
Los operarios siguieron vinculados a sus registros.
Solo cambió el idioma.
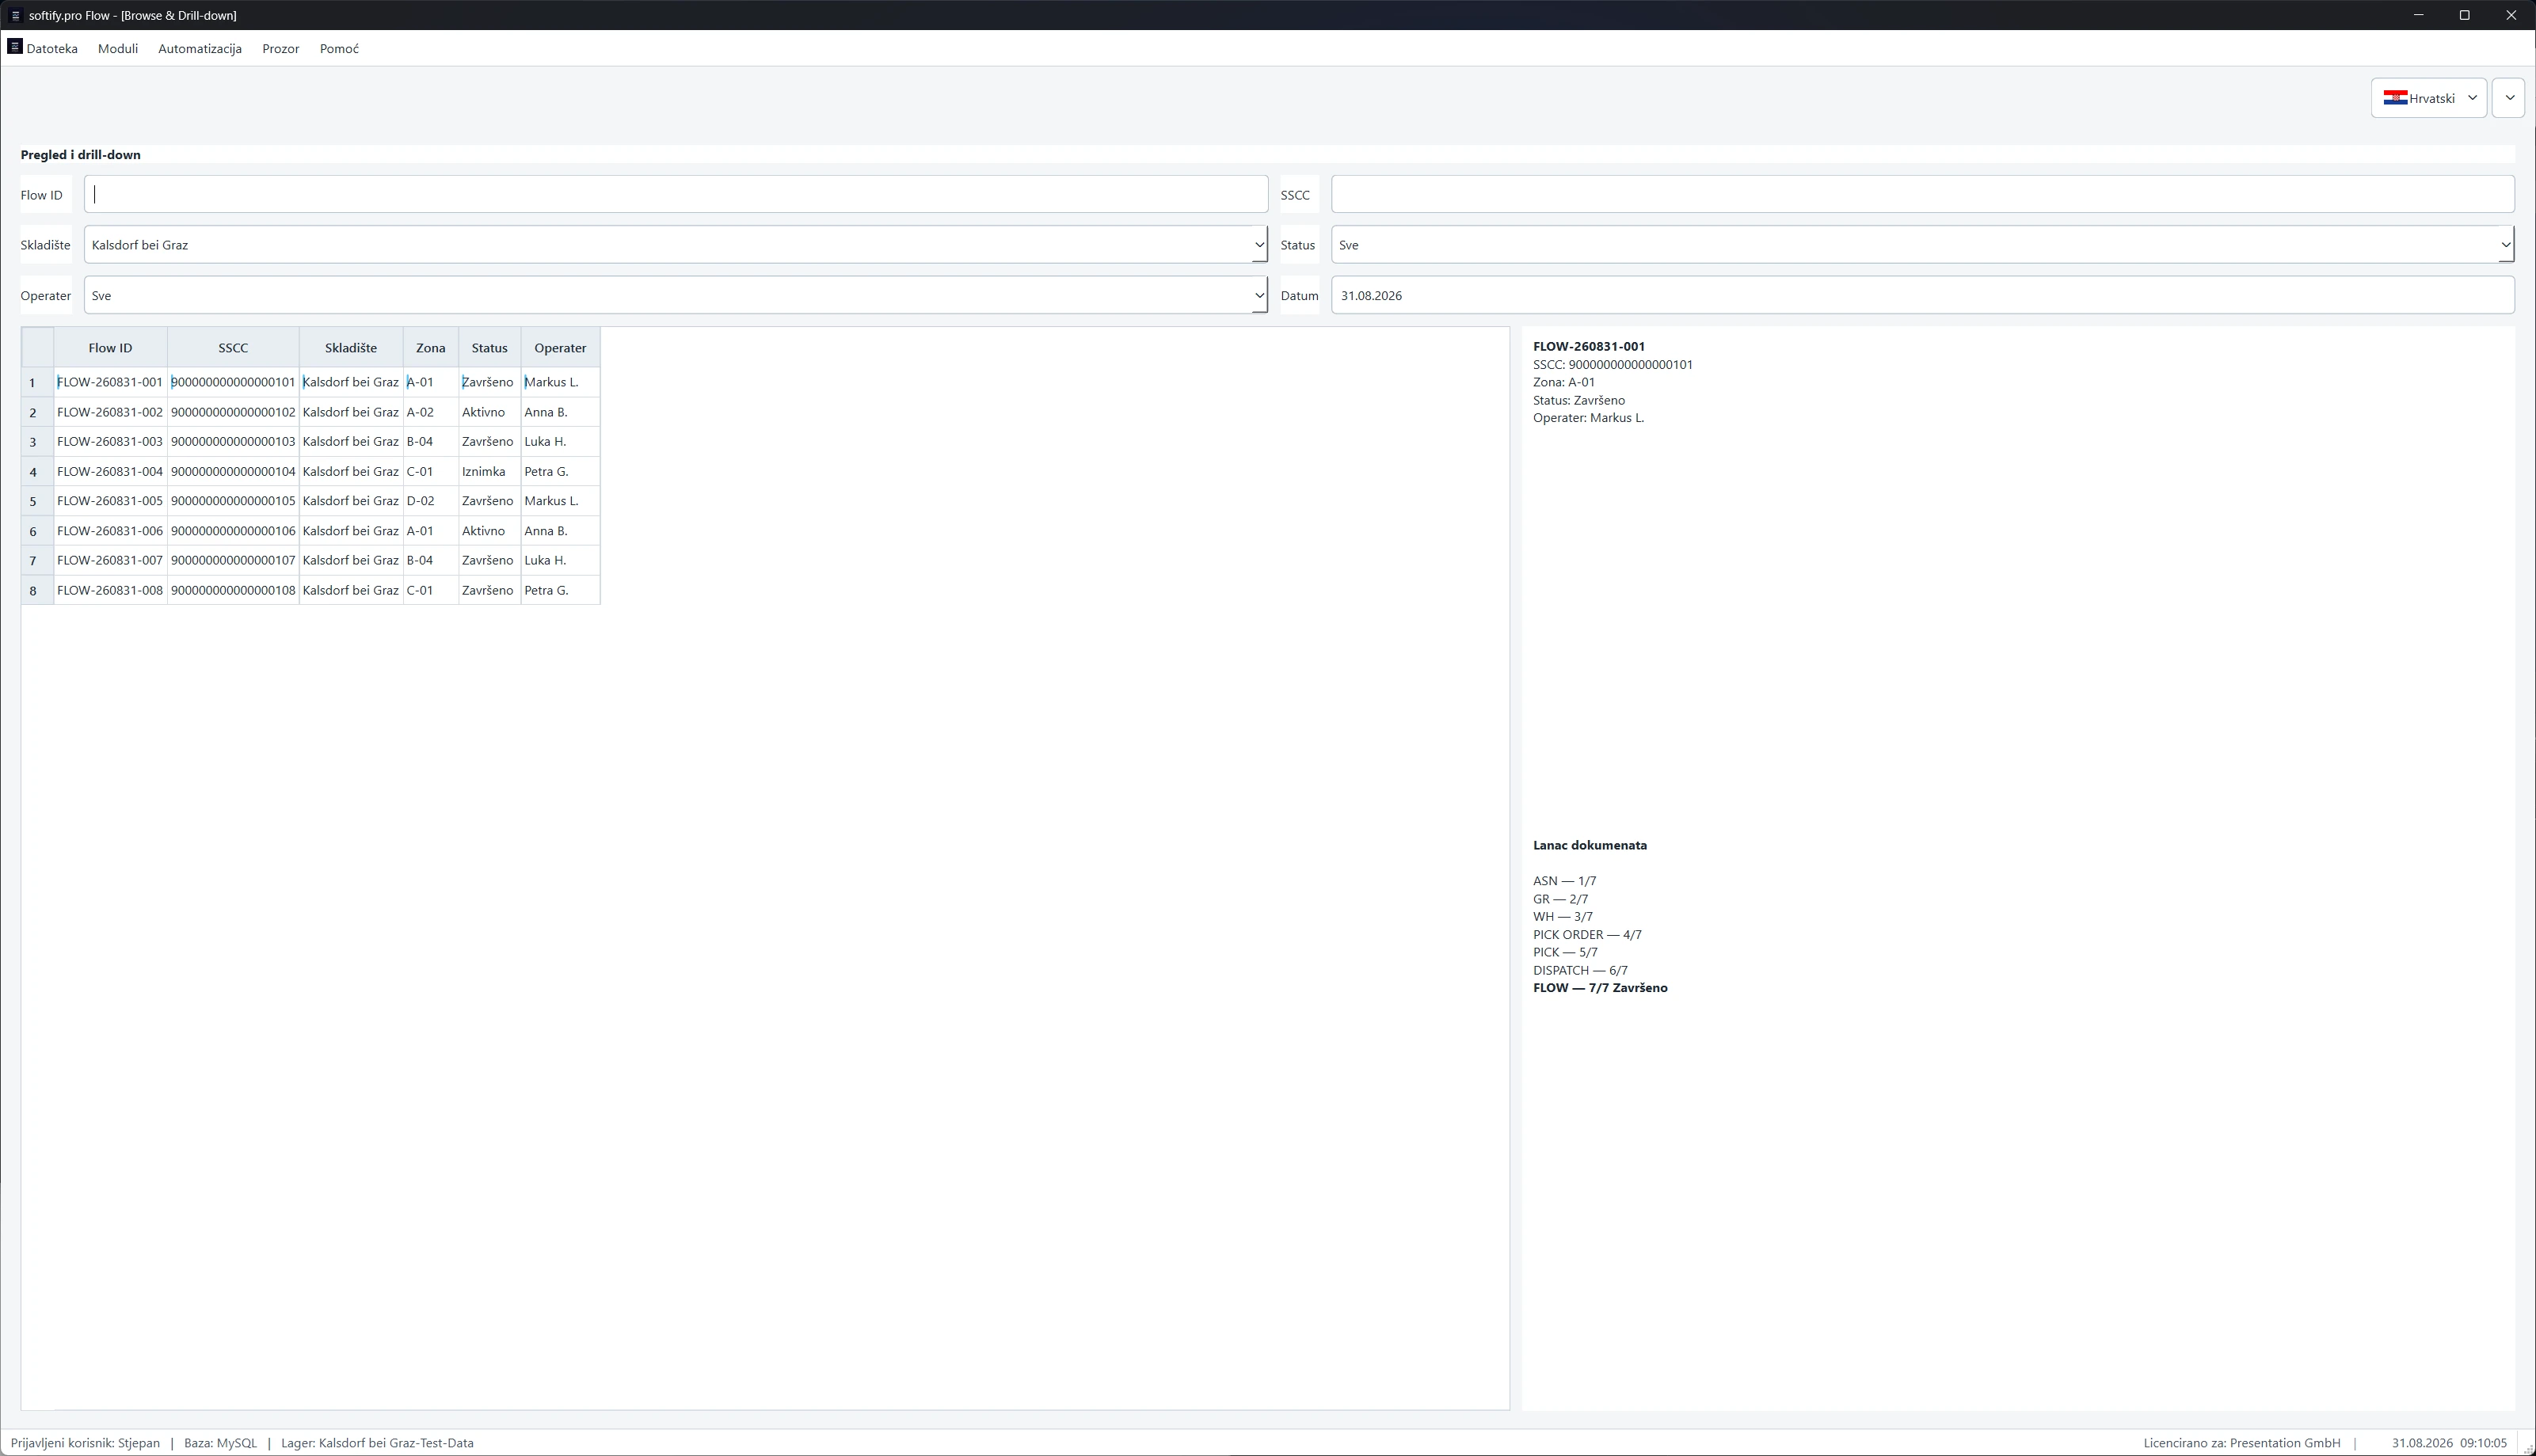
Más tarde el mismo estado operativo apareció en croata.
Luego en francés.
Aquí es donde el software multilingüe se vuelve mucho más interesante que los botones traducidos.
Una mala traducción es fácil de notar.
Un cambio de estado provocado por un cambio de idioma es mucho más peligroso.
Imagina pasar de alemán a francés y perder silenciosamente el Flow seleccionado.
O reconstruir un filtro contra el almacén equivocado.
O mostrar el SSCC correcto dentro del contexto de proceso equivocado.
La interfaz podría seguir viéndose perfecta.
El sistema no lo sería.
Flow sigue por eso una regla sencilla:
El idioma puede cambiar las palabras. No puede cambiar la verdad.
Luego el Flow adquirió un historial.
Browse & Drill-down no se esfuerza especialmente por parecer impresionante.
Quizá por eso es útil.
Selecciona un Flow.
Aparece su contexto.
Almacén.
Zona.
Estado.
Operario.
SSCC.
Y luego la cadena documental.
ASN.
Recepción de mercancía.
Movimiento de almacén.
Orden de picking.
Picking.
Expedición.
FLOW.
Siete pasos.
El proceso ya no es solo un estado actual.
Tiene un pasado.
Y eso cambia la pregunta.
En lugar de:
¿Qué está pasando?
podemos preguntar:
¿Cómo hemos llegado hasta aquí?
Es una pregunta mucho mejor cuando algo finalmente sale mal.

Un Flow, un SSCC, una cadena documental — desde el ASN hasta la finalización.

Flow.


El SSCC se convierte en el hilo conductor.
Al principio, un SSCC parece lo que es.
Un identificador.
Un número largo en una tabla.
Pero a través de Flow se convierte en algo más útil.
Un hilo conductor a través del proceso.
Al seguirlo, otras cosas empiezan a conectarse.
Un almacén.
Un Flow.
Una zona.
Un estado.
Un operario.
Una cadena documental.
Finalmente, un informe.
El mismo objeto logístico físico ahora es visible desde varias partes distintas de la aplicación.
Útil.
También peligroso.
Porque cada vista adicional crea otra oportunidad para que el sistema cuente una historia distinta.
Y ahí es donde las cosas se vuelven interesantes.
Supongamos que Analytics dice que el Flow está activo.
Drill-down dice que el SSCC pertenece a ese Flow.
La cadena documental dice que la operación ha avanzado más.
El informe dice otra cosa.
¿Cuál es correcto?
No es un problema específico de Flow.
Es uno de los problemas más antiguos del software empresarial.
Distintas partes del mismo sistema desarrollan gradualmente su propia versión de la realidad.
Una pantalla lee el estado transaccional.
Otra lee un agregado.
Otra depende de datos en caché.
Un informe calcula algo de forma ligeramente distinta.
Una excepción se resuelve operativamente pero desaparece del reporting.
Cada componente funciona.
El sistema completo miente.
Normalmente con educación.
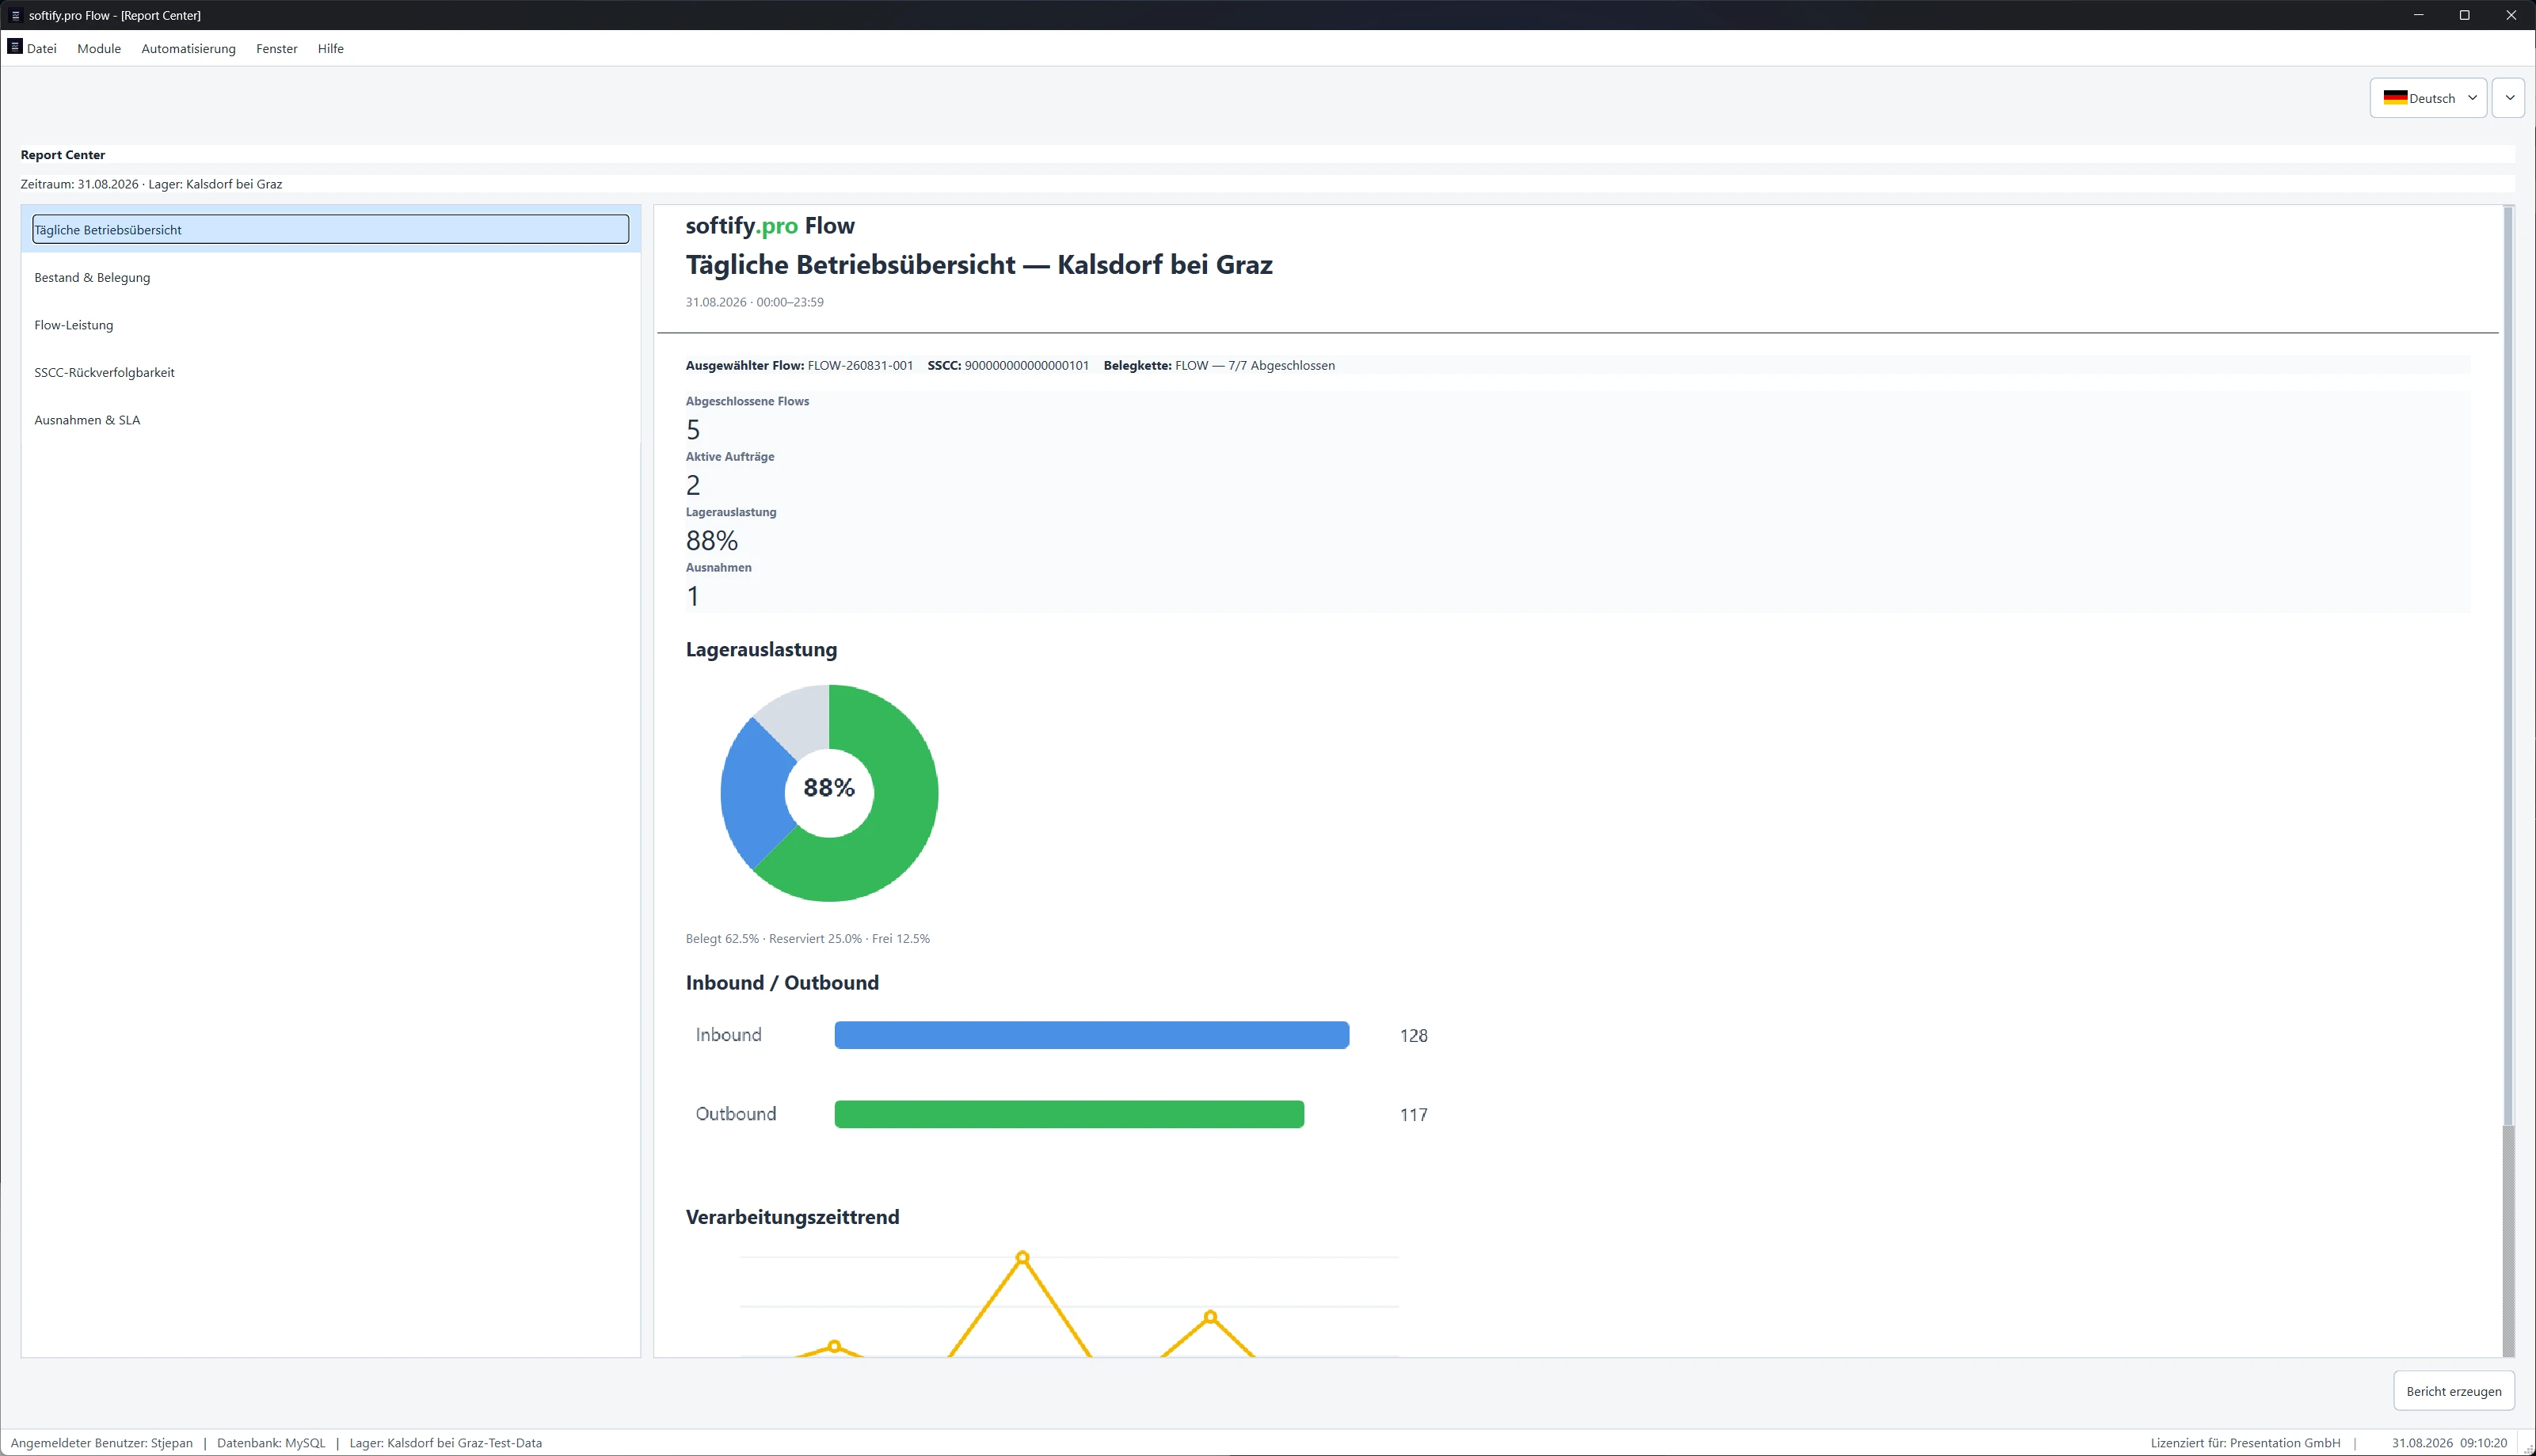
Así que abrimos el Report Center.
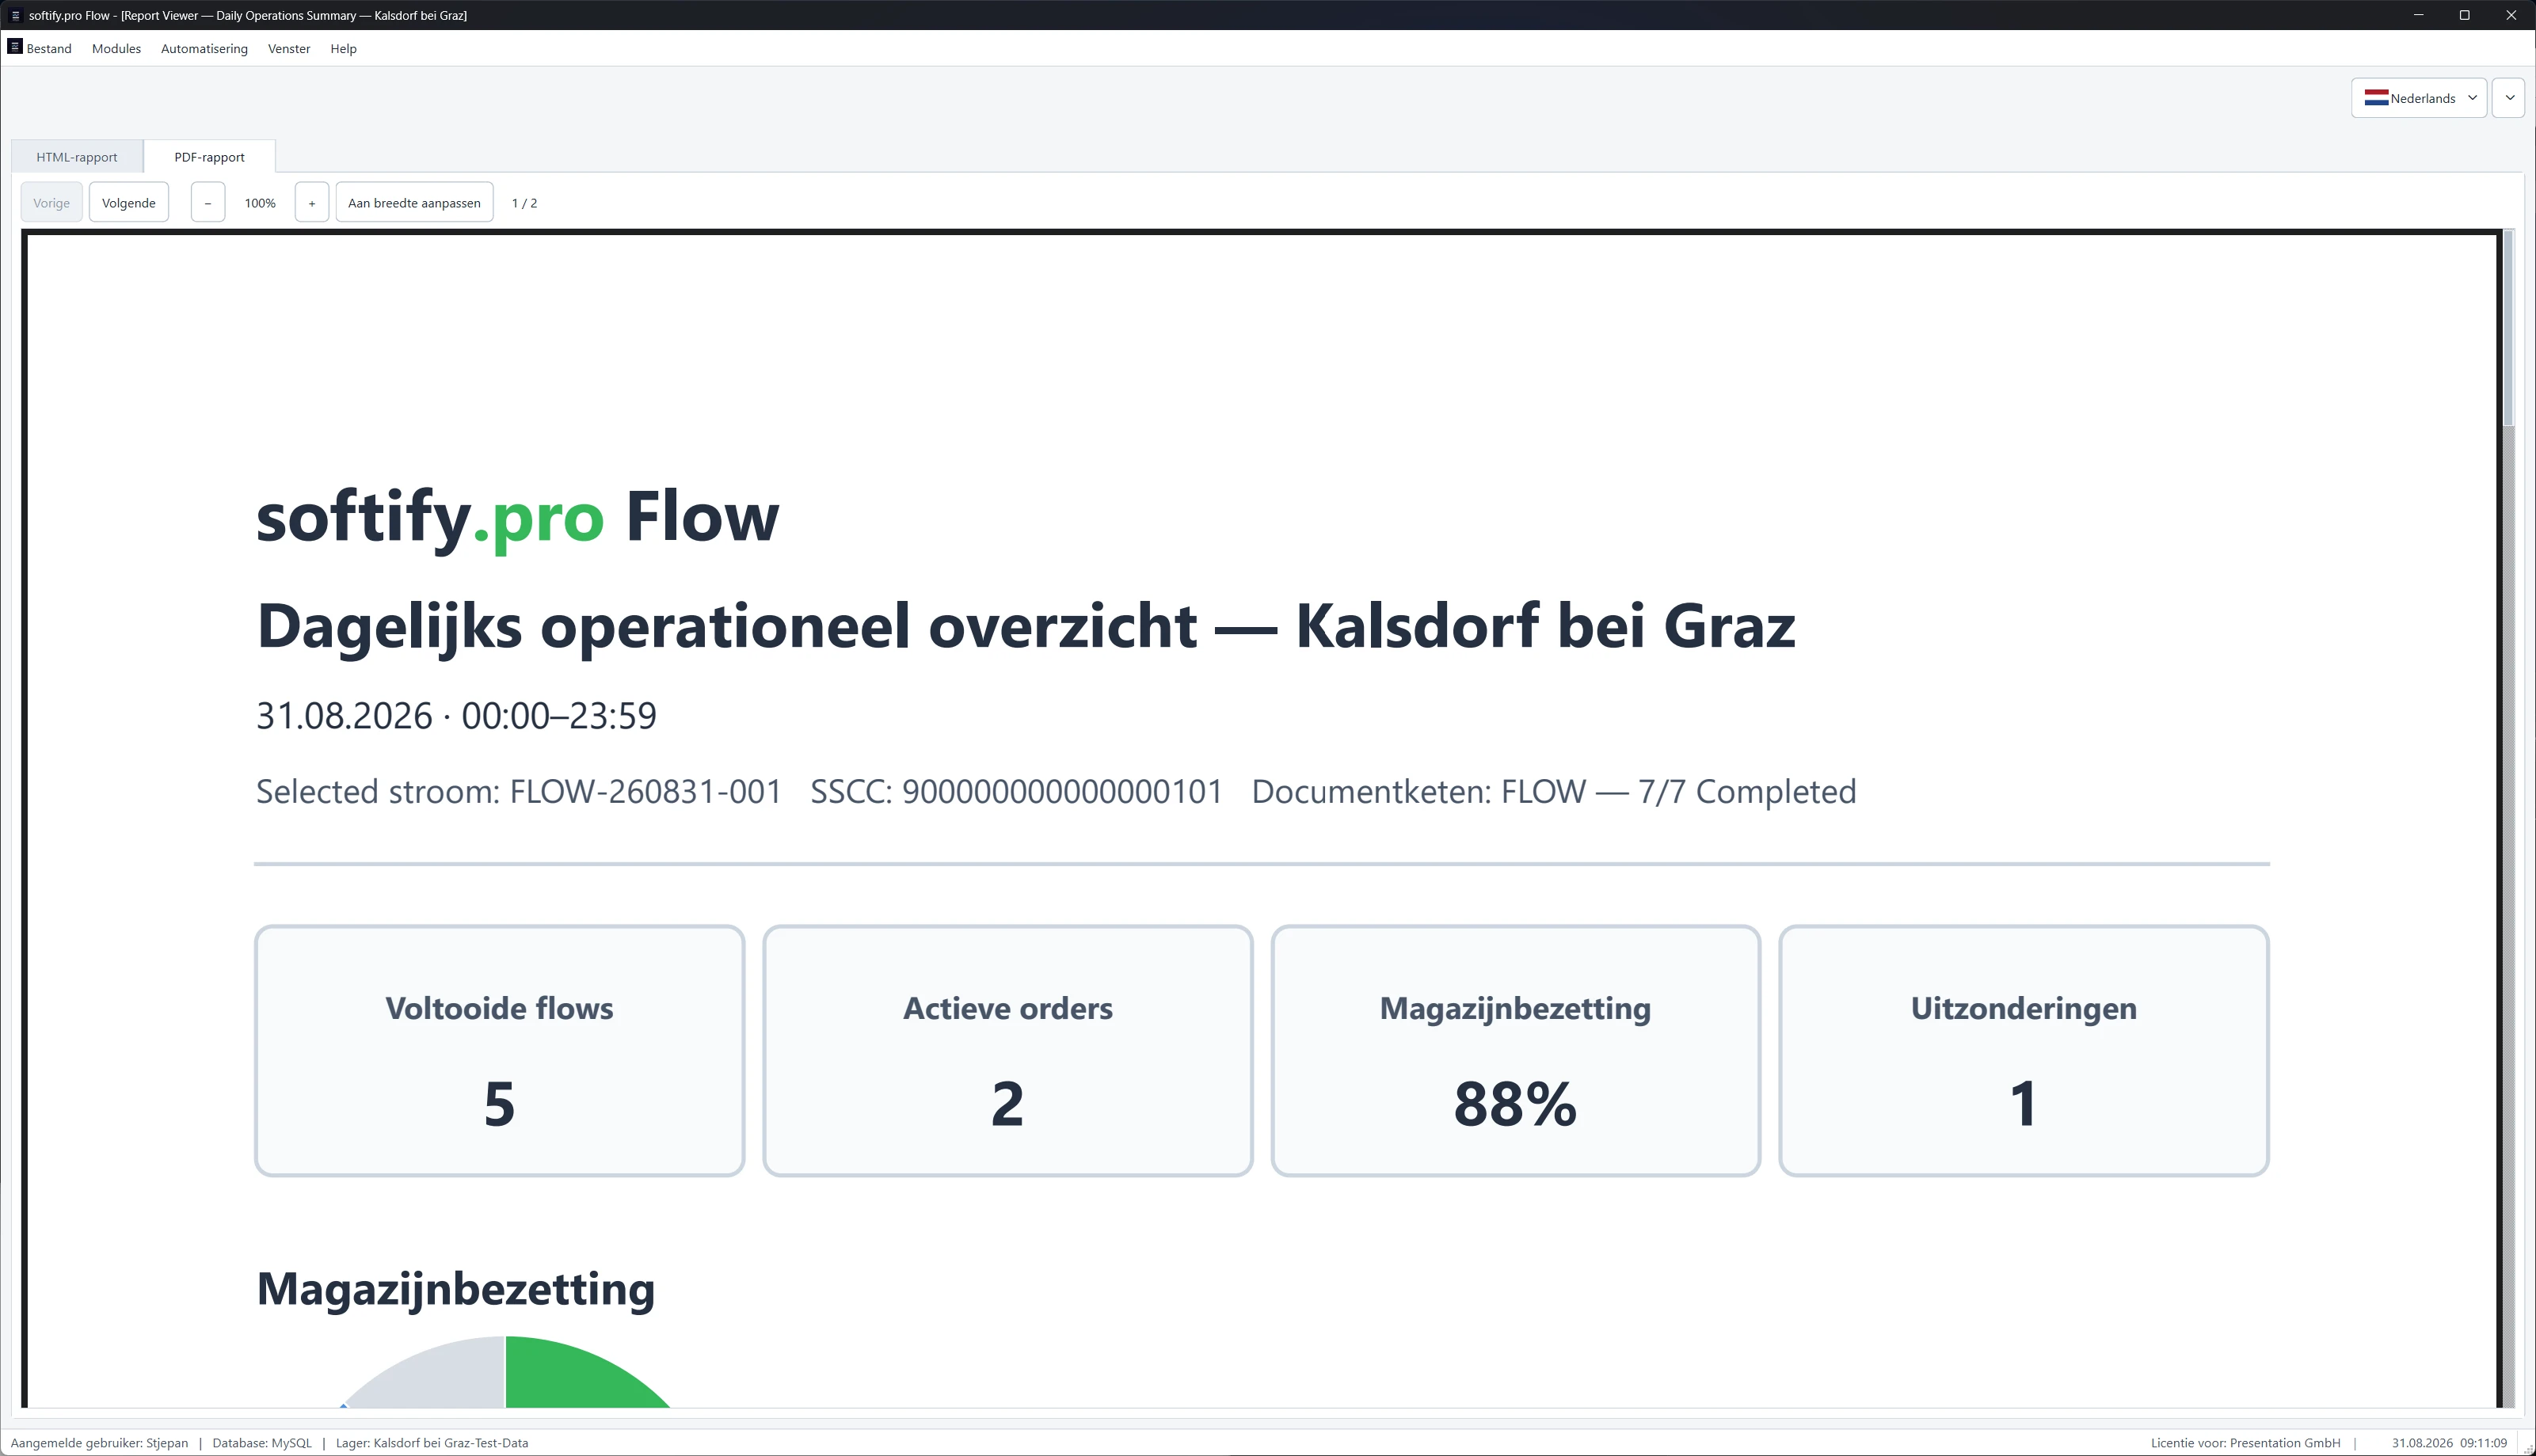
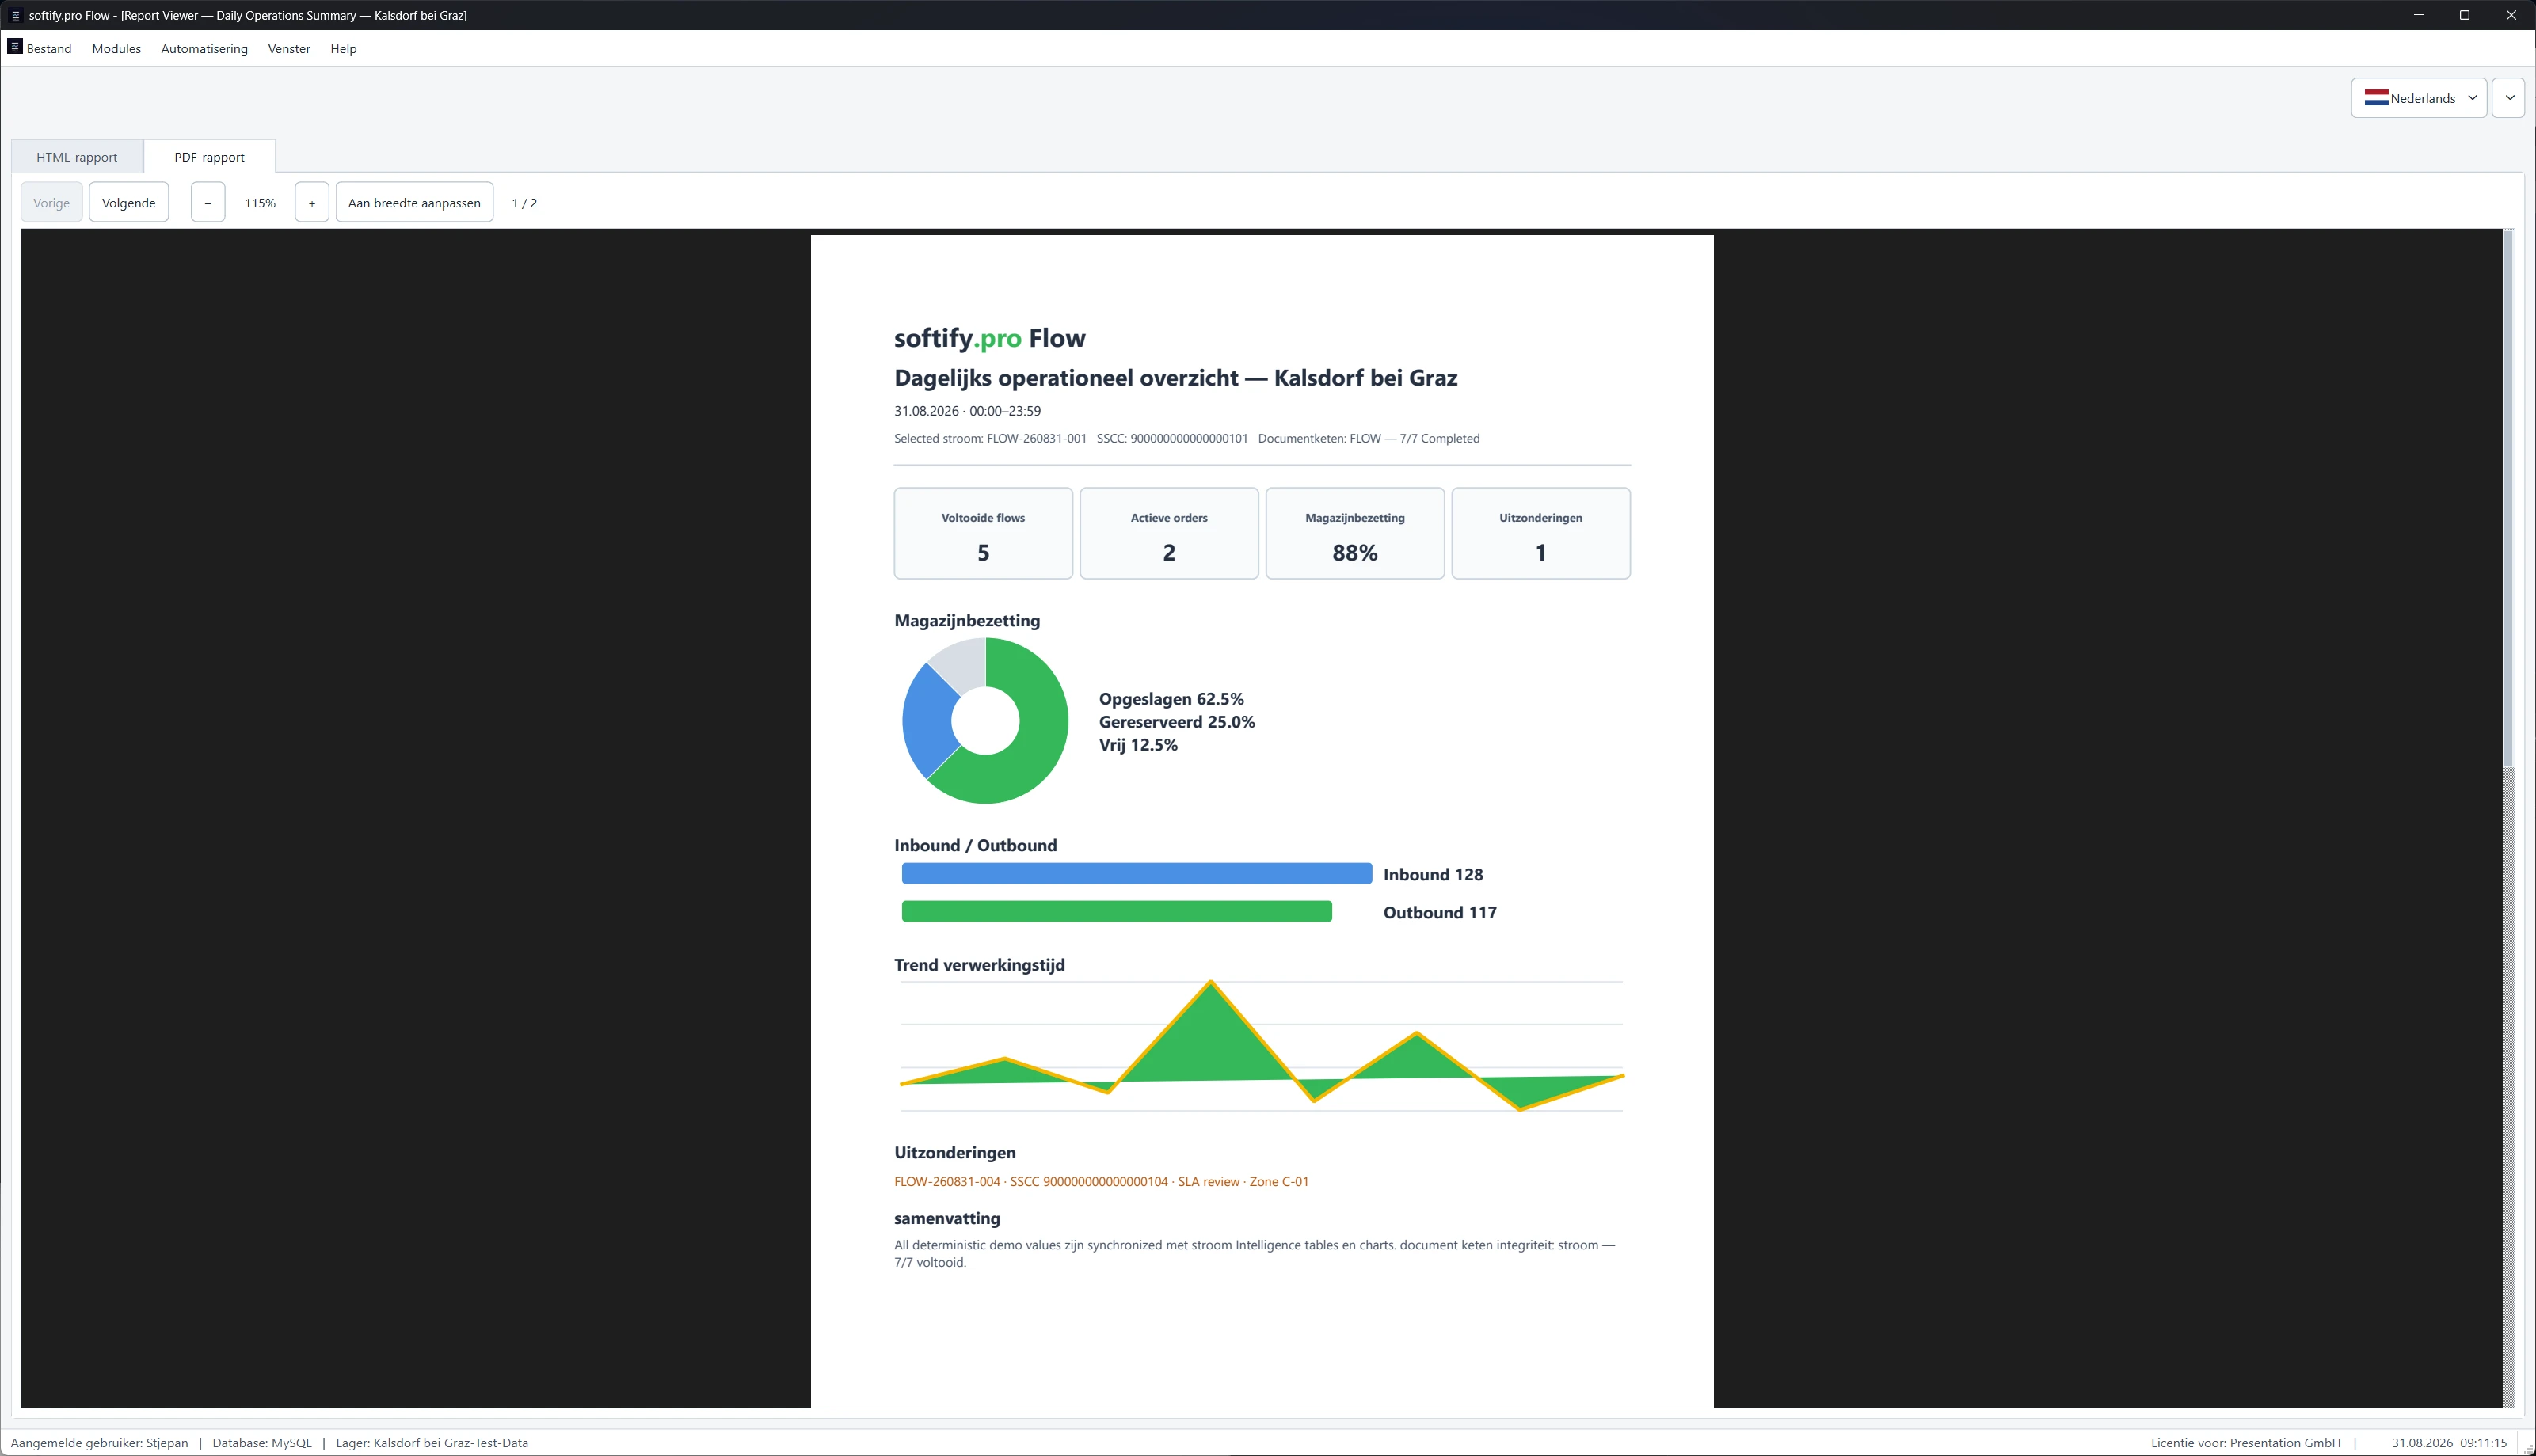
Resumen operativo diario.
Stock y ocupación.
Rendimiento de Flows.
Trazabilidad SSCC.
Excepciones y SLA.
La misma historia operativa volvió a aparecer.
Flows completados.
Pedidos activos.
Utilización del almacén.
Excepciones.
Entradas.
Salidas.
Tiempo de procesamiento.
Pero esta vez la pregunta no era si el informe parecía correcto.
La pregunta era:
¿Puede defenderse a sí mismo?
Un buen informe te da un número.
Un sistema mejor puede explicar de dónde viene ese número.

Reporting desde el mismo estado operativo — no una segunda versión de la realidad.

Flow.
Flow.
Flow.
Flow.


La excepción seguía ahí.
Uno de los detalles más discretos resultó ser uno de los más importantes.
Los datos de demostración contienen una excepción.
Aparece en Analytics.
Aparece en Drill-down.
Aparece en la trazabilidad SSCC.
Aparece en el Report Center.
Y sigue siendo visible en Exceptions & SLA.
Eso es exactamente lo que debería ocurrir.
Recuperarse operativamente de una excepción no significa que la excepción deba desaparecer del historial.
«El proceso continuó» y «no pasó nada» no son la misma afirmación.
En logística, esa diferencia importa.
Llegados a este punto teníamos un problema de pruebas.
No un problema de software.
Un problema de pruebas.
Ahora teníamos el mismo almacén representado como:

  • analítica,
  • Flows individuales,
  • historiales SSCC,
  • cadenas documentales,
  • informes,
  • y vistas de excepciones.

Cada uno podía probarse de forma independiente.
Abrir.
Hacer clic.
Filtrar.
Verificar.
Aprobar.
Siguiente.

Eso sería fácil.
También perdería la parte interesante.
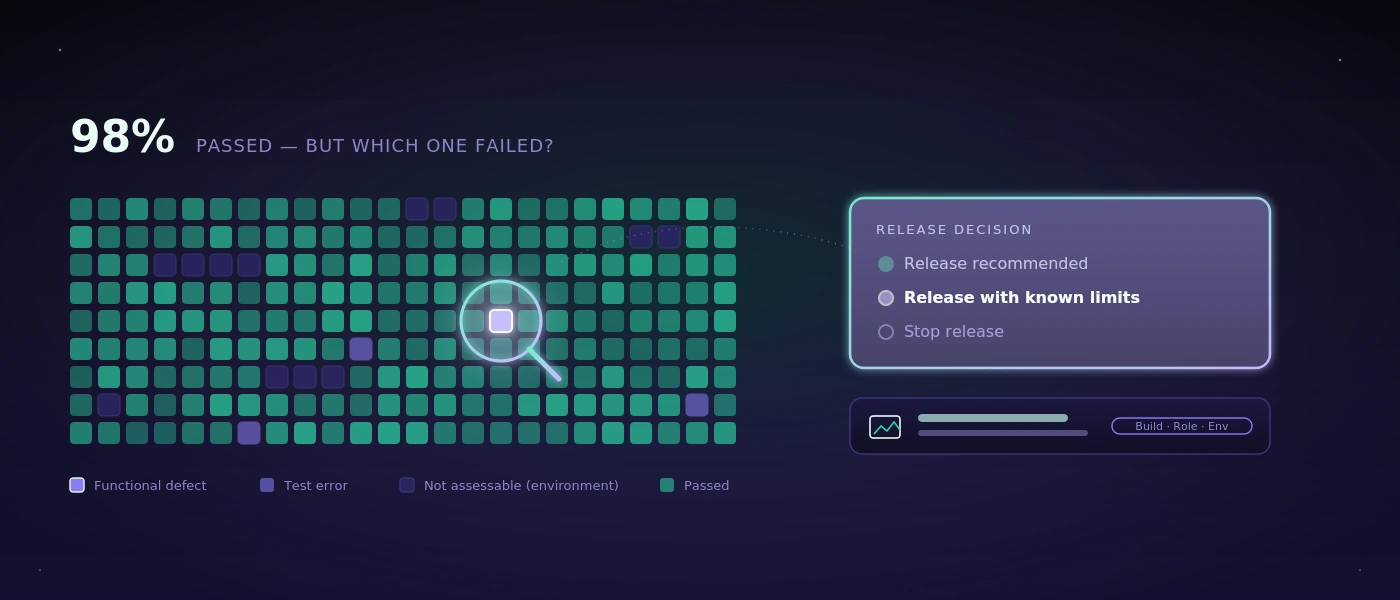
Porque seis marcas verdes no demuestran que seis vistas coincidan entre sí.
Entra COCO.
Otra vez.
COCO ya se había enfrentado antes a Flow.
Autenticación.
Usuarios.
Roles.
Entornos de base de datos.
Idiomas.
Ejecución de escritorio.
Luego llegó la logística.
Almacenes.
Inventario.
Picking.
Movimientos.
Excepciones.
Documentos.
Ubuntu.
Red Hat Enterprise Linux.
Esta vez le dimos a COCO algo ligeramente distinto.
No una pantalla que verificar.
Una historia que seguir.
Toma este almacén.
Toma este Flow.
Toma este SSCC.
Abre Analytics.
Abre Drill-down.
Cambia el idioma.
Vuelve a mirar.
Abre el informe.
Encuentra el mismo Flow.
Encuentra el mismo SSCC.
Encuentra la excepción.
Compara.
Luego vuelve a comparar.

COCO sigue el mismo contexto operativo a través de softify.pro Flow — analítica, trazabilidad, cambios de idioma y reporting.

Eso cambia la naturaleza de la prueba.

La pregunta ya no es:

  • ¿Funciona cada módulo?

Se convierte en:

  • ¿Creen todos los módulos que ha pasado lo mismo?

Una pregunta mucho mejor.
Mucho menos cómoda.
Un sistema de almacén debería tener una sola memoria.
Los operarios pueden ver posiciones.
Los responsables de almacén pueden ver KPI.
El soporte puede usar drill-down.
Los auditores pueden usar informes.
COCO puede verlos todos.
Pero bajo esas perspectivas, debería haber un único historial.
Un Flow no debería adquirir varias biografías según qué módulo esté abierto.
Un SSCC no debería tener varios pasados.
Una excepción no debería existir solo donde resulte conveniente.
Un almacén no debería convertirse en otro almacén porque cambió el idioma de la interfaz.
De eso trata realmente el actual experimento Flow.
No de paneles de control.
No de informes.
Ni siquiera de pantallas individuales.
De una sola verdad operativa, expresada de distintas maneras.
Control.
Conocer el almacén.
Conocer el estado.
Saber qué se está moviendo.
Saber a qué proceso pertenece.
Claridad.
Convertir los KPI de nuevo en registros.
Convertir los registros en historial.
Convertir las excepciones en evidencia.
Convertir un SSCC en algo trazable.
Flow.
Se selecciona un almacén.
Analytics empieza a describirlo.
Un Flow avanza.
El SSCC permanece vinculado.
Una cadena documental crece.
Aparece una excepción.
El proceso continúa.
El informe lo recuerda.
Luego cambia el idioma.
El almacén sigue siendo el mismo.
El Flow sigue siendo el mismo.
El historial sigue siendo el mismo.
Esa era la parte esperada.
Lo que ocurrió después fue más interesante.
COCO dejó de probar las vistas de forma independiente.
Empezó a compararlas.
Durante un tiempo, no pasó nada destacable.
Mismo almacén.
Mismo Flow.
Mismo SSCC.
Misma historia.
Otra vez.
Otra vez.
Otra vez.
Y entonces COCO se detuvo.
No porque la aplicación se hubiera bloqueado.
No lo había hecho.
No porque una prueba hubiera fallado en el sentido habitual.
No había sido así.
Se detuvo porque dos respuestas perfectamente razonables produjeron una tercera pregunta.

Sabemos cuál es la pregunta.
Flow sabe por qué existe.
COCO sabe dónde mirar a continuación.

El resto puede esperar.


Control. Clarity. Flow.

Publicado: 31.08.2026

Enlace permanente →

COCO vuelve a la carga

COCO vuelve a la carga

Probablemente deberíamos dejar de darle ideas a COCO.

El experimento anterior se suponía que iba a ser suficiente.

Una aplicación real.

Navegación real.

Usuarios.

Roles.

Bases de datos.

Idiomas.

Evidencia.

Un caso de estudio respetable.

Una conclusión limpia.

Entonces alguien lo mostró: Logistics in Motion.

Ese fue probablemente el error.

Empezó con tres almacenes

Nada particularmente emocionante.

…

Una carta de COCO

Una carta de COCO

Al ingeniero o ingeniera que abre este repositorio por primera vez:

Bienvenido.

Quizá hayas llegado porque algo falló.

Un servicio dejó de responder.

Un despliegue se comportó de forma inesperada.

Una alerta te despertó en mitad de la noche.

O tal vez simplemente sientes curiosidad por saber cómo funciona esta plataforma.

Sea lo que sea lo que te haya traído aquí,

debes saber que este proyecto se construyó exactamente para momentos como este.

No para eliminar los problemas difíciles.

Sino para hacer comprensibles los problemas difíciles.

Encontrarás código.

Encontrarás documentación.

Encontrarás especificaciones.

Pero, más importante aún,

…

Casos de éxito

softify.pro Flow — Probado por COCO

softify.pro Flow — Probado por COCO

21.08.2026

Control. Clarity. Flow.

Todo producto de software serio acaba desarrollando un segundo producto detrás del producto.

Puede que los clientes nunca lo vean. Puede que los visitantes nunca sepan que existe. Pero los administradores, operadores y desarrolladores dependen de él cada día.

Para softify.pro Flow, esa aplicación es Administration — la consola operativa responsable de gestionar usuarios, roles, niveles de acceso, estados de autenticación, entornos de base de datos y demás configuración que mantiene bajo control una instalación de Flow.

Su pantalla de inicio de sesión lleva tres palabras:
Control. Clarity. Flow.

Se eligieron originalmente para describir la experiencia que queríamos que tuvieran los administradores al operar el sistema.

Pero también describen sorprendentemente bien cómo creemos que debería probarse el software.

Eso convirtió a softify.pro Flow — Administration en un candidato obvio para una prueba real de COCO.
No una demostración de laboratorio.
No una colección de botones aislados preparados específicamente para una demo de IA.
Una aplicación de escritorio multiplataforma real, con lógica de aplicación real, múltiples ventanas, múltiples motores de base de datos, autenticación, permisos, localización y suficiente estado como para que las regresiones aparentemente pequeñas sean difíciles de detectar manualmente.

Para la demostración pública que se muestra aquí, COCO trabajó exclusivamente con datos de demostración generados. La aplicación estaba licenciada a la empresa ficticia Presentation GmbH, y no se usó ninguna información de clientes en producción, credenciales ni datos personales.

El objetivo era simple:
dejar que COCO abordara la aplicación como lo haría un tester y determinar si el flujo de trabajo administrativo completo sigue comportándose como el software afirma que lo hace.

The Challenge

A primera vista, probar una aplicación de administración parece sencillo.

Ábrela.
Inicia sesión.
Haz clic a través de varias ventanas.
Comprueba que todo se vea correcto.

Esa suposición cambia rápidamente a medida que la aplicación crece.

softify.pro Flow — Administration no es un único formulario estático. Es una colección de vistas operativas interconectadas dentro de una sola cáscara de aplicación.

Entre otras cosas, un administrador puede trabajar con:

  • cuentas de usuario
  • roles y niveles de acceso
  • información de autenticación
  • estado de autenticación de dos factores
  • información del sistema operativo
  • información de red e IP
  • configuración de la base de datos
  • opciones de ordenación y presentación
  • selección de idioma en vivo
  • información de la aplicación y de la licencia

La interfaz admite actualmente once idiomas. La aplicación también funciona con MySQL y PostgreSQL como motores de base de datos. Por separado, ninguna de estas funciones representa un problema de prueba inusual.

La dificultad surge de sus combinaciones.
Una tabla de usuarios puede funcionar correctamente en inglés pero mostrar un nombre de columna obsoleto en croata.
La ordenación puede funcionar correctamente conectada a MySQL pero comportarse de forma distinta tras cambiar a PostgreSQL.

Un cambio de idioma puede actualizar la mayoría de los elementos de la interfaz dejando un mensaje de estado sin traducir. La aplicación puede cambiar de base de datos con éxito pero conservar información obsoleta de la conexión anterior. Una nueva versión puede introducir una función mientras el diálogo "Acerca de" todavía describe la anterior. El programa no necesita bloquearse para que cualquiera de estas situaciones sea una regresión. De hecho, algunos de los defectos de software más molestos son precisamente aquellos en los que todo parece funcionar.

La aplicación arranca.
La ventana se abre.
El botón responde.
Pero algo por debajo ya no está del todo bien.
Por eso importa la prueba de regresión repetitiva.

Y es también exactamente el tipo de trabajo en el que las personas se van volviendo cada vez peores tras repetir la misma secuencia decenas de veces.

Why Manual Testing Becomes Expensive

Probar algo una vez es fácil.
Probarlo de forma fiable después de cada versión relevante es distinto.

Considera solo tres dimensiones: 11 idiomas de interfaz × 2 motores de base de datos × múltiples flujos de trabajo de la aplicación.

El número de combinaciones crece rápidamente.
Añade distintos roles de usuario, estados de autenticación, comportamiento de ordenación, cambios de configuración y entornos operativos, y la matriz de pruebas se vuelve demasiado grande para tratarla como una checklist manual ocasional.

Aquí es donde las pruebas de regresión a menudo empiezan a erosionarse.
No deliberadamente.
Se acerca una fecha límite de lanzamiento.
Alguien recuerda que la aplicación se probó la semana pasada.
Un desarrollador comprueba rápidamente la pantalla más importante.

El alemán funciona.
El inglés funciona.
MySQL funciona.
La suposición se convierte en:
"El resto probablemente está bien."

Normalmente lo está.
Hasta la versión en la que no lo está.
COCO existe en parte para eliminar esa suposición del proceso.

What COCO Actually Did

COCO inició softify.pro Flow — Administration desde un estado de aplicación en frío, sin depender de una pantalla previamente preparada ni de un flujo de trabajo posicionado manualmente.

La primera interacción fue la misma que se le presenta a un administrador humano: la ventana de inicio de sesión.

COCO identificó la interfaz de autenticación que contenía:

  • nombre de usuario
  • contraseña
  • código de autenticación de dos factores

y la línea situada justo debajo de la identidad softify.pro Flow:
Control. Clarity. Flow.

A partir de ahí, COCO continuó a través de una sesión de regresión definida. El objetivo no era simplemente determinar si la aplicación podía abrirse.

El objetivo era verificar si el estado de la aplicación permanecía internamente consistente mientras COCO interactuaba con ella.

Authentication Is Only the Beginning

Probar el inicio de sesión es uno de los candidatos más obvios para la automatización, pero una autenticación exitosa por sí sola dice muy poco sobre el resto de una aplicación de administración.

Una vez dentro, COCO se trasladó al entorno operativo real. Inspeccionó la interfaz de administración de usuarios y verificó que la información esperada estuviera presente.

Eso incluía datos como:

  • nombres de usuario
  • contraseñas enmascaradas
  • indicadores 2FA
  • roles asignados
  • información del sistema operativo
  • direcciones IP

COCO interactuó con la tabla en lugar de limitarse a observarla.
La lista de usuarios se ordenó por nombre de usuario.
Se inspeccionó el orden resultante.
Lo importante no era si al hacer clic en el encabezado de la columna se producía algún cambio visible.

COCO verificó que el estado resultante de la tabla coincidiera con la operación solicitada.

Esa distinción importa.
Una prueba funcional pregunta:
"¿Respondió el botón?"

Una prueba de regresión útil pregunta:
"¿Terminó la aplicación en el estado correcto?"

Testing the Database Boundary

softify.pro Flow admite más de un motor de base de datos.

Eso convierte el cambio de base de datos en una frontera de regresión especialmente importante.
COCO cambió el motor activo de MySQL a PostgreSQL.

Tras el cambio, volvió a inspeccionar la información de usuario.
La prueba buscaba algo más que una conexión exitosa.
Comprobó si la aplicación seguía presentando los registros esperados y si la información mostrada a través de la interfaz seguía siendo coherente.

COCO volvió a cambiar de vuelta después.

Este tipo de transición es fácil de subestimar.
La interfaz de usuario puede permanecer visualmente idéntica mientras la capa de almacenamiento subyacente cambia por completo.
Desde la perspectiva de un administrador, esa transición debería sentirse casi aburrida.
Los mismos usuarios deberían seguir siendo comprensibles.
Los mismos roles deberían seguir teniendo sentido.

El mismo comportamiento de la interfaz debería seguir aplicándose.

Esa continuidad aparentemente sin incidentes es exactamente lo que hay que demostrar.

Eleven Languages, One Application State

La localización es otra área en la que las pruebas superficiales son particularmente peligrosas.

Es relativamente fácil verificar que una aplicación pueda iniciarse en otro idioma.
Es mucho más valioso verificar qué sucede cuando el idioma cambia mientras la aplicación ya está en ejecución y manteniendo estado.

COCO cambió el idioma de la interfaz en vivo.

La sesión incluyó transiciones entre idiomas como:
alemán → inglés → croata
mientras la vista de administración permanecía activa.

COCO observó si los elementos de la interfaz cambiaban correctamente en su lugar:

  • encabezados de tabla
  • controles
  • botones
  • etiquetas
  • mensajes de estado

La tabla subyacente y el estado de la aplicación también tenían que sobrevivir a esa transición.
Esto importa porque el software multilingüe consiste en algo más que cadenas traducidas.
Los cambios de idioma pueden dejar al descubierto:

  • recursos olvidados
  • etiquetas obsoletas
  • problemas de maquetación
  • mensajes de estado sin traducir
  • problemas de codificación
  • reinicios de estado
  • problemas de recreación de controles

Una ventana que se ve correcta cuando se inicia directamente en croata puede seguir comportándose incorrectamente cuando el usuario cambia de alemán a croata durante una sesión activa.

Esa es la diferencia entre revisar una captura de pantalla y probar un flujo de trabajo.

Restoring Application State

COCO restauró posteriormente la configuración de ordenación predeterminada de la aplicación.

De nuevo, la prueba no terminó con el clic en sí.

Se evaluó el orden resultante y la confirmación presentada a través del área de estado de la aplicación. Este tipo de verificación puede parecer insignificante comparada con probar la autenticación o el acceso a la base de datos.

No lo es.

Las aplicaciones empresariales acumulan cientos de pequeñas transiciones de estado como estas.
Los usuarios dependen de ellas sin pensarlo conscientemente.
El software se siente fiable precisamente porque esas interacciones permanecen predecibles.
Las pruebas de regresión existen para proteger esa predictibilidad.

Testing the Information Around the Software

COCO también abrió el diálogo "Acerca de" de la aplicación.

¿Por qué probar una ventana Acerca de?

Porque la documentación del software empieza dentro del propio software.
El número de versión, la descripción de funciones y la información de licencia que se muestran al operador deberían corresponder a la aplicación que realmente se está ejecutando.

Una aplicación puede funcionar perfectamente y aun así mostrar información de versión obsoleta o describir capacidades que ya no corresponden a la versión.

Eso no hace que se bloquee una base de datos.
Hace algo más sutil:
reduce la confianza.

Para el software empresarial, la precisión operativa incluye estos detalles aparentemente pequeños. Por eso COCO también los comprobó.

Control.

La primera palabra del eslogan de softify.pro Flow es también el primer principio del entorno de pruebas.

Control significa saber qué se está probando, contra qué estado y con qué datos.

La demostración pública de COCO no utiliza registros de producción de clientes.

Se ejecuta con datos de demostración preparados deliberadamente, cuyo estado esperado se conoce.

Eso hace que los resultados sean reproducibles.

También significa que las diferencias entre ejecuciones de prueba pueden investigarse en lugar de descartarse como cambios aleatorios en datos de producción.

Más importante aún, COCO está diseñado como un sistema de pruebas de IA autoalojado.

La evidencia de pruebas, las capturas de pantalla de la aplicación y la información interna del flujo de trabajo pueden permanecer dentro de la infraestructura bajo el propio control del cliente u operador, en lugar de enviarse por defecto a un servicio en la nube de terceros ajeno.

Para las aplicaciones de negocio internas, eso no es simplemente una preferencia de infraestructura.
Puede ser parte del propio requisito de pruebas.

Clarity.

La automatización no resulta especialmente útil si su resultado final es: FAILED
seguido de cientos de líneas de salida técnica que alguien debe reconstruir manualmente antes de entender qué ocurrió.

COCO está diseñado para preservar un rastro de evidencia comprensible.

El informe describe:

  • qué se probó
  • qué interacción tuvo lugar
  • en qué secuencia ocurrió
  • qué observó COCO
  • qué estado se esperaba
  • dónde difirió el comportamiento cuando algo falló

Las capturas de pantalla y las pruebas de ejecución pueden acompañar esa secuencia.
El propósito no es ocultar los detalles técnicos.

Es hacer que el resultado sea comprensible antes de que alguien tenga que abrir un depurador.

Un ingeniero debería poder responder:
¿Qué pasó? antes de preguntar:
¿Dónde en el código ocurrió?

Esa distinción acorta drásticamente la investigación cuando aparece una regresión.

Flow.

La automatización de UI tradicional suele pensar en elementos.

Encontrar selector.
Hacer clic en el selector.
Encontrar otro selector.
Comprobar el valor.

Ese enfoque sigue siendo útil, pero las aplicaciones no se experimentan como colecciones de selectores.

Las personas experimentan flujos.

Iniciar sesión.
Abrir administración.
Encontrar un usuario.
Cambiar una configuración.
Cambiar de base de datos.
Cambiar de idioma.
Verificar el resultado.

Seguir trabajando.

Por eso COCO trata la secuencia como un proceso, no como una colección aleatoria de controles.

Sigue lo que el usuario intenta lograr y evalúa la aplicación en contexto.

Eso resulta especialmente valioso al probar software de negocio real, porque los fallos ocurren a menudo entre pantallas o entre estados, no dentro de un botón individual.

Un flujo logístico puede contener un pedido, una reserva de stock, una operación de picking, un albarán de entrega y una confirmación de envío.
Cada pantalla individual puede parecer correcta mientras el proceso completo está mal.
El mismo principio se aplica aquí a menor escala.
La ventana de administración no es el producto.

El flujo de trabajo a través de ella sí lo es.

Evidence Instead of Assumption

Uno de los trabajos más importantes de COCO no es hacer clic. Es recordar qué sucedió.
Las pruebas de regresión humanas suelen terminar con una afirmación como:
"Lo probé y todo parecía correcto."

Eso puede ser totalmente exacto.
Pero varias semanas después, cuando aparece un problema, las preguntas útiles son otras:

  • ¿Qué versión se probó?
  • ¿Qué base de datos?
  • ¿Qué idioma?
  • ¿Qué estado de usuario?
  • ¿Qué ocurrió antes del problema?
  • ¿Qué era exactamente visible?

¿En qué orden se realizaron las acciones?
Las ejecuciones de prueba de COCO están diseñadas para dejar evidencia.

Eso transforma un resultado de prueba de una opinión en algo que puede inspeccionarse.
Una ejecución exitosa se vuelve, por tanto, útil también.
Establece un estado de referencia conocido con el que se puede comparar el comportamiento posterior.

COCO Is Not the Decision Maker

Hay un límite importante en la forma en que usamos la IA para probar software.
COCO no pretende sustituir la responsabilidad de ingeniería.

No decide cómo debería ser una regla de negocio.

Prueba el comportamiento frente a escenarios, requisitos y expectativas definidos para la aplicación.
Para decisiones sensibles que implican permisos, precios, inventario, transacciones financieras u otros estados críticos del negocio, la definición del comportamiento correcto sigue siendo responsabilidad humana.

Esa distinción importa.
La IA es excelente repitiendo una prueba detallada sin perder concentración.
Es excelente recopilando evidencia.
Puede inspeccionar pantallas, comparar el comportamiento esperado con el observado y explicar discrepancias.
Pero es la empresa la que sigue definiendo qué significa correcto.

COCO hace que esa definición sea comprobable.

The Test Nobody Wants to Repeat

Hay una razón sencilla por la que la automatización aporta valor aquí.
Un tester humano puede, sin duda, realizar esta sesión de regresión.
El primer idioma recibe toda la atención.
Probablemente el segundo también.
Luego otro.
Luego otro más.
MySQL ya se ha comprobado.
PostgreSQL todavía queda por comprobar.
La prueba de ordenación ya se ha realizado varias veces.
El diálogo "Acerca de" no ha cambiado en meses.

Es viernes por la tarde.

Y la atención humana hace lo que la atención humana hace de forma natural.
Empieza a optimizar.
COCO no.
En el propio espíritu de COCO:

  • No me canso de hacer clic en el mismo botón en once idiomas. No me salto la pasada de PostgreSQL solo porque es viernes por la tarde. No doy por hecho que el orden de clasificación se mantuvo solo porque funcionó en la versión anterior.

Para COCO, cada sesión de regresión puede tratarse como si fuera la primera.
Eso no es inteligencia que sustituye a un tester humano.
Es automatización que protege al tester humano de la parte de las pruebas en la que la atención humana vale menos.

From Repetitive Testing to Engineering Evidence

El propósito más amplio de COCO no es maximizar el número de acciones automatizadas.
Mil clics automatizados no significan nada si nadie entiende qué demuestran. El resultado útil es la confianza respaldada por evidencia.

Para softify.pro Flow, eso significa poder decir que una versión se probó en las áreas operativas que importan:

  • autenticación
  • administración de usuarios
  • información de roles y accesos
  • estado de autenticación de dos factores
  • comportamiento de ordenación
  • funcionamiento con MySQL
  • funcionamiento con PostgreSQL
  • localización en vivo
  • retroalimentación de estado
  • información de la aplicación
  • información de licencia

y que el resultado se conserva en una forma que puede revisarse después.
El mismo principio se extiende mucho más allá de esta aplicación.
Un proceso de inicio de sesión puede probarse así.
Un flujo de reserva puede probarse así.
Un proceso logístico puede probarse así.
Una aplicación de escritorio multiplataforma puede probarse así.
Las pantallas cambian.
Las reglas de negocio cambian.
El principio no:
definir el flujo de trabajo esperado, ejecutarlo de forma consistente, recopilar evidencia y hacer el resultado comprensible.

Why We Test Our Own Software With COCO

Hay otra razón por la que softify.pro Flow importa como caso de estudio de COCO.

Es nuestro propio software.
Eso elimina la distancia cómoda que a veces existe entre una demostración tecnológica y las personas que la realizan.

Si COCO está destinado a probar software empresarial, tiene que ser lo bastante útil como para que confiemos en él con el software que nosotros mismos desarrollamos y publicamos.

Flow actúa, por tanto, tanto como producto como campo de pruebas.
Las nuevas capacidades de prueba pueden ejercitarse contra una aplicación real.
Un comportamiento inesperado puede revelar debilidades en la aplicación, en el plan de pruebas o en el propio COCO.

Cada lado mejora al otro.
Ese bucle de retroalimentación es mucho más valioso que construir demostraciones artificiales diseñadas solo para tener éxito. Un sistema de pruebas no debería parecer convincente porque la demostración fue fácil.
Debería volverse convincente porque sigue encontrando las pequeñas cosas que las personas acabarían dejando de comprobar.

The Result

softify.pro Flow — Administration cuenta ahora con un proceso de regresión documentado y repetible que COCO puede ejecutar antes de las versiones relevantes.

La prueba abarca ambos entornos de base de datos compatibles y la interfaz de once idiomas de la aplicación, siguiendo la aplicación tal como lo haría un administrador, en lugar de tratar cada pantalla como un objetivo de prueba aislado.

COCO produce un rastro de evidencia que muestra qué se probó, qué se observó y en qué orden transcurrió la sesión.

Esa evidencia puede permanecer bajo control local.
Los desarrolladores obtienen un punto de partida reproducible cuando algo cambia.
Los testers humanos dedican menos tiempo a repetir interacciones predecibles y más tiempo a investigar las situaciones que realmente requieren criterio.

Y softify.pro Flow recibe algo más valioso que un indicador verde de PASS.

Recibe la prueba de que la experiencia prometida en su pantalla de inicio de sesión sigue existiendo después de que cambia el código subyacente.

Control. Saber qué se está probando y mantener el entorno bajo control.

Clarity. Entender qué ocurrió sin tener que reconstruir un registro de automatización opaco.

Flow. Probar la aplicación como un proceso que la gente realmente usa.

Control. Clarity. Flow.

Se escribió para el software.
Resultó describir igual de bien la filosofía de pruebas que hay detrás.

Enlace permanente →

Curiosidades

Pure fluidity meets ultimate performance: qué hace realmente rápido al software empresarial

Pure fluidity meets ultimate performance: qué hace realmente rápido al software empresarial

Un jefe de almacén no reconoce un mal software por un dibujo de arquitectura. Lo reconoce porque los empleados vuelven a coger el teléfono, registran los albaranes dos veces o, tras un turno, no pueden decir qué mercancía ha llegado realmente. Pure fluidity meets ultimate performance no puede ser, por tanto, una mera aspiración visual. Para el software empresarial significa que una operación se siente natural y, al mismo tiempo, funciona de forma fiable en condiciones reales.

Una interfaz elegante no vale nada si se atasca con un WLAN débil en el almacén. Una aplicación rápida tampoco ayuda mucho si impone una secuencia de trabajo que nadie en la rampa puede seguir. Las buenas herramientas digitales combinan diseño, velocidad y comprensión de procesos. Reducen la fricción sin meter a la empresa en una lógica estándar prefabricada.

Pure fluidity meets ultimate performance es una cuestión operativa

La fluidez se confunde a menudo con animaciones, imágenes grandes y transiciones suaves. Eso puede encajar con una marca moderna. En el día a día de trabajo, sin embargo, se muestra de otro modo: una recepción de mercancías se puede contabilizar sin rodeos. Un empleado encuentra un pedido incluso cuando solo se conoce un número de referencia. Un error se nombra con claridad, en lugar de desaparecer en un mensaje críptico.

El rendimiento es igualmente más que un buen valor en una prueba de navegador. Lo decisivo es el tiempo de respuesta con un pedido de muchas posiciones, la estabilidad a fin de mes y la pregunta de si cinco personas pueden trabajar a la vez sin sobrescribirse mutuamente los estados de datos. También forma parte un manejo limpio de cortes de conexión, permisos y cuentas bloqueadas.

Ambos son inseparables. Si una pantalla reacciona al instante pero tiene campos obligatorios poco claros, sigue siendo agotadora. Si el flujo está modelado con inteligencia pero la página espera dos segundos en cada asiento, se rodea. La fluidez surge donde el sistema apoya la siguiente acción sensata y sigue siendo técnicamente lo bastante rápido para que el hilo del pensamiento no se rompa.

La interfaz sigue el camino de trabajo, no el organigrama

Muchas soluciones estándar estructuran sus menús por módulos: compras, ventas, almacén, informes, administración. Desde la perspectiva del producto es comprensible. En el suelo del almacén, sin embargo, el trabajo suele empezar con una situación: hay un camión esperando, falta un palé, un cliente necesita un comprobante de entrega o un envío debe etiquetarse todavía antes del cierre de recepción.

Una buena aplicación a medida empieza, por tanto, con estas situaciones. ¿Qué información hay? ¿Quién decide? ¿Qué hay que documentar? ¿Qué no debe modificarse después? Solo entonces se decide qué pantalla de entrada, comprobación o automatización hace falta.

Eso no significa volcar cada flujo existente sin cambios en software. Algunas tablas son realmente demasiado propensas a errores, algunas aprobaciones innecesariamente lentas. Pero una lista de Excel que funciona no tiene por qué sustituirse forzosamente por un proyecto. Si solo la mantiene una persona, conoce pocas excepciones y sigue siendo trazable, puede ser la herramienta adecuada. El software vale la pena cuando mejora la coordinación, reduce fuentes de error o pone la información a disposición de varios participantes de forma fiable.

Menos clics no es automáticamente mejor

La exigencia de los menos clics posibles suena razonable, pero puede conducir en la dirección equivocada. Para un asiento de almacén irreversible, una breve confirmación tiene sentido. Para una liberación de envío, una comprobación de plausibilidad visible puede evitar costosos retrabajos. El flujo correcto depende del riesgo.

Lo decisivo es que los pasos adicionales tengan un propósito claro. Una confirmación no debería aparecer solo porque el framework la genera con facilidad. Debería estar exactamente donde las personas deben tomar una decisión de forma consciente. Así la aplicación sigue siendo rápida sin volverse ligera.

El rendimiento surge en la arquitectura, no en el último sprint

Quien acelera un sitio web o una aplicación web solo poco antes del go-live suele tratar síntomas. Las consultas grandes, los modelos de datos poco claros y los casos especiales añadidos después no pueden corregirse de forma duradera con un único día de optimización.

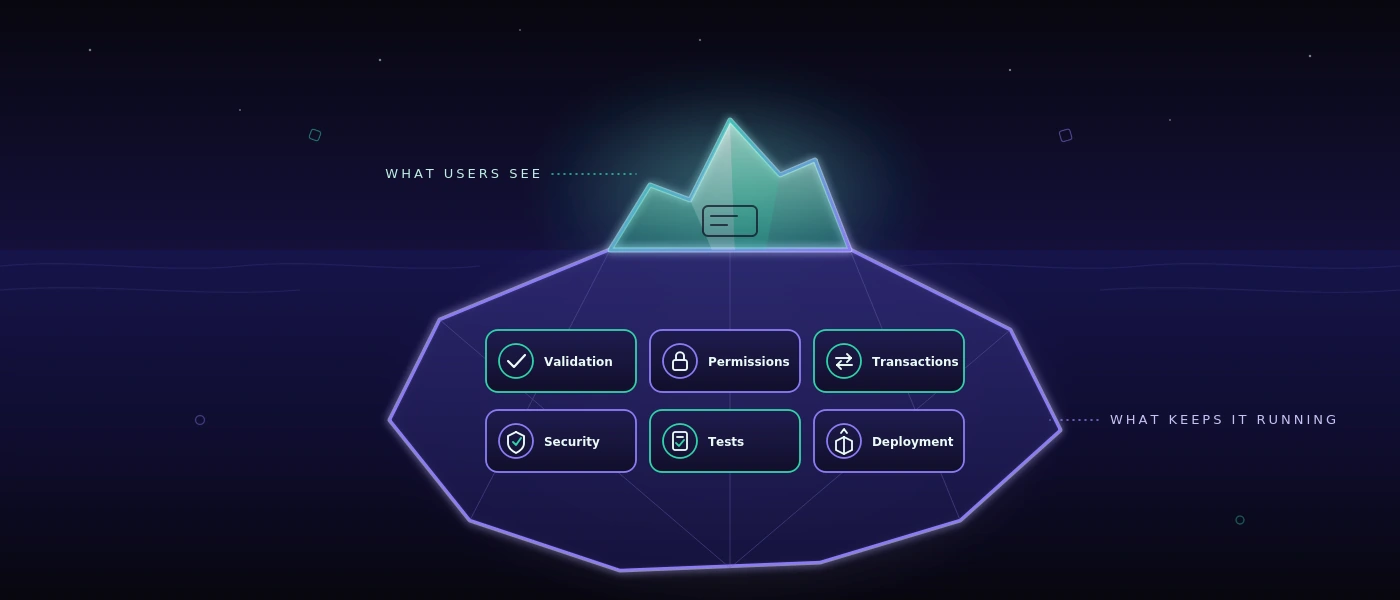
Una base sólida empieza con una base de datos que corresponda a las relaciones reales en la empresa. En MySQL 8, movimientos, documentos, cambios de estado y acciones de usuario necesitan claves trazables e índices sensatos. Una existencia no debe aparecer solo como número si luego hay que aclarar de qué asiento resulta. Al mismo tiempo, no hace falta recalcular cada información histórica en cada carga de página.

En las aplicaciones web modernas también es relevante la separación de responsabilidades. PHP 8.4 puede representar reglas de negocio de forma clara y mantenible, mientras que el JavaScript moderno se emplea de forma selectiva para áreas reactivas. Eso no es una profesión de fe en un stack determinado. Es una cuestión de mantenimiento: ¿pueden implementarse cambios con seguridad dentro de seis meses? ¿Se ve dónde rige una regla? ¿Puede reproducirse un error, en lugar de solo suponerse?

El rendimiento necesita además límites. Los campos de búsqueda necesitan un mínimo sensato de caracteres o una lógica de filtro precisa si son imaginables millones de registros. Las listas grandes necesitan páginas o procesos de carga escalonados. Imágenes y documentos no deberían bloquear el flujo de trabajo crítico. Estas decisiones parecen poco espectaculares. Justo por eso siguen siendo valiosas más tiempo que un efecto de frontend llamativo.

La velocidad visible genera confianza

No todo proceso puede terminar en menos de un segundo. Una impresión de etiquetas, una interfaz con el transportista o una comprobación frente a datos externos requiere a veces tiempo. Lo decisivo es entonces cómo maneja la aplicación la espera.

Un estado claro como «Se está creando la etiqueta de envío» es mejor que un botón congelado. Tras un cierre debería poder verse qué número se generó y si la operación puede volver a lanzarse. Si un servicio externo no está accesible, el equipo necesita una opción de actuación comprensible en lugar de un mensaje de error para desarrolladores.

Es también una cuestión de integridad de datos. Un doble clic no debe generar dos entregas. Un proceso interrumpido no debe dejar en silencio un registro a medias. Los buenos sistemas prevén estos casos, porque ocurrirán en el día a día. Especialmente con turnos cambiantes, presión de tiempo y dispositivos móviles, la excepción no es un tema marginal.

La calidad se hace visible antes del error

Para aplicaciones con muchas variantes de proceso no basta con recorrer manualmente unos cuantos caminos al final. Los cambios en precios, roles, validaciones o interfaces pueden desencadenar consecuencias en un lugar muy alejado. Aquí el testing automatizado se convierte en parte del rendimiento: no solo técnicamente, sino a nivel organizativo.

Un sistema de pruebas debería poder comprobar flujos reales, por ejemplo crear un pedido, modificar una posición, generar un albarán y controlar un permiso. Debería registrar evidencias y formular los resultados de modo que las áreas funcionales puedan interpretarlos. Una frase como «El proceso de envío no se completó tras el cambio de dirección» ayuda más que un stack trace sin comentarios.

Para los equipos preocupados por la seguridad también es relevante el lugar donde se ejecutan estas pruebas. Si capturas de pantalla, credenciales, casos de prueba o pasos internos de la aplicación no deben salir de la empresa, un enfoque autoalojado suele ser más sensato que un servicio cloud externo. Con COCO pueden ejecutarse pruebas automatizadas para aplicaciones web y Windows en un entorno dedicado. Eso no es necesario para todos los equipos. Con datos sensibles, ámbitos regulados o aplicaciones especializadas internas, el control sobre los datos de prueba puede ser, sin embargo, una ventaja decisiva.

El diseño es bueno cuando facilita el trabajo

Una identidad visual fuerte puede generar confianza. Muestra que una empresa se toma en serio su presencia digital. En el sistema operativo, sin embargo, el diseño debe hacer aún más: orientación bajo presión de tiempo. Contraste, tipografía, estados claros y rótulos comprensibles deciden si alguien completa una operación con seguridad o pregunta a un compañero.

La contención suele ser aquí la mejor opción. Un panel con diez indicadores de colores puede parecer impresionante y aun así ocultar la única desviación relevante. Una vista reducida que haga visibles recepciones de mercancías abiertas, escaneos que faltan y plazos de entrega en peligro es más útil. La pregunta no es cuánta interfaz es posible, sino qué información mejora una decisión.

Esto vale también para las aplicaciones responsivas. La capacidad móvil no significa comprimir cada pantalla de escritorio en un formato más pequeño. Un smartphone en la recepción de mercancías quizá solo necesite escaneo, cantidad, ubicación y confirmación. El posprocesamiento detallado pertenece quizá a una pantalla mayor. Dispositivos distintos merecen prioridades distintas, aunque accedan a la misma base de datos fiable.

Una vara de medir sensata para la próxima decisión

Antes de que un equipo decida una nueva plataforma, una automatización o una reconstrucción completa, ayuda una comprobación sencilla: ¿se vuelve el flujo más claro, rápido o seguro para las personas que lo ejecutan a diario? ¿Y sigue pudiendo entenderse la solución cuando cambian requisitos, empleados o interfaces?

Si ambas respuestas son sólidas, una bonita promesa se convierte en un sistema utilizable. Entonces pure fluidity meets ultimate performance se muestra no en una diapositiva, sino en una jornada de trabajo tranquila en la que pedidos, datos y decisiones siguen adelante sin fricción innecesaria.
Enlace permanente →

SaaS Flow Web: implantar workflows con seguridad con la operativa en marcha

SaaS Flow Web: implantar workflows con seguridad con la operativa en marcha

Una recepción de mercancías no se queda parada porque un equipo no conozca otro software más. Se queda parada porque la información se pierde entre correo electrónico, formulario en papel, archivo de Excel y llamada telefónica. Con el SaaS - «Flow Web» en flow.softify.pro - la primera pregunta no debería ser, por tanto, la interfaz. Lo decisivo es si el servicio reproduce de forma fiable un flujo de trabajo concreto - también en días agitados, con responsabilidades cambiantes y cuando una entrega no se ajusta al plan.

Para las pequeñas y medianas empresas, el SaaS suele tener sentido porque no tienen que construir primero sus propios servidores, versiones y funciones básicas. Pero eso no es un cheque en blanco para cualquier proceso. Quien introduce una herramienta que complica el día a día o desplaza datos importantes a listas secundarias poco claras no digitaliza el trabajo. Solo traslada la fricción.

Qué debe ofrecer el SaaS «Flow Web»

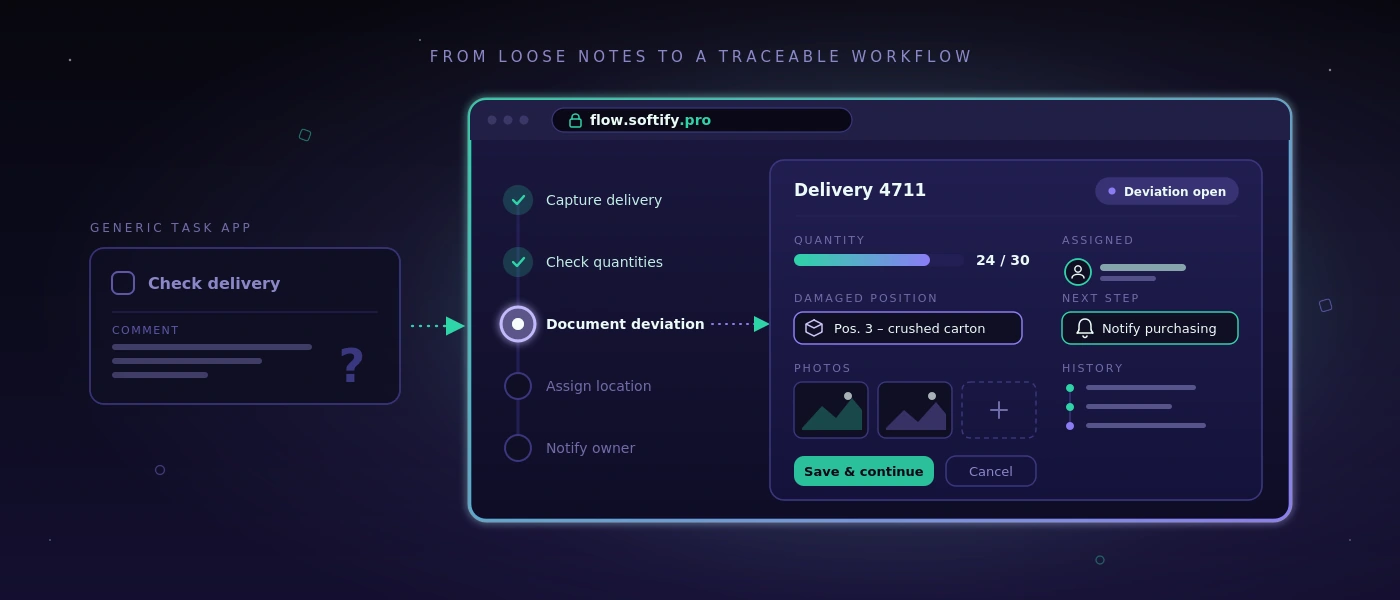
Un workflow web es bueno cuando los empleados saben sin interpretación qué hay que hacer a continuación. En una recepción de mercancías eso puede significar: registrar la entrega, comprobar cantidades frente al pedido, documentar la desviación, asignar una ubicación y, si hace falta, informar a un responsable. El flujo no tiene que ser espectacular. Tiene que ser trazable, rápido y repetible.

Justo aquí está la diferencia entre una aplicación general de tareas y un sistema de procesos especializado. Una aplicación de tareas puede crear un punto llamado «Comprobar entrega». Un workflow especializado puede además anotar de qué entrega se trata, quién la recibió, qué posición estaba dañada, qué fotos hay y si queda pendiente una entrega posterior. Esos datos no están entonces como texto libre en un único comentario, sino donde la siguiente persona los necesita.

Para una solución como Flow Web en flow.softify.pro, la evaluación debería empezar por las operaciones, no por una lista de funciones. Una empresa con cinco movimientos de almacén al día necesita algo distinto a un equipo de envíos con varias horas de corte, diferentes transportistas y gestión regular de entregas parciales. El SaaS no sustituye la comprensión del proceso.

Primero nombrar el cuello de botella, luego configurar

Muchos proyectos de digitalización empiezan demasiado amplios: «Queremos digitalizar el almacén.» Suena plausible, pero lleva rápido a un sistema con demasiadas pantallas, casos especiales y documentos de formación. Mejor una afirmación precisa como: «Las recepciones de mercancías solo se contabilizan al día siguiente, porque los albaranes quedan en el escritorio al final del turno.»

De una frase así puede derivarse un comienzo sensato. La primera versión puede registrar albaranes, confirmar artículos y cantidades, marcar desviaciones y pasar el asiento al área responsable. Cuando este flujo funciona, etiquetas, valoraciones de proveedores o propuestas de pedido automáticas pueden añadirse más tarde. No todo paso de ampliación sensato pertenece al primer despliegue.

También una tabla bien mantenida puede quedarse si cumple su propósito. Por ejemplo, un informe mensual con pocos participantes en un archivo existente puede ser más barato y transparente que un módulo propio. El SaaS compensa donde la información se usa varias veces, los tiempos de tramitación son críticos o los errores surgen de rupturas de soporte.

Las preguntas correctas antes de la implantación

Antes de la configuración, un equipo debería recorrer una operación real de principio a fin. No el proceso ideal, sino el caso que da problemas en el día a día: cantidad errónea, referencia ausente, envío urgente o un pedido con aprobación especial. Así se ven las reglas que un sistema debe reproducir realmente.

Son relevantes, entre otros, estos puntos: ¿quién puede crear, modificar o cerrar una operación? ¿Qué entradas son obligatorias y cuáles solo útiles? ¿Cuándo hay que informar a un responsable? ¿Qué datos se pasan a contabilidad, envíos o atención al cliente? ¿Y qué ocurre si el WLAN del almacén es débil o un empleado ya no tiene sus credenciales?

Las respuestas determinan la calidad de la implantación con más fuerza que un largo catálogo de requisitos visuales. Un proceso de roles limpio, un mensaje de error comprensible y un paso de aprobación documentado evitan en la operación normalmente más esfuerzo que un informe adicional en la página de inicio.

La conservación de datos y los roles no son un detalle

El SaaS se trata a menudo como una mera cuestión de manejo. Para los responsables de operaciones y de TI, sin embargo, es al menos igual de importante qué ocurre con los datos. Eso afecta a datos maestros, información de entrega, datos de empleados, fotos de daños y posiblemente datos de clientes. Antes de la implantación deberían estar claras las responsabilidades, la conservación y las posibilidades de exportación.

En la práctica significa: la empresa debe saber qué datos hay en el sistema, quién tiene acceso administrativo y cómo se ponen a disposición los datos en caso de cambio o fin de contrato. Una exportación disponible solo como archivo PDF difícil de leer rara vez ayuda. Para los datos operativos son decisivos formatos estructurados y utilizables.

También el concepto de permisos merece atención concreta. En el almacén no todas las personas necesitan ver precios, condiciones de clientes o ajustes globales. Al mismo tiempo, una asignación de derechos demasiado estrecha no debe bloquear el flujo. Tienen sentido roles alineados con las actividades reales: recepción, planificación, envíos, jefatura de equipo y administración. Los cambios críticos deberían ser trazables, para que, ante consultas, no haya que adivinar quién modificó un asiento.

El acceso en sí debería protegerse con bases sólidas. Eso incluye políticas de contraseñas seguras, un restablecimiento de contraseña regulado, bloqueo de cuenta tras intentos fallidos repetidos y, donde el perfil de riesgo lo exija, pasos de inicio de sesión adicionales. La seguridad resulta profesional cuando es previsible y no se nota solo cuando alguien ha quedado excluido.

Integración solo donde alivia de forma medible

Un workflow web suele desplegar su valor solo en interacción con sistemas existentes. Puede ser un ERP, una tienda, una solución de envíos, un control horario o una base de datos. Aun así, no toda interfaz es automáticamente sensata. Cada integración crea dependencias, cuadros de error y esfuerzo de mantenimiento.

La pregunta central es: ¿qué paso manual elimina concretamente la conexión? Si una interfaz ahorra cada día 30 minutos de trabajo de traspaso y reduce errores de tecleo, el beneficio es claro. Si solo refleja una información que de todos modos se comprueba una vez por semana, una exportación manual puede ser al principio la solución más razonable.

En las ampliaciones individuales cuenta la base técnica. Interfaces documentadas, campos de datos claramente definidos y registros de errores trazables facilitan la operación posterior. Si un sistema se conecta a una aplicación web a medida, las tecnologías y la estructura de la base de datos deberían elegirse de modo que sigan siendo mantenibles a largo plazo. Una aplicación cuidada basada en PHP 8.4, JavaScript moderno y MySQL 8 vale más que una solución especial impresionante a corto plazo pero sin documentación.

Implantación con la operativa en marcha

El error más frecuente es un arranque brusco sin fase de comparación. Los equipos tienen entonces que trabajar de otro modo ya el lunes por la mañana, mientras las preguntas abiertas solo surgen de problemas reales. Eso aumenta el rechazo, incluso si el software encaja en principio.

Mejor es un piloto limitado con un equipo, una variante de proceso o un área de sede claramente definida. En ese tiempo se comprueba si el registro y las aprobaciones funcionan, si los términos son comprensibles y si los casos excepcionales terminan limpiamente. Es importante no recoger las respuestas solo como lista de deseos. Cada cambio debería contrastarse con el beneficio para el tiempo de paso, la tasa de errores o la transparencia.

También los indicadores deberían fijarse pronto. Por ejemplo, pueden observarse el tiempo de tramitación por recepción de mercancías, el número de desviaciones abiertas, las consultas sobre el estado de entrega o los asientos de corrección. Sin valor de partida, «parece más rápido» sigue siendo la única valoración. Puede ser cierto, pero no basta para una decisión de inversión sólida.

La operación necesita un responsable claro

El SaaS reduce el esfuerzo técnico, pero no libera a una empresa de la responsabilidad por su propio proceso. Internamente hace falta alguien que gestione roles, reúna respuestas, detecte necesidades de formación y decida qué cambios son realmente necesarios. Esta persona no tiene que saber programar. Pero debería entender el flujo de trabajo y tener acceso a los responsables.

Igual de importante es una documentación operativa breve y sólida. No explica cada pantalla, sino que responde a las preguntas que surgen en el día a día: ¿qué hacer ante un asiento erróneo? ¿Quién aprueba nuevos usuarios? ¿Cómo se comunica una caída? ¿Dónde están los datos exportados? Tal claridad evita que un sistema digital vuelva a depender, tras pocos meses, de avisos personales.

Una buena solución SaaS no se reconoce, por tanto, por cuántas entradas de menú ofrece. Muestra su valor cuando una nueva compañera puede tramitar una operación con seguridad, una desviación no desaparece y un responsable ve el estado sin llamar a tres personas. Flow Web debería medirse precisamente con esta vara: no por promesas, sino por una jornada laboral que transcurre demostrablemente más tranquila y fiable.

Enlace permanente →

Desarrollo web con frameworks actuales: lo que las empresas ganan de verdad

Desarrollo web con frameworks actuales: lo que las empresas ganan de verdad

Si una recepción de mercancías todavía oscila entre formulario en papel, llamada telefónica y tres archivos de Excel, un frontend moderno por sí solo no resuelve el problema. El desarrollo web con frameworks actuales tiene sentido cuando simplifica visiblemente los flujos: los empleados ven el siguiente paso, los datos se registran una sola vez y la aplicación sigue siendo comprensiblemente mantenible incluso después del primer go-live.

Para las pequeñas y medianas empresas, la cuestión del framework no es, por tanto, una cuestión de fe. Lo decisivo no es si una interfaz lleva especialmente muchas palabras técnicas de moda. Lo decisivo es si los movimientos de almacén, pedidos, controles o aprobaciones recorren la jornada laboral de forma fiable - también bajo presión de tiempo, cambios de turno y una conexión de red fluctuante.

Los frameworks son un medio, no un objetivo de proyecto

Un framework ofrece una estructura probada para tareas recurrentes: enrutamiento, formularios, gestión de permisos, acceso a datos, pruebas y la representación de interfaces. Eso no reduce automáticamente todos los riesgos. Pero evita que un proyecto tenga que reinventar una y otra vez las funciones básicas.

En una aplicación web a medida, un framework JavaScript moderno puede, por ejemplo, representar de forma sensata pantallas interactivas: una lista de picking que actualiza continuamente las posiciones, una planificación de rutas con cambios de estado claros o un acta de inspección que asigna fotos y comentarios directamente a una operación. En el backend, frameworks PHP consolidados aportan reglas trazables, responsabilidades claramente separadas e interfaces coherentes con la base de datos.

Esto es especialmente relevante cuando una solución inicialmente pequeña se convierte en un sistema operativo de uso diario para un proceso. Una pantalla de entrada para avisos de entrega puede empezar de forma manejable. En cuanto actualiza existencias, emite etiquetas, tiene en cuenta roles y se comunica con un transportista, necesita una base técnica limpia. Los frameworks ayudan a no renegociar esa base con cada ampliación.

Qué hacen concretamente mejor los frameworks web actuales

El valor de los frameworks modernos rara vez está en efectos espectaculares. Se muestra en las partes invisibles de una aplicación. Los formularios pueden comprobar las entradas directamente, sin que los datos erróneos se noten solo tras el envío. Los permisos pueden definirse de forma central, de modo que un conductor vea otra información que la planificación. Los cambios en un pedido se guardan de forma trazable, en lugar de sobrescribir silenciosamente una celda de tabla.

En el lado del servidor, un entorno actual con PHP 8.4 y MySQL 8 crea una base sólida para lógica crítica para el negocio. Las transacciones de base de datos evitan, por ejemplo, que se reduzca una existencia mientras falla el asiento correspondiente. Claves únicas y reglas de validación evitan duplicados. Los procesos en segundo plano pueden generar documentos o consultar interfaces sin que la persona ante la pantalla tenga que esperar.

Tampoco la seguridad es una función que se añada después. Un framework actual admite almacenamiento seguro de contraseñas, protección frente a los ataques típicos por entrada, sesiones trazables y flujos de bloqueo de cuenta definidos. Aun así, la implementación sigue siendo una tarea de proyecto: los permisos deben modelarse correctamente desde el punto de vista funcional y las funciones sensibles requieren comprobaciones adicionales. Un framework ofrece barandillas, pero no sabe quién en la empresa puede conceder qué aprobación.

Decidir bien sobre el desarrollo web con frameworks actuales

La mejor tecnología no surge de una lista de herramientas populares, sino del uso real. Una aplicación interna para diez personas tiene otros requisitos que un portal de clientes con varios miles de accesos simultáneos. Un terminal de almacén con escáner necesita otra lógica de manejo que un informe de dirección en el escritorio.

Por eso una decisión sensata empieza con preguntas concretas: ¿qué operaciones cuestan hoy tiempo de forma medible? ¿Qué datos se transfieren varias veces? ¿Dónde surgen errores porque la información se hace visible demasiado tarde? ¿Qué tabla existente funciona lo bastante bien y debería quedarse por ahora? Precisamente este último punto protege de proyectos de digitalización caros sin beneficio operativo.

Para muchas aplicaciones empresariales a medida, un sistema renderizado en el servidor con componentes interactivos específicos es la elección más razonable. Carga rápido, es manejable de operar y evita complejidad innecesaria. Una aplicación de página única totalmente desacoplada puede, en cambio, ser adecuada cuando la interfaz procesa muchísimos estados dinámicos, tiene que funcionar offline o más adelante debe ofrecer las mismas funciones también a una app móvil.

Ambas pueden ser correctas desde el punto de vista funcional. La pregunta no es: ¿qué framework es el más moderno? Es: ¿qué arquitectura seguirá siendo ampliable con seguridad, comprobable y comprensible para el propio equipo dentro de dos años?

Cuándo menos técnica es la mejor técnica

No todo proceso necesita un frontend complejo. Una pantalla de entrada sencilla para pedidos internos puede ser más rápida, más estable y más barata que una interfaz animada con esmero. Si un archivo de Excel se mantiene solo una vez al mes y no causa errores, quizá siga siendo la herramienta adecuada.

La complejidad solo vale la pena cuando elimina una fricción real. Puede ser el caso cuando los pedidos se vuelven a teclear varias veces, el estado de entrega debe consultarse por teléfono o nadie está seguro de qué versión de un documento es la válida. Entonces una aplicación central crea un beneficio claro: un solo estado de datos, responsabilidades inequívocas y menos consultas.

La mantenibilidad empieza antes de la primera línea de código

Los frameworks suelen verse como aceleradores. Eso solo es cierto si las reglas de negocio están antes suficientemente claras. Un desarrollador puede construir una máquina de estados de forma técnicamente limpia. Pero si la secuencia de estados encaja realmente con el proceso se decide en el levantamiento: ¿cuándo se considera recibida la mercancía? ¿Quién puede cerrar una desviación? ¿Qué ocurre con una entrega parcial?

Estas decisiones deben documentarse, igual que interfaces, campos de datos y excepciones. Eso no hace los proyectos más lentos. Reduce discusiones posteriores, porque se hace visible qué regla se implementó deliberadamente y qué supuesto sigue abierto.

La mantenibilidad se muestra también en pequeñas disciplinas. Los cambios en la base de datos deben versionarse. Los pasos de despliegue deben documentarse. Los mensajes de error deben ser aprovechables para operación y desarrollo sin revelar detalles confidenciales. Las pruebas automatizadas comprueban en cada cambio los flujos centrales, por ejemplo la creación de un pedido, el cálculo de una cantidad o la emisión de un albarán.

En aplicaciones críticas no basta un solo tipo de prueba. Las pruebas unitarias aseguran reglas individuales, las pruebas de integración comprueban la interacción con la base de datos y las interfaces, y las pruebas de extremo a extremo reproducen en el navegador recorridos de uso reales. Para aplicaciones web y Windows, un entorno de pruebas autoalojado puede además aportar capturas de pantalla, registros de ejecución y valoraciones comprensibles, sin entregar innecesariamente datos de prueba internos a servicios cloud externos.

El rendimiento surge de la arquitectura y el modelo de datos

Una interfaz moderna no se vuelve rápida porque use un framework actual. Las consultas lentas a la base de datos, las imágenes sobredimensionadas o las interfaces poco claras siguen siendo lentas, independientemente del frontend. Especialmente con listas de pedidos, artículos o datos de movimiento, es el modelo de datos el que decide la velocidad percibida.

Índices limpios en MySQL 8, consultas paginadas y datos cargados de forma consciente suelen ser más eficaces que una optimización posterior de la interfaz. Igual de importante es un concepto claro de caché. Los datos maestros pueden, en ciertas circunstancias, almacenarse en caché; las existencias actuales o el estado de aprobación, en cambio, no a ciegas. Aquí no hay una regla general, porque el significado funcional de los datos determina cuán actuales deben ser.

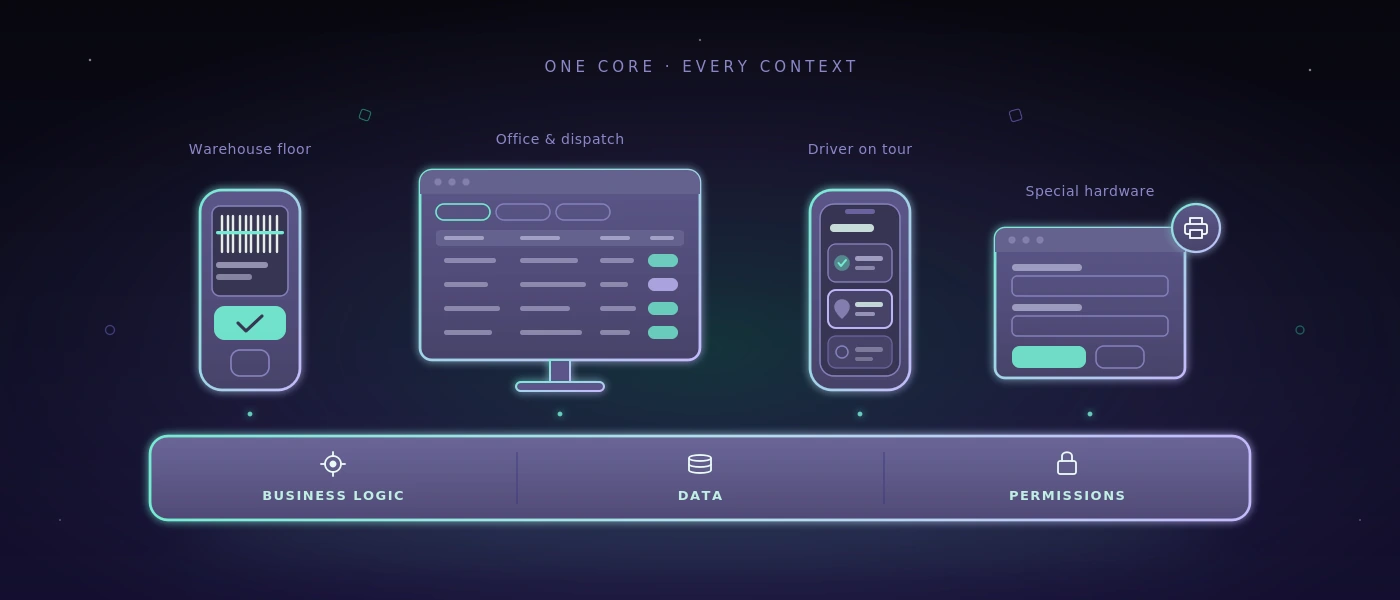
El diseño responsive también forma parte de la planificación técnica. En la pantalla de oficina puede tener sentido una tabla ancha. En un escáner de mano o una tableta en el almacén, la misma información necesita grandes áreas táctiles, recorridos cortos y una presentación que siga siendo manejable incluso con guantes o con poca luz. Pure fluidity meets ultimate performance no significa en este contexto el mayor movimiento posible en pantalla. Significa que la aplicación funciona sin fricción en el dispositivo que realmente se usa en el proceso.

El camino sensato de la idea a la operación

Un proyecto web sólido empieza con un núcleo limitado y comprobable. En lugar de automatizar de antemano cada excepción imaginable, se elige un proceso que ocurre con frecuencia y causa un esfuerzo notable. Tras el primer uso, datos y respuestas reales muestran qué ampliación tiene realmente la siguiente prioridad.

La entrega técnica no debería tener lugar solo al final. Las responsabilidades de hosting, copias de seguridad, monitorización, actualizaciones y derechos de acceso deben aclararse pronto. Un sistema es tan fiable como su operación. Quien necesita una aplicación a diario para el envío o la tramitación de pedidos necesita vías de recuperación definidas y una respuesta clara a lo que ocurre en caso de incidencia.

softify.pro apuesta por ello por tecnologías mantenibles, entrega documentada y responsabilidad técnica directa en lugar de modas pasajeras de frameworks. Eso no es un atajo mágico. Crea la condición para que una aplicación siga funcionando tras el lanzamiento, pueda seguir desarrollándose y no se convierta en el siguiente caso especial frágil.

En el mejor de los casos, la aplicación web adecuada no se siente como un nuevo proyecto de TI. Se siente como un flujo que por fin funciona sin rodeos - con suficiente sustancia técnica para acoger con calma también el siguiente cambio en la operativa.

Enlace permanente →

Planificar un despliegue de software: cómo implantarlo con la operativa en marcha

Planificar un despliegue de software: cómo implantarlo con la operativa en marcha

Un sistema nuevo rara vez fracasa porque falte un botón. Fracasa el lunes por la mañana: el turno de mañana no encuentra la recepción de mercancías, un albarán se imprime dos veces o un archivo de Excel se convierte de repente en la verdad no oficial. Quien quiera planificar un despliegue de software debe, por tanto, no solo introducir funciones, sino asegurar la operativa real.

Precisamente en el almacén, el taller, la planificación y la administración, un despliegue no es una cita de TI. Cambia gestos, responsabilidades y vías de información. Una buena implantación mantiene el trabajo en movimiento, hace visibles los errores pronto y da a los empleados una respuesta clara a la pregunta decisiva: ¿qué hago de forma distinta a partir de mañana?

El despliegue comienza antes de la primera formación

Muchos proyectos empiezan con una lista de funciones: registrar pedidos, contabilizar movimientos de almacén, imprimir etiquetas de envío, planificar rutas. Es necesario, pero no basta. Antes del inicio debe estar claro qué procesos deben pasar realmente por el nuevo sistema el primer día productivo - y cuáles deliberadamente todavía no.

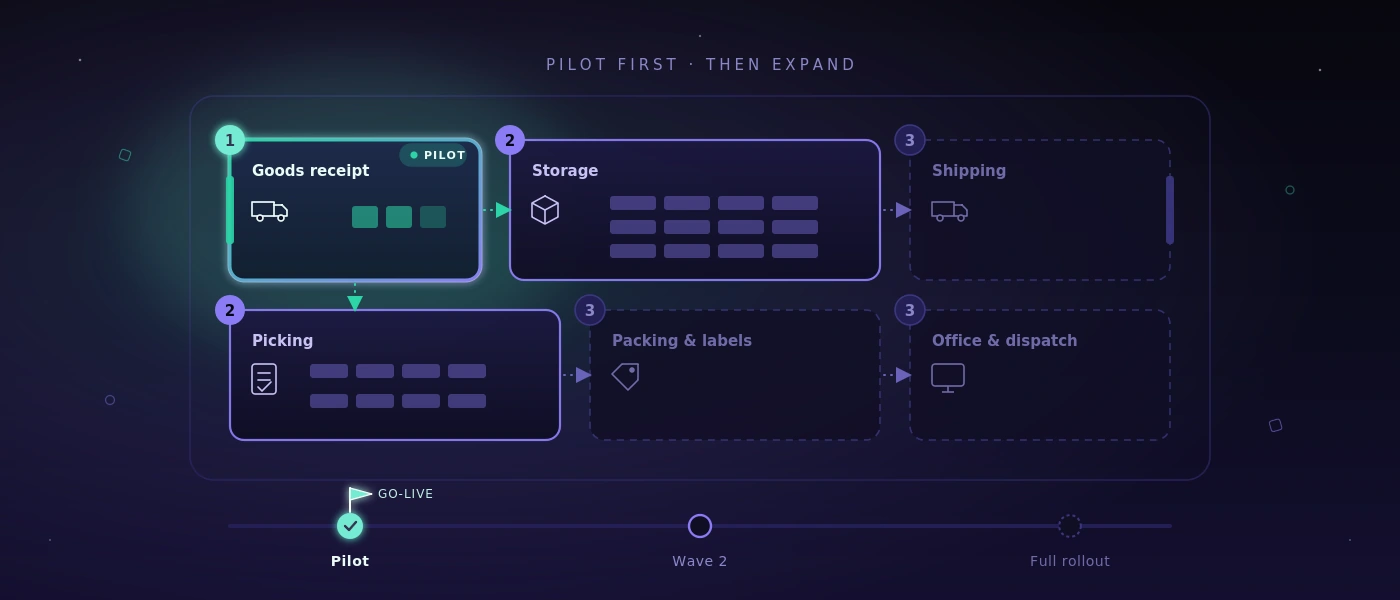
Esta delimitación no es señal de incompletitud. Reduce el riesgo. Si una empresa mediana ha coordinado hasta ahora las recepciones de mercancías mediante papel, teléfono y tablas, no tiene por qué digitalizar el primer día también toda la gestión de existencias, la tramitación de devoluciones, la planificación de rutas y la evaluación de proveedores. Un primer alcance sensato podría estar en la recepción de mercancías, movimientos de almacén inequívocos y la impresión de documentos de entrega.

Lo decisivo es describir el proceso objetivo de forma concreta. No: «La recepción de mercancías se vuelve digital.» Sino: «El empleado escanea la entrega, comprueba cantidad y estado, asigna una ubicación y, en caso de desviaciones, crea una operación para compras.» Solo a este nivel se hacen visibles las preguntas abiertas: ¿qué ocurre si falta el pedido? ¿Quién puede corregir cantidades? ¿Puede almacenarse una entrega sin etiqueta?

Planificar un despliegue de software significa: priorizar los flujos críticos

No todos los procesos tienen el mismo peso. Una caída en el mantenimiento de datos maestros puede ser desagradable. Una caída en el envío, el picking o la aprobación de facturas puede bloquear el trabajo de un día entero. Por eso el despliegue necesita una priorización según el riesgo operativo, no según el orden del pliego de condiciones.

Una clasificación sencilla ha dado buen resultado: crítico para el negocio, importante y aplazable. Son críticos todos los flujos que mueven mercancía, dinero o comunicación vinculante con clientes. Son importantes las funciones que aceleran el día a día, pero cuya caída puede amortiguarse manualmente de forma transitoria. Son aplazables las funciones de comodidad, los casos especiales raros o los análisis que al principio pueden seguir procediendo de una fuente existente.

Esta clasificación influye en la profundidad de las pruebas. Para un proceso de envío crítico no basta con recorrer con éxito un solo pedido. También hay que probar entregas parciales, anulaciones, impresoras ausentes, direcciones erróneas, procesamiento paralelo y la entrega al transportista. Para una función estadística poco usada puede ser adecuado un ciclo de pruebas posterior.

Hacer medibles de antemano los criterios de éxito

«La aplicación funciona» no es un criterio de aceptación. Mejor son afirmaciones verificables: una recepción de mercancías de 30 posiciones se puede contabilizar en diez minutos. Las etiquetas de envío se imprimen en el puesto previsto. Los cambios de existencias aparecen de inmediato en la planificación. Una cuenta de usuario bloqueada solo puede reactivarse mediante el proceso de aprobación definido.

Tales criterios conectan el área funcional y el desarrollo. También evitan que la aceptación se convierta en una colección de impresiones vagas. No toda respuesta tiene que resolverse antes del go-live. Pero cada respuesta necesita una clasificación: error crítico, mejora relevante o punto para una fase de ampliación posterior.

Migración de datos: solo los datos limpios merecen confianza

Los datos antiguos suelen subestimarse. En las tablas hay números de artículo duplicados, unidades distintas, direcciones de clientes caducadas y existencias cuyo origen ya nadie sabe explicar. Quien asume estos datos sin comprobarlos traslada la antigua falta de claridad a un sistema nuevo - solo que con mejor interfaz.

Antes de la migración debería determinarse qué datos se necesitan realmente. A menudo tienen sentido artículos actuales, clientes activos, pedidos abiertos, proveedores relevantes y existencias iniciales comprobadas. Los registros históricos no tienen que pasar necesariamente por completo a la nueva aplicación. Puede bastar con archivarlos de forma legible si siguen siendo necesarios para justificantes o consultas.

Especialmente importante es una carga de prueba. Los datos no solo se importan técnicamente, sino que se comprueban funcionalmente: ¿coinciden cantidades, unidades y asignaciones? ¿Están completos los campos obligatorios? ¿Pueden procesarse correctamente pedidos típicos con ellos? Para el go-live se necesita después una fecha límite clara. ¿Desde cuándo se usa qué sistema principal? Sin esta regla surgen mantenimiento duplicado y existencias contradictorias.

Operación piloto en lugar de un gran interruptor

Un big bang puede tener sentido si un equipo pequeño utiliza un proceso claramente delimitado y la solución antigua y la nueva no pueden funcionar en paralelo. En la mayoría de los entornos operativos, sin embargo, una operación piloto es la opción más controlable.

El piloto debería trabajar con casos reales, pero en un marco limitado: una zona de almacén, un turno, un grupo de productos o un equipo seleccionado. Lo decisivo es que el grupo piloto no incluya solo a empleados especialmente aficionados a la tecnología. Debería representar de forma realista el día a día posterior, incluidas las personas que trabajan bajo presión de tiempo y tienen objeciones legítimas.

En la operación piloto se ve si escáneres, impresoras, red y permisos funcionan en el puesto de trabajo real. También se hacen visibles lagunas de proceso que nadie mencionó en las reuniones. Quizá en la práctica la mercancía se deja primero en un lugar intermedio. Quizá los conductores necesitan un albarán distinto al de la administración. Tales hallazgos no son un retroceso. Son la razón para realizar el piloto antes del arranque generalizado.

La formación como situación de trabajo, no como visita guiada del software

Una formación que solo explica elementos de menú genera poca seguridad. Los empleados deben aprender con sus tareas: «Usted recibe una entrega dañada», «Usted prepara un pedido urgente», «Usted corrige una cantidad mal contabilizada». El contexto se queda porque corresponde al día a día laboral.

Las formaciones cortas cercanas al go-live suelen ser más eficaces que una cita larga semanas antes. También ayudan instrucciones de trabajo breves directamente en el puesto. No deberían explicar todo el sistema, sino mostrar las operaciones más frecuentes, responsabilidades claras y el camino en caso de incidencias.

Nombre además personas de contacto por área. Estas personas no tienen que resolver por sí mismas cada problema técnico. Pero deberían poder decidir si se trata de un error de manejo, una ambigüedad funcional o un error real del sistema. Eso protege al equipo del proyecto de avisos no estructurados y acelera la ayuda para el turno.

El go-live necesita un plan operativo

El día del go-live necesita más que una hora. Defina quién decide a nivel funcional, quién es responsable de los cambios técnicos y por qué canal se comunican las incidencias. En flujos críticos debería ser visible si las funciones centrales funcionan: inicio de sesión, permisos, captura de datos, interfaces, impresión y copia de seguridad.

También forma parte un plan de contingencia. Eso no significa volver por completo al viejo mundo ante el menor problema. Significa determinar de antemano qué incidencia justifica una parada, cómo se documentan los pedidos en caso necesario y cómo se vuelven a registrar después de forma limpia. Un formulario en papel durante pocas horas puede ser razonable. Una gestión paralela permanente sin fin no lo es.

Los detalles técnicos cuentan aquí: ¿se han creado los accesos a tiempo? ¿Funcionan correctamente los roles y las reglas de bloqueo de cuenta? ¿Están las impresoras de etiquetas conectadas a las plantillas correctas? ¿Existe una copia de seguridad probada de la base de datos? En aplicaciones desarrolladas a medida, despliegues documentados, versiones trazables y un camino claro para las correcciones son el estándar.

Las primeras semanas deciden la aceptación

Tras el inicio comienza la fase en la que una aplicación se convierte o bien en herramienta de trabajo o bien en un paso adicional detestado. Planifique por ello breves ciclos de retroalimentación diarios. ¿Qué errores se repiten? ¿Dónde surgen rodeos? ¿Qué campos se malinterpretan? ¿Qué análisis le falta realmente a un responsable?

No toda observación exige un cambio inmediato. Algunos problemas se resuelven con reglas de trabajo más precisas o una mejor formación. Otros muestran debilidades reales en el proceso o en la aplicación. El arte consiste en no confundir ambas cosas. Un sistema no debería complicar sin motivo procesos existentes que funcionan. Si una tabla bien mantenida sigue siendo la mejor solución para un caso especial raro, puede quedarse.

Mida el efecto con unos pocos indicadores concretos: tiempo de procesamiento por operación, número de consultas, contabilizaciones erróneas, reimpresiones, pedidos abiertos o discrepancias de inventario. Solo estos valores muestran si el despliegue mejora realmente la operativa - en lugar de limitarse a introducir nuevas pantallas.

Un buen despliegue, tras unas semanas, ya no se siente como un proyecto. Se convierte en una rutina de trabajo fiable: los datos correctos están donde se necesitan, las excepciones son trazables y los equipos tienen que perseguir menos la información por teléfono. Justo a eso debería apuntar la planificación - no a un día de lanzamiento espectacular, sino a un día a día más tranquilo y mejor controlable.

Enlace permanente →

Planificar el Multiplatform Application Development: primero el proceso, después la plataforma

Planificar el Multiplatform Application Development: primero el proceso, después la plataforma

Un jefe de almacén confirma una recepción de mercancías en el escáner de mano. La planificación comprueba la misma operación en el navegador. Un conductor necesita el estado de entrega en ruta en el smartphone. El Multiplatform application development suena en este momento a una cuestión técnica. En realidad, se trata primero de un flujo operativo: ¿qué trabajo debe realizarse en qué lugar, con qué fiabilidad y con qué dispositivo?

Para las pequeñas y medianas empresas, la respuesta correcta rara vez es: lo construimos todo de forma nativa para cada plataforma. Con más frecuencia es: definimos un proceso común, elegimos de forma selectiva las interfaces necesarias y evitamos la lógica duplicada. Eso no solo ahorra presupuesto de desarrollo. También evita que el almacén, la oficina y el servicio externo trabajen con estados de datos distintos.

Qué debe aportar el Multiplatform Application Development

El Multiplatform Application Development designa el desarrollo de una aplicación utilizable en varios entornos, por ejemplo en el navegador web, en iOS y Android o en sistemas de escritorio Windows. El término se reduce a menudo a la pregunta de si una única base de código puede generar varias aplicaciones. Eso es solo una parte de la decisión.

Para los sistemas operativos importa sobre todo si la aplicación funciona en su lugar de uso. Una zona de recepción puede necesitar una cámara para capturar códigos de barras, elementos de control grandes para los guantes y una reacción utilizable con cobertura WLAN inestable. La administración, en cambio, necesita tablas, filtros, conceptos de permisos y registros de cambios trazables. Un conductor necesita una vista reducida, no la misma interfaz que la planificación.

Una base técnica común puede conectar estos requisitos de forma sensata. Pero no debe llevar a atender cada plataforma como un mal compromiso. El mejor código compartido carece de valor si los empleados dan rodeos porque la aplicación no refleja su flujo de trabajo real.

Primero determinar el proceso, luego la plataforma

Antes de hablar de frameworks, los equipos deberían examinar una operación concreta de principio a fin. Tomemos una entrega: entra el pedido, se prepara la mercancía, se genera un albarán, se confirma la entrega y el estado se comunica a ventas o atención al cliente. ¿En qué punto surge hoy la ruptura de soporte? ¿Dónde se anota algo en papel, se teclea más tarde o se pregunta por teléfono?

Esta observación separa los requisitos reales de plataforma de las listas de deseos. Si solo dos empleados de la oficina usan una función, una interfaz web bien hecha suele bastar. Si diez personas en el suelo del almacén realizan contabilizaciones, una interfaz móvil adecuada para el escáner puede marcar la diferencia. Si un programa Windows existente debe trabajar con hardware especial, puede ser necesaria una integración de escritorio.

No toda función pertenece a todo dispositivo. Eso no es un defecto de una solución multiplataforma, sino señal de decisiones de producto limpias. Datos y reglas de negocio comunes no significan necesariamente pantallas idénticas.

Las tres preguntas que aclaran costes y beneficios

La primera pregunta es: ¿qué dispositivos están ya en uso y cuánto tiempo seguirán estándolo? Una empresa con terminales Windows gestionados tiene otros requisitos que un servicio externo con smartphones privados. La segunda es: ¿qué ocurre sin conexión de red? La capacidad offline aumenta considerablemente el esfuerzo, porque los datos deben guardarse localmente, sincronizarse más tarde y tratarse limpiamente en caso de conflicto. Tiene sentido si el proceso se detendría de otro modo - no como equipamiento estándar.

La tercera pregunta se refiere a las consecuencias de un fallo. ¿Puede un empleado registrar una contabilización más tarde, o depende de ello una etiqueta de envío, una existencia o una liberación de seguridad? Cuanto más crítica es la operación, más deben planificarse permisos, reglas de comprobación, repetibilidad y registro.

Una arquitectura que no se desmorona en la segunda plataforma

En una solución sostenible, la lógica de negocio no está dispersa en varias interfaces. Las comprobaciones de existencias, los cambios de estado, los rangos de numeración, los permisos y la generación de documentos necesitan una base central y probada. Navegador, aplicación móvil y cliente de escritorio acceden a ella mediante interfaces claramente definidas.

Para muchos procesos empresariales internos, una aplicación web moderna es el punto de partida más económico. Puede actualizarse de forma central, no necesita instalación en cada puesto y funciona en ordenador, tableta y smartphone. Con PHP 8.4, JavaScript moderno y MySQL 8 se puede construir una base mantenible, siempre que el modelo de datos, los derechos de acceso y el despliegue no se consideren solo poco antes de la puesta en marcha.

Una aplicación móvil o de escritorio instalable se añade cuando aporta una ventaja clara: integración profunda con escáner, impresora o cámara, funcionamiento offline fiable, funciones especiales en segundo plano o requisitos de la gestión de dispositivos. Es una ampliación dirigida, no un fin en sí mismo.

Un error frecuente es la reutilización completa de la interfaz de usuario a toda costa. Técnicamente puede parecer atractivo. En la práctica surgen textos pequeños en monitores grandes, formularios sobrecargados en smartphones o controles que no encajan con la plataforma. Es mejor compartir modelo de datos, reglas y componentes donde tenga sentido, mientras se adapta el manejo al contexto respectivo.

La coherencia de los datos importa más que una base de código común

Varias plataformas aumentan el riesgo de datos contradictorios. Un pedido se modifica en la oficina mientras un conductor aún ve una versión antigua en su dispositivo. Dos empleados contabilizan al mismo tiempo las mismas existencias de un artículo. Un dispositivo offline devuelve sus cambios horas después. Estos casos no son un tema marginal, sino el núcleo de la arquitectura.

El sistema necesita por ello identidades inequívocas, marcas de tiempo, cambios de estado trazables y reglas para los conflictos. Para un estado de entrega puede bastar el último cambio confirmado. Para las existencias suele ser demasiado tosco. Ahí debe estar claro qué movimiento se contabilizó, de qué ubicación procede y si una corrección debe justificarse.

También los permisos deben regularse de forma central. Un empleado puede, quizá, registrar recepciones de mercancías, pero no aprobar correcciones de existencias. Un conductor externo solo debe ver su ruta. Las duraciones de sesión, la autenticación multifactor para roles críticos y los flujos de bloqueo de cuenta no son funciones de seguridad decorativas. Protegen procesos concretos y hacen visibles las responsabilidades.

Probar el Multiplatform Application Development tal como se trabaja

Una aplicación puede arrancar en tres sistemas operativos y aun así fallar en la operativa. Lo decisivo son los flujos en condiciones reales: el escáner reacciona demasiado despacio, una impresora de etiquetas no es accesible, un permiso no se aplica tras un cambio de rol, o una sincronización genera contabilizaciones duplicadas.

Por eso deberían comprobarse automáticamente los procesos críticos. Entre ellos se cuentan el inicio de sesión y el comportamiento de bloqueo, la entrada de pedidos, los movimientos de existencias, la creación de documentos y el tratamiento de entradas erróneas. Para aplicaciones web y Windows, las pruebas recurrentes pueden ejecutarse en una infraestructura autoalojada. Esto es especialmente relevante si las capturas de pantalla, los datos internos de pedidos o los accesos de prueba no deben transmitirse a servicios cloud externos.

La automatización no sustituye la comprobación por personas en el suelo del almacén. Pero garantiza que los flujos conocidos se controlen una y otra vez tras los cambios. Los buenos informes de prueba no nombran solo un error técnico, sino el proceso afectado: no se puede generar el comprobante de entrega, la cuenta de usuario sigue bloqueada tras una aprobación correcta o los datos de ruta no se actualizan.

Cuándo una estrategia de plataforma es demasiado

Algunas empresas no necesitan una app propia. Si basta un acceso estable por navegador, el flujo rara vez es móvil y el número de usuarios sigue siendo manejable, una aplicación web responsiva suele ser la elección más razonable. Reduce el esfuerzo de mantenimiento, los problemas de distribución y el número de posibles fuentes de error.

Tampoco una tabla existente tiene que sustituirse de inmediato. Si solo sirve como evaluación sencilla, la mantiene una persona y no genera traspasos propensos a errores, puede cumplir su propósito. El momento para un sistema llega cuando el conocimiento está en cabezas individuales, las versiones divergen, las consultas aumentan o una operación ya no puede rastrearse de forma fiable.

A la inversa, una estrategia de plataforma ligera se queda pronto pequeña cuando los empleados deben trabajar offline, se conecta hardware o clientes y socios necesitan acceso controlado. Entonces merece la pena financiar conscientemente los requisitos adicionales, en lugar de añadirlos más tarde bajo presión de tiempo.

Empezar con un piloto sólido

Un buen comienzo no es un catálogo de funciones con cien puntos, sino un flujo completo y medible. Por ejemplo: registrar la recepción de mercancías, actualizar las existencias, documentar una desviación y crear una tarea de aclaración. Este piloto muestra pronto si modelo de datos, dispositivos, derechos y manejo encajan.

Después la solución puede crecer en pasos sensatos: picking, envío, planificación de rutas o análisis. Cada ampliación debería superar la misma pregunta: ¿acorta un flujo real, reduce errores o crea transparencia fiable? Si no, puede esperar.

La plataforma más sensata, al final, no es la que tiene más opciones técnicas. Es aquella en la que un equipo empieza su trabajo más rápido por la mañana, pregunta menos durante el turno y puede rastrear por la tarde qué ocurrió realmente.

Enlace permanente →

Evaluar correctamente los Test Automation Results

Evaluar correctamente los Test Automation Results

Una prueba de regresión puede terminar por la mañana con un 98 por ciento de casos exitosos y aun así no ser una buena noticia. Quizá la prueba fallida sea precisamente el inicio de sesión de un gran cliente. Quizá se omitieron 40 pruebas porque el entorno de pruebas no era accesible. O la ejecución salió en verde, pero solo comprobó si existen botones, no si un pedido se guarda realmente, se genera un albarán y las existencias se ajustan correctamente. Los Test automation results no son una afirmación sobre la calidad mientras falte su contexto.

Para la dirección de QA, el desarrollo y las áreas funcionales, el verdadero trabajo no consiste, por tanto, solo en automatizar pruebas. Lo decisivo es preparar los resultados de modo que de ellos surjan decisiones fiables: ¿se puede desplegar una versión? ¿Hay que tratar un error de inmediato? ¿Es el error nuevo, recurrente o solo un problema del entorno de pruebas? ¿Y existen evidencias que también pueda entender un área funcional sin código de pruebas?

Qué dicen realmente los Test Automation Results

El indicador más sencillo es: superado o fallido. Es útil, pero rara vez suficiente. Una tasa alta de éxito puede generar confianza si las pruebas cubren flujos críticos, los datos de prueba son plausibles y el entorno se parece a la operación posterior. Si falta uno de estos factores, la cifra sigue siendo sobre todo una señal de que se ejecutó un proceso automatizado.

En aplicaciones críticas para el negocio pesan más otras preguntas. En una solución de almacén, no todas las pantallas son igual de importantes. Un error de visualización en un texto de aviso interno puede esperar. Un error que contabiliza la cantidad equivocada en la recepción de mercancías o genera una etiqueta de envío sin dirección del destinatario, no. Los buenos resultados de pruebas ponderan, por tanto, los riesgos en lugar de tratar todos los casos por igual.

Una prueba fallida tampoco es automáticamente un defecto del producto. Puede deberse a credenciales caducadas, un rol de prueba bloqueado, interfaces no disponibles, datos de prueba modificados o un entorno lento. Quien no separa estas causas produce ruido. El equipo pierde entonces tiempo con falsas alarmas mientras los errores reales se pierden entre mensajes de estado en rojo.

Cuatro tipos de estado en lugar de una lista roja

En la práctica se ha demostrado útil una clasificación clara: error funcional, error técnico de la prueba, problema de entorno y cambio esperado. Un error funcional significa que la aplicación infringe un requisito definido. Un error técnico de la prueba apunta más bien a la propia prueba, por ejemplo un selector que ya no coincide tras una interfaz modificada deliberadamente.

Existe un problema de entorno cuando, por ejemplo, un sistema de pruebas o una interfaz conectada no está disponible. Los cambios esperados surgen cuando un proceso se ha adaptado deliberadamente, pero la automatización sigue comprobando el antiguo estado objetivo. Estas categorías no evitan toda discusión. Pero hacen que la discusión empiece en el punto correcto.

De las ejecuciones de pruebas a informes aptos para decidir

Un informe útil no responde solo que algo ha fallado, sino qué ha pasado, cuán grave es y si el error parece reproducible. Para ello hace falta más que una lista de nombres de pruebas y marcas de tiempo.

A cada ejecución relevante pertenecen la compilación comprobada, el entorno de pruebas, el rol utilizado, los datos de prueba centrales y la hora de inicio y fin. Especialmente con aplicaciones de escritorio Windows o plataformas web complejas, esta información es necesaria para acotar diferencias. Un error que solo aparece con un rol de almacén restringido es algo distinto de un error que bloquea cada inicio de sesión.

Los resultados con valor informativo contienen además evidencias trazables: capturas de pantalla, pasos grabados, mensajes de error y, si es necesario, registros técnicos. Una captura de pantalla por sí sola, sin embargo, puede engañar. Muestra un momento, no la causa. La combinación de secuencia de pasos, estado visible y reacción esperada es mucho más útil.

Los sistemas asistidos por IA pueden convertir estas evidencias en valoraciones comprensibles. Con COCO, por ejemplo, las pruebas se ejecutan en un servidor de IA propio y autoalojado. La evaluación puede explicar que un pedido se creó pero el cambio de estado esperado no se produjo, y asignar directamente la grabación de la ejecución. Para los equipos preocupados por la seguridad es relevante dónde se procesan las capturas de pantalla, los datos de la aplicación y el tráfico de pruebas. El control local no es automáticamente necesario, pero con aplicaciones internas y datos sensibles puede ser el camino más sensato frente a un servicio cloud externo.

El nivel de detalle adecuado para distintos destinatarios

Los equipos de desarrollo necesitan mensajes de error, pasos técnicos y pistas lo más precisas posible para la reproducción. Un responsable de operaciones, en cambio, necesita primero la función afectada, el riesgo para el negocio y una afirmación clara sobre la capacidad operativa. Ambas perspectivas deben poder surgir de la misma ejecución, sin que nadie tenga que trasladar resultados manualmente a presentaciones.

Un buen informe comienza, por tanto, con un breve nivel de decisión: lanzamiento recomendado, lanzamiento con limitaciones conocidas o detener el lanzamiento. Debajo figuran las desviaciones críticas con prioridad y evidencia. Los detalles técnicos siguen solo después. Eso no es una simplificación a costa de la precisión, sino una separación limpia de las necesidades de información.

Medir la cobertura sin engañarse con una falsa seguridad

La cobertura de pruebas se presenta a menudo como un valor porcentual. Este valor es útil cuando está claro qué mide. La cobertura de código muestra, por ejemplo, qué partes del código del programa se ejecutaron durante las pruebas. Eso no demuestra que un proceso de negocio funcione correctamente. Una prueba puede tocar muchas líneas de código y, aun así, no comprobar nunca si aparece una dirección de entrega errónea en el documento.

Para las áreas funcionales, la cobertura de procesos suele ser más reveladora. Describe qué flujos reales están protegidos: capturar un pedido, reservar existencias, contabilizar una entrega parcial, aceptar una devolución o aprobar una factura. Especialmente valiosos son los traspasos entre sistemas y roles, porque ahí suelen surgir errores: al importar un pedido, al imprimir una etiqueta o al pasar de la oficina al terminal de almacén.

No priorice según el número de pruebas posibles, sino según el impacto del daño y la frecuencia de cambios. Un proceso poco usado con alto riesgo financiero o legal merece a menudo una automatización antes que una vista usada con frecuencia pero inofensiva. A la inversa, un flujo estable y poco crítico puede seguir conformándose con una breve comprobación manual. No toda comprobación tiene que automatizarse solo porque sea automatizable.

Las pruebas inestables son un problema de calidad en sí mismas

Las pruebas que a veces pasan y a veces fallan sin ningún cambio reconocible en el producto suelen llamarse flaky. Dañan la confianza más rápido que una prueba permanentemente en rojo. En cuanto los equipos reinician por reflejo los resultados en rojo, la automatización pierde su función de aviso.

Las causas suelen ser concretas: esperas fijas, datos de prueba compartidos, accesos paralelos, procesamiento asíncrono o un entorno que no se restablece. Una breve pausa de tres segundos en la prueba puede ayudar por casualidad, pero no es una solución. Es mejor esperar a un estado verificable, hacer únicos los datos de prueba y aislar los procesos entre sí.

No toda inestabilidad puede evitarse por completo. Las interfaces externas pueden fluctuar y la infraestructura real sufre caídas. Entonces el informe debería indicar claramente si una prueba no pudo evaluarse por una dependencia externa. Una ejecución repetida puede ser útil para el diagnóstico, pero no debe hacer invisible el primer hallazgo.

Un proceso sensato después de cada ejecución de pruebas

Tras una ejecución automatizada, no todos los resultados deberían tratarse de inmediato por igual. Primero se revisan los errores bloqueantes y las pruebas críticas no evaluables. Después sigue la clasificación de las nuevas desviaciones frente a problemas conocidos y aceptados. Solo entonces una decisión de lanzamiento es sólida.

Son útiles los umbrales definidos, pero deben ajustarse al proceso. Por ejemplo, una prueba fallida en el flujo de pagos o de permisos puede desencadenar una parada inmediata. Ante una desviación puramente cosmética puede ser aceptable una excepción documentada. Tales reglas no deberían surgir solo bajo presión de tiempo antes de un lanzamiento.

Igual de importante es la retroalimentación: cada error en producción que las pruebas no detectaron es un motivo para comprobar si falta un escenario, una variante de datos de prueba o un punto de control. El objetivo no es acumular tantas pruebas como sea posible. Es construir, a partir de errores reales, una mejor protección de forma dirigida.

Los resultados de prueba más útiles, al final, no son los de la visión general más verde. Son aquellos con los que un responsable puede entender el lunes por la mañana qué se comprobó, qué riesgo permanece y qué acción es ahora razonable.

Enlace permanente →

Inventory Discrepancy Causes: motivos frecuentes de las discrepancias de inventario

Inventory Discrepancy Causes: motivos frecuentes de las discrepancias de inventario

El sistema indica 248 unidades en existencia, en la estantería hay 231. Estas 17 unidades parecen a primera vista un error de conteo. Pero justo ahí es donde a menudo empieza el análisis equivocado. Las inventory discrepancy causes rara vez son, en la práctica, un descuido aislado. La mayoría de las veces surgen donde la recepción de mercancías, el movimiento de almacén, la preparación de pedidos, y la contabilización se desvían en el tiempo o organizativamente.

Para una pequeña o mediana empresa, las discrepancias de inventario no son solo un tema para el inventario físico. Generan pedidos erróneos, entregas urgentes, existencias de seguridad innecesarias, y promesas de entrega que no se pueden cumplir. Quien separa las causas con claridad no tiene que introducir de inmediato un gran ERP. A menudo bastan reglas de contabilización más claras, dispositivos de captura adecuados, y un sistema que refleje los procesos de trabajo reales.

Inventory discrepancy causes: dónde surgen las diferencias

Una discrepancia de inventario es la diferencia entre la existencia teórica en el sistema principal y la existencia realmente presente. Decisiva aquí es la palabra "principal". Si en paralelo se mantienen un archivo Excel, una lista en papel, y un sistema de gestión de mercancías, existen prácticamente varias verdades. Entonces la diferencia no surgió solo en el almacén, sino que ya estaba integrada en la gestión de datos.

La contramedida eficaz depende, por tanto, del tipo de error. Un palé mal contado necesita una solución diferente a una entrega aceptada físicamente pero nunca contabilizada. Antes de reestructurar procesos, los equipos deberían evaluar las diferencias por artículo, ubicación, turno, tipo de movimiento, y momento. Solo este patrón muestra si se trata de un caso aislado o de un error de proceso recurrente.

1. Las recepciones de mercancías se contabilizan tarde o de forma incompleta

La recepción de mercancías es un punto de ruptura clásico. La mercancía llega por la mañana, se aparta para su inspección, y más tarde se traslada directamente a producción o a la estantería. La contabilización se hace por la tarde, al día siguiente, o nunca. Mientras la mercancía esté físicamente presente, la existencia del sistema parece demasiado baja. Si ya se ha consumido o enviado, los errores posteriores se vuelven más probables.

Especialmente propensas son las entregas parciales, los artículos sustitutos, y las entregas en exceso. Si en el albarán figura una cantidad, pero llega una cantidad distinta, nadie debería simplemente contabilizar el documento de forma "más o menos coincidente". La discrepancia debe permanecer visible como excepción, incluyendo motivo, persona responsable, y aprobación. De lo contrario, la desviación desaparece de la operación y solo resurge en el inventario físico.

2. Los movimientos de almacén ocurren sin transacción

Un artículo se coloca de la recepción de mercancías a la estantería alta, se traslada de un hueco a la zona de picking, o se reserva para un pedido. Físicamente, es un movimiento pequeño y rápido. En el sistema puede ser decisivo.

Si el personal reorganiza las ubicaciones solo por intuición, la existencia total quizá todavía sea correcta, pero la disponibilidad en el lugar correcto no. Eso provoca tiempos de búsqueda, errores de picking, y viajes de reabastecimiento innecesarios. Una buena solución de almacén no tiene que complicar cada movimiento. Tiene que registrar los pocos movimientos relevantes para la disponibilidad, la trazabilidad, y el reabastecimiento.

En talleres o almacenes más pequeños, suele ser más sensato mantener pocas zonas inequívocas que una estructura de huecos teóricamente perfecta que nadie mantiene en el día a día. La precisión solo funciona si sigue siendo manejable.

3. El picking y el envío se contabilizan demasiado pronto

Muchos equipos contabilizan un pedido como "dado de baja" en el momento del picking, aunque la mercancía todavía esté en una zona de preparación. Si el pedido luego se modifica, se cancela, o se envía solo parcialmente, la existencia del sistema y la existencia física ya no coinciden.

Mejor es una separación clara entre reservado, preparado, y enviado. No todas las empresas necesitan cadenas de estado complejas para esto. Pero el momento de la reducción de existencias debe ser inequívoco. Para la mercancía de envío, suele estar más cerca de la entrega real al transportista que del primer gesto hacia la estantería.

Las devoluciones también pertenecen a este flujo. Cuando la mercancía vuelve, no está automáticamente disponible de nuevo. Solo la inspección, la decisión de calidad, y el almacenaje deberían determinar si vuelve a la existencia vendible, permanece bloqueada, o se da de baja.

4. Unidades erróneas y errores en los datos maestros

Una caja, un paquete, un rollo, y una pieza individual pueden referirse al mismo artículo. Si la conversión no se mantiene correctamente, surgen diferencias a una velocidad impresionante. Un empleado contabiliza "1", refiriéndose a una caja de 24 piezas. El sistema entiende una pieza.

Los errores en los datos maestros son especialmente insidiosos porque el proceso de contabilización puede parecer técnicamente correcto. Por eso, compruebe las unidades de embalaje, los factores de conversión, las cantidades mínimas, las ubicaciones, y los números de artículo. También se confunden fácilmente las variantes con nombres similares, por ejemplo diferentes longitudes, colores, o lotes.

Aquí no ayuda ninguna regla general como "escanear más". Los códigos de barras solo son tan fiables como la asociación que hay detrás. Para surtidos pequeños, un maestro de artículos bien mantenido con etiquetas bien legibles puede lograr más que un amplio pero mal configurado parque de escáneres.

5. Tablas paralelas y correcciones manuales

La tabla en el escritorio rara vez surge por negligencia. La mayoría de las veces cubre un vacío real: una reserva especial, un valor de evaluación faltante, o un proceso que el software existente no representa. Se vuelve problemática cuando se convierte en el segundo libro de existencias.

Entonces las entradas se contabilizan en el sistema, pero las salidas se anotan en la tabla. O una corrección solo se hace donde precisamente ayuda para el siguiente pedido. Nadie puede explicar después de forma fiable qué valor es el válido.

No toda tabla tiene que eliminarse. Un cálculo para planificación o análisis puede seguir siendo sensato. Sin embargo, las operaciones que modifican existencias deberían tener exactamente un sistema principal. Los ajustes necesitan un código de motivo, una marca temporal, e idealmente una persona que se pueda rastrear. Eso no es burocracia por sí misma, sino el requisito previo para análisis de causas sólidos.

6. Errores de conteo y métodos de inventario inadecuados

Incluso los procesos correctos no protegen contra errores humanos. Los artículos se cuentan dos veces, se pasan por alto palés, se estiman cajas abiertas, o no se bloquean ubicaciones mientras se cuenta. Un inventario completo anual descubre estos problemas tarde y bajo gran presión.

Para muchas empresas, un inventario cíclico es la alternativa más razonable. Los artículos de rotación rápida o de alto valor se comprueban más a menudo, los artículos C estables con menos frecuencia. Lo importante no es producir la mayor cantidad posible de conteos, sino comprobar las desviaciones con prontitud frente a los últimos movimientos. Si un artículo con discrepancia simplemente se corrige sin documentar la causa, el patrón permanece invisible.

Un contracontrol es especialmente sensato para valores altos, números de serie, o lotes. Para tornillos en un almacén de consumibles puede ser económicamente excesivo. La profundidad del control debería ajustarse al riesgo.

7. Responsabilidades poco claras entre turnos y áreas

Los errores de existencias surgen a menudo en las transferencias. El turno de mañana prepara la mercancía, el turno de tarde la envía. La recepción de mercancías acepta una entrega, mientras la planificación modifica el pedido en paralelo. Cada paso individual puede ser trazable, pero nadie es dueño de la operación completa.

Por eso, defina no solo roles, sino puntos de transferencia: ¿quién confirma la recepción de mercancías? ¿Cuándo cambia la responsabilidad de la mercancía preparada? ¿Quién revisa las excepciones abiertas al final del turno? Un tablero digital compartido o una simple lista de excepciones suele ser más eficaz que reuniones adicionales.

El sistema debería hacer visibles las operaciones abiertas, en lugar de obligar al personal a recordar. Por ejemplo, las entregas sin control de cantidad, los pickings sin finalización de envío, o las devoluciones sin decisión de calidad deben destacarse antes de convertirse en errores silenciosos de existencias.

8. Integración de sistemas débil y reglas de control faltantes

Si la tienda, la gestión de pedidos, el almacén, y la contabilidad intercambian datos con desfase temporal o por archivo, pueden surgir contabilizaciones duplicadas o faltantes. Una importación se ejecuta dos veces. Una interfaz falla silenciosamente. Un pedido se modifica después de que su estado de envío ya se haya transferido.

La solución no es necesariamente una sustitución completa. A menudo se necesitan interfaces claramente definidas, números de documento inequívocos, y controles técnicos. Una contabilización de almacén debería guardar de forma trazable cuándo ocurrió, de qué operación proviene, y si se canceló posteriormente. Los procesos críticos necesitan mensajes de error y colas, no solo una entrada silenciosa en el archivo de registro.

Con sistemas logísticos desarrollados a medida, tales reglas se pueden adaptar de forma específica a la operativa: ninguna cantidad negativa sin aprobación, ninguna confirmación de envío sin posición de envío, ningún procesamiento duplicado de la misma referencia externa. La mejor regla aquí no es la más estricta, sino aquella que detiene los errores reales sin bloquear la operativa ante excepciones normales.

Comprobar las discrepancias de inventario sistemáticamente

No empiece con una corrección generalizada. Elija los diez artículos con las diferencias más frecuentes o más costosas, y rastree su último movimiento hacia atrás: recepción de mercancías, traslado, picking, devolución, conteo, y cualquier ajuste manual. Si los casos se concentran en una ubicación, un turno, o un tipo de movimiento, ese es un punto de partida sólido.

Después, cada medida debería ser medible. Si se introducen nuevos escaneos de códigos de barras, observe no solo el número de escaneos, sino la tasa de discrepancia por grupo de artículos. Si se añade un nuevo estado para la preparación, compruebe diariamente las preparaciones abiertas. Los buenos procesos no producen una precisión aparente. Hacen visibles y trazables las excepciones de forma temprana.

El siguiente paso sensato suele ser pequeño: definir un punto de transferencia, limpiar una ubicación, o asegurar técnicamente una corrección manual recurrente. Las existencias fiables no surgen de más software por sospecha, sino de procesos que todavía se pueden ejecutar correctamente un martes ajetreado a las 16:45.

Enlace permanente →

Abordar correctamente la automatización de procesos para pymes

Abordar correctamente la automatización de procesos para pymes

Falta un albarán porque los datos todavía están en un papel. Una recepción de mercancías se registra dos veces porque el almacén y la oficina trabajan con tablas distintas. Una aprobación se retrasa porque la persona responsable no contesta al teléfono en ese momento. Ese tipo de fricción rara vez cuesta mucho dinero de golpe. Pero a lo largo de semanas se acumulan consultas, tiempos de búsqueda, correcciones de errores, y esperas innecesarias. Justo ahí es donde tiene sentido la automatización de procesos para pymes.

No se trata de sustituir el mayor número posible de actividades por software. Una buena automatización hace que los flujos sean trazables, reduce las transferencias evitables, y da al personal tiempo para decisiones que requieren experiencia. Eso es especialmente decisivo en las pequeñas y medianas empresas: los equipos están cerca del negocio diario. Cuando un proceso se atasca, a menudo todo el turno lo nota de inmediato.

No automatizar cada proceso

El error más frecuente es empezar por la molestia más visible. Quizá moleste un archivo de Excel, quizá haga falta un nuevo panel de control. Ambas cosas pueden estar justificadas. Pero un caos digitalizado sigue siendo caos - solo que más rápido y con más datos.

Antes de una decisión técnica, el flujo debería describirse primero tal como ocurre realmente. No como debería figurar en el manual. ¿Quién inicia el proceso? ¿Qué información se necesita? ¿Dónde se transfiere algo manualmente? ¿Quién decide en las excepciones? ¿Y en qué reconoce el equipo que el proceso ha concluido?

Precisamente en el almacén o en la tramitación de pedidos, los puntos críticos suelen estar entre sistemas: un pedido llega por correo electrónico, se copia en una tabla, se coordina por teléfono, y más tarde se introduce en un software de envío. Cada transferencia aumenta la probabilidad de que las cantidades, fechas, o direcciones difieran.

La automatización merece especialmente la pena cuando un proceso ocurre con frecuencia, tiene reglas claras, y los errores provocan consecuencias notables. Eso puede ser la recepción de mercancías, la creación de albaranes, la asignación de movimientos de almacén, o la entrega de pedidos aprobados al envío. Los casos especiales poco frecuentes con muchas decisiones discrecionales, en cambio, suelen ser mejor gestionados manualmente - al menos al principio.

La automatización de procesos para pymes empieza con prioridades

No toda actividad innecesaria merece de inmediato un proyecto. Una priorización sencilla aporta claridad. Evalúe los distintos flujos según frecuencia, tiempo de procesamiento, costes de error, y dependencias. Un proceso que ocurre cincuenta veces al día y ahorra solo dos minutos cada vez puede ser más rentable que un complicado proceso mensual.

La pregunta sobre la consecuencia del error es al menos igual de importante. Un documento interno impreso incorrectamente resulta molesto. Una asignación de lote errónea, una dirección de entrega perdida, o una recepción de mercancías sin documentar puede desencadenar reclamaciones, trabajo de búsqueda, y discrepancias de existencias. Ahí la automatización genera no solo velocidad, sino fiabilidad.

Un primer paso sensato suele ser lo bastante pequeño como para poder verificarse en pocas semanas. Por ejemplo, un empleado puede registrar mercancías mediante un código de barras, el sistema comprueba artículo y cantidad, actualiza las existencias en una base de datos central, y genera directamente un recibo de almacenaje si es necesario. El equipo no tiene después que adivinar qué versión de una tabla es la actual.

Un estado objetivo claro en lugar de una lista de funciones

Muchos proyectos comienzan con una larga lista de funciones deseadas. Mejor es una imagen operativa concreta: ¿qué debe ser visible al final de un proceso sin necesidad de preguntar? En el envío, eso podría significar que un pedido, tras su aprobación, reciba automáticamente una lista de picking, se compruebe la dirección de envío, y pueda generarse una etiqueta. Las excepciones aterrizan de forma visible en una lista de aclaración, en lugar de en una bandeja de correo inabarcable.

Esta imagen objetivo obliga a tomar decisiones útiles. ¿Tiene que procesarse cada pedido de forma completamente automática? ¿O deben los pedidos a partir de cierto valor de mercancía, con dirección de entrega divergente, o con existencias faltantes, someterse deliberadamente a revisión? La automatización no necesita un procesamiento a oscuras del cien por cien para generar un gran beneficio.

La técnica adecuada depende del flujo

No existe un camino técnico estándar para cada pyme. Una solución de tabla puede seguir siendo razonable para una evaluación manejable. Se adapta rápidamente, es familiar, y provoca poco esfuerzo de implantación. Sin embargo, en cuanto varias personas trabajan simultáneamente, las contabilizaciones deben ser trazables, o se intercambian datos con otros sistemas, alcanza sus límites.

Entonces suele ser más sensata una aplicación ligera y específica del flujo que una suite empresarial sobredimensionada. Puede representar exactamente los pasos necesarios en la operativa: registrar pedido, comprobar existencias, mover mercancía, generar documento, registrar envío, e informar del estado. Ni más, pero tampoco menos.

Técnicamente, importa menos si un sistema se anuncia con la última palabra de moda. Lo decisivo son fundamentos sólidos: una base de datos modelada limpiamente, permisos trazables, registros para cambios relevantes, interfaces fiables, y despliegues documentados. Una aplicación basada en PHP 8.4, JavaScript moderno, y MySQL 8 puede ser muy mantenible a largo plazo, si la arquitectura y la operativa se piensan desde el principio.

Las integraciones también merecen atención. Un intercambio automático de datos con la tienda, el ERP, el proveedor de envíos, o la contabilidad solo ahorra tiempo si los errores se tratan de forma visible. ¿Qué ocurre con una dirección inválida? ¿Se reintenta una impresión de etiqueta fallida? ¿Puede el equipo reconocer qué datos se han transferido y cuáles faltan todavía? Los errores silenciosos son más peligrosos que un caso excepcional claramente marcado.

Implantación durante la operativa en curso

Un nuevo sistema debe adaptarse a los cambios de turno, los plazos de entrega, y las rutinas de trabajo existentes. Por eso, una implantación gradual suele ser más segura que una fecha límite rígida para todas las áreas. Empiece con un proceso delimitado, un grupo de productos, o un área de almacén. Eso reduce el riesgo y genera retroalimentación real del día a día.

El funcionamiento en paralelo no es, por tanto, señal de inseguridad, sino una prueba controlada. Durante un tiempo limitado, se pueden comparar el registro antiguo y el nuevo. Las diferencias no solo muestran errores de software, sino a menudo también reglas que hasta ahora solo existían en la cabeza de empleados individuales. Esas reglas deben figurar de forma visible en el proceso - no permanecer de forma duradera en la experiencia personal.

El personal no debería enfrentarse al nuevo flujo solo en la formación. Quien ejecuta el proceso a diario reconoce pronto atajos, casos especiales, y pantallas poco prácticas. Un buen software respeta ese conocimiento, sin incorporar sin cambios cada excepción crecida históricamente. La pregunta correcta es: ¿qué excepción protege un caso de negocio importante, y cuál es solo una solución alternativa para un problema antiguo?

Hacer medible si el esfuerzo merece la pena

Antes del inicio deberían fijarse dos o tres indicadores. Pueden ser el tiempo de tramitación por pedido, el número de correcciones manuales, las discrepancias de existencias, o el tiempo hasta el envío. Sin un valor de partida, toda evaluación posterior se convierte en una mera impresión subjetiva.

No todo efecto se muestra de inmediato en euros. Cuando un equipo de almacén sabe en todo momento dónde se encuentra la mercancía, disminuye el número de interrupciones. Cuando los documentos de entrega surgen de los mismos datos que el pedido, disminuye el riesgo de información contradictoria. Y cuando las responsabilidades son visibles en el sistema, un proceso depende menos de personas individuales.

La automatización necesita mantenimiento y límites

Un flujo automatizado no es un proyecto que se congela tras la puesta en marcha. Las estructuras de artículos cambian, los clientes exigen nuevos documentos, los proveedores de envío adaptan sus interfaces. Por eso las responsabilidades, las actualizaciones, las copias de seguridad, y una gestión regulada de los permisos forman parte del sistema propiamente dicho.

Especialmente en aplicaciones con datos de clientes, pedidos, o existencias, debería estar claro quién obtiene acceso y por qué. Los roles deben ajustarse al día a día laboral: un equipo de almacén necesita funciones distintas a contabilidad o ventas. Los cambios registrados, los flujos de inicio de sesión seguros, y las restauraciones probadas resultan poco espectaculares. En caso de incidencia, son precisamente estos detalles los que deciden si la operativa puede seguir funcionando.

Las pruebas también forman parte de la seguridad operativa. Las verificaciones recurrentes de entrada de pedidos, contabilización de existencias, generación de documentos, y gestión de derechos evitan que un cambio en un punto dañe un flujo funcional en otro. Para aplicaciones web o de escritorio críticas, un entorno de pruebas autoalojado y controlado puede tener sentido si las capturas de pantalla, los datos de prueba, y los procesos internos no deben llegar a servicios cloud externos.

softify.pro acompaña este tipo de proyectos con un principio sencillo: primero comprender el flujo real, luego construir la solución mínima viable. A veces es una aplicación a medida. A veces basta con estructurar de forma más limpia una tabla existente y automatizar un único paso de transferencia.

El mejor siguiente paso no es, por tanto, una comparación de software, sino un recorrido por un proceso real - desde el desencadenante hasta la finalización. Tome un pedido, una recepción de mercancías, o una reclamación y sígalo con las personas implicadas. Allí donde se vuelve a introducir información, nadie conoce el estado, o las decisiones esperan innecesariamente, suele estar el enfoque más sensato para la automatización.

Enlace permanente →

Probar aplicaciones Windows: un plan práctico

Probar aplicaciones Windows: un plan práctico

Una aplicación Windows puede verse impecable en modo demo y aun así ralentizar la operativa el lunes por la mañana. Un albarán no guardado, un usuario bloqueado tras tres intentos fallidos, o un cuadro de diálogo de impresión que reacciona de forma distinta tras una actualización no son errores cosméticos. Quien quiera saber cómo probar aplicaciones Windows no debería, por tanto, empezar por botones individuales, sino por los flujos que cuestan trabajo, dinero, o trazabilidad.

Precisamente en almacén, taller, expedición, y administración, muchos procesos críticos se ejecutan a través de software de escritorio desarrollado a lo largo de los años. Ahí no importa si un caso de prueba está formulado de forma impresionante. Lo decisivo es si el personal puede realizar su trabajo de forma fiable en condiciones realistas - incluso con datos incompletos, permisos cambiantes, redes lentas, e interrupciones no planificadas.

Probar aplicaciones Windows empieza por los flujos críticos

No todas las funciones merecen el mismo esfuerzo de prueba. Una exportación poco usada con retrabajo manual debe evaluarse de forma distinta a la contabilización de una recepción de mercancías, la generación de una etiqueta, o la conciliación diaria de pedidos. Empiece por tanto con una pregunta sencilla: ¿qué ocurre concretamente si este flujo falla?

Tienen alta prioridad los procesos con impacto directo en existencias, entrega, facturación, seguridad, o comunicación con el cliente. Entre ellos se incluyen, por ejemplo, el inicio de sesión y la comprobación de permisos, la creación y modificación de datos maestros, las contabilizaciones de transacciones, la impresión de documentos, las interfaces con servicios ERP o de envío, así como las reanudaciones tras un error. Incluso las funciones usadas solo por un pequeño grupo de personas pueden ser críticas si bloquean un cierre mensual o la liberación de mercancía.

De estos flujos no surgen listas de pruebas abstractas, sino pasos de trabajo trazables. Una prueba de recepción de mercancías podría, por ejemplo, empezar con un pedido existente, registrar una entrega parcial, notificar una cantidad divergente, asignar una ubicación de almacén, y luego comprobar si existencias, registro de contabilizaciones, y documento impreso coinciden. Así prueba el efecto real del software, no solo campos de entrada individuales.

Crear una base de pruebas que refleje la operativa

Muchos errores solo se hacen visibles cuando el entorno de prueba se acerca a la realidad. Una aplicación a menudo se comporta de forma distinta con un tenant de prueba vacío que con varios años de datos de movimientos, artículos bloqueados, información obligatoria faltante, u operaciones ya abiertas.

Por tanto, configure los datos de prueba de forma deliberada. No necesita forzosamente una copia completa de producción. Es más sensato un conjunto de datos controlado con casos típicos, límite, y deliberadamente erróneos: artículos con distintas unidades de medida, clientes con condiciones especiales, pedidos con entregas parciales, usuarios con distintos roles, y operaciones ya en curso. Los datos personales deberían anonimizarse o sustituirse por datos de ejemplo realistas.

A la base de pruebas también pertenece el entorno técnico. Documente la versión de Windows, resolución, escalado, impresoras instaladas, unidades de red, versión de la base de datos, servicios conectados, y permisos. Suena árido, pero ahorra tiempo después. Si un error solo ocurre en puestos de trabajo con escalado al 125% o con un controlador de impresora concreto, eso debe ser reproducible.

No comprobar solo el caso ideal

El caso ideal demuestra sobre todo que la aplicación se construyó para el camino esperado. En la operativa, las situaciones difíciles surgen junto a él. ¿Qué ocurre si un usuario deja un campo obligatorio vacío, dispara la misma contabilización dos veces, o pierde la conexión durante el guardado? ¿Permanece coherente la operación? ¿Recibe la persona un mensaje comprensible? ¿Puede seguir trabajando con seguridad?

En las aplicaciones Windows, además, el manejo y el estado son especialmente relevantes. Las ventanas de diálogo pueden aparecer en segundo plano, los atajos de teclado pueden solaparse, los diálogos de selección de archivos pueden bloquear el flujo. Compruebe si el foco, los mensajes de error, y los bloqueos son inequívocos. Una excepción técnica sin indicación de qué hacer no ayuda al jefe de turno.

Usar pruebas manuales donde se requiere criterio

Las pruebas manuales no son señal de madurez insuficiente. Son imprescindibles cuando surge un flujo nuevo, se reconstruye una interfaz, o el conocimiento especializado determina la calidad. Un jefe de almacén experimentado reconoce más rápido que un script si una pantalla es comprensible bajo alta presión de tiempo, o si un aviso aparece demasiado tarde.

Sin embargo, la prueba manual se vuelve costosa y poco fiable cuando se repiten los mismos flujos estables antes de cada versión. Entonces el lanzamiento depende de personas disponibles, memoria, y notas dispersas. El momento adecuado para pasar a la automatización suele estar donde un proceso se ejecuta con frecuencia, puede causar un daño considerable, y tiene resultados esperados claros.

Un buen caso de prueba manual describe la situación de partida, los pasos, el resultado esperado, y los datos necesarios. Ante un error, añada una captura de pantalla, marca de tiempo, versión de la aplicación y de la build, así como la acción exacta. "La impresión no funciona" no es una descripción de error utilizable. "Tras cambiar la dirección de entrega, el cuadro de diálogo de impresión permanece abierto, el pedido 4711 no recibe un PDF, y no aparece ningún mensaje" sí lo es.

Pruebas de regresión automatizadas para riesgos recurrentes

La automatización no comprueba si un software es fundamentalmente bueno. Comprueba si flujos definidos que antes funcionaban siguen funcionando tras un cambio. Eso es especialmente valioso para software Windows cuyas interfaces, lógica de base de datos, e interfaces externas se siguen desarrollando durante años.

Empiece a pequeña escala. Elija primero de cinco a diez flujos críticos para el negocio que deban comprobarse en cada lanzamiento. Entre ellos pueden estar el inicio de sesión con un flujo de bloqueo de cuenta, la entrada de pedidos, la contabilización de almacén, la impresión de PDF o etiquetas, el cambio de rol, y una importación central. Solo cuando estas pruebas funcionan de forma fiable merece la pena ampliar a casos especiales.

En las aplicaciones de escritorio, las pruebas automatizadas suelen controlar elementos visibles de la interfaz: ventanas, campos de entrada, tablas, botones, y diálogos. Eso funciona, pero es más frágil que una prueba pura de interfaz. Pequeños cambios de diseño, ordenadores más lentos, o elementos con nombres ambiguos pueden romper las pruebas. Por eso desarrolladores, área de negocio, y responsables de pruebas deberían determinar conjuntamente qué elementos son direccionables de forma estable y qué pasos de comprobación se aseguran mejor a través de la base de datos, un registro, o una interfaz.

Una prueba sensata también comprueba algo más que si se pudo hacer clic en un botón. Controla la consecuencia funcional: ¿se guardó la contabilización? ¿Es correcta la existencia? ¿Se generó un documento? ¿No se creó ningún registro duplicado? Interacción visible y resultado verificable van de la mano.

Las evidencias forman parte del resultado de la prueba

Un estado verde por sí solo rara vez basta en aplicaciones críticas. Cuando una prueba falla, los equipos necesitan rápidamente una respuesta a tres preguntas: ¿cuál era la situación de partida? ¿En qué paso falló el flujo? ¿Qué mostraba la aplicación en ese momento?

Las capturas de pantalla, los registros de ejecución, y, en su caso, las grabaciones de pantalla hacen que los errores sean discutibles. Acortan considerablemente el traspaso entre operativa, QA, y desarrollo. Para empresas reguladas o preocupadas por la seguridad, son además una base sólida para rastrear aprobaciones y desviaciones.

En esto, la ubicación de almacenamiento no es un asunto secundario. Las ejecuciones de prueba pueden contener datos internos de clientes, listas de precios, información de pedidos, o vistas de pantalla. Quien automatice pruebas para aplicaciones Windows sensibles debería aclarar si esos datos pueden salir de su propia infraestructura. Un entorno autoalojado como COCO puede ser sensato aquí, porque la ejecución de pruebas, las evidencias, y la evaluación permanecen bajo su propio control. Si eso es necesario depende de los requisitos de protección de datos, la situación contractual, y la necesidad de protección - no todos los equipos necesitan la misma arquitectura para ello.

Integrar las pruebas en el proceso de lanzamiento

El mejor catálogo de pruebas pierde valor si solo se usa después de una puesta en producción precipitada. Defina un momento fijo: las regresiones centrales automatizadas se ejecutan antes de cada lanzamiento, la aceptación manual comprueba flujos nuevos o modificados, y las limitaciones conocidas se documentan abiertamente.

No todas las pruebas fallidas deben detener un lanzamiento. Un error en una vista de administración poco usada puede ser aceptable si existe una solución alternativa segura y el área afectada está claramente informada. Un error que contabiliza existencias incorrectamente o bloquea usuarios sin que se note debe tratarse de forma distinta. Esa decisión debería tomarse según el impacto en el negocio, no según el mero número de pruebas en rojo.

Mantenga las pruebas junto con la aplicación. Cuando un proceso cambia deliberadamente, actualice el caso de prueba, los datos de prueba, y el resultado esperado junto con el requisito. Las pruebas obsoletas generan ruido y acaban ignorándose. Unas pocas comprobaciones fiables valen más que cientos de flujos automatizados cuyos resultados ya nadie se toma en serio.

Al final, no se trata de simular cada entrada imaginable. Se trata de proteger el trabajo que tiene que volver a funcionar a la mañana siguiente. Empiece con un único proceso crítico, haga demostrable su resultado, y construya desde ahí.

Enlace permanente →

Ponte en contacto

¿Tienes un proyecto en mente, un flujo de trabajo que todavía funciona con hojas de cálculo y buena voluntad, o un atraso de pruebas que COCO podría quitarle de encima a tu equipo? Cuéntanoslo.

Enviar mensaje